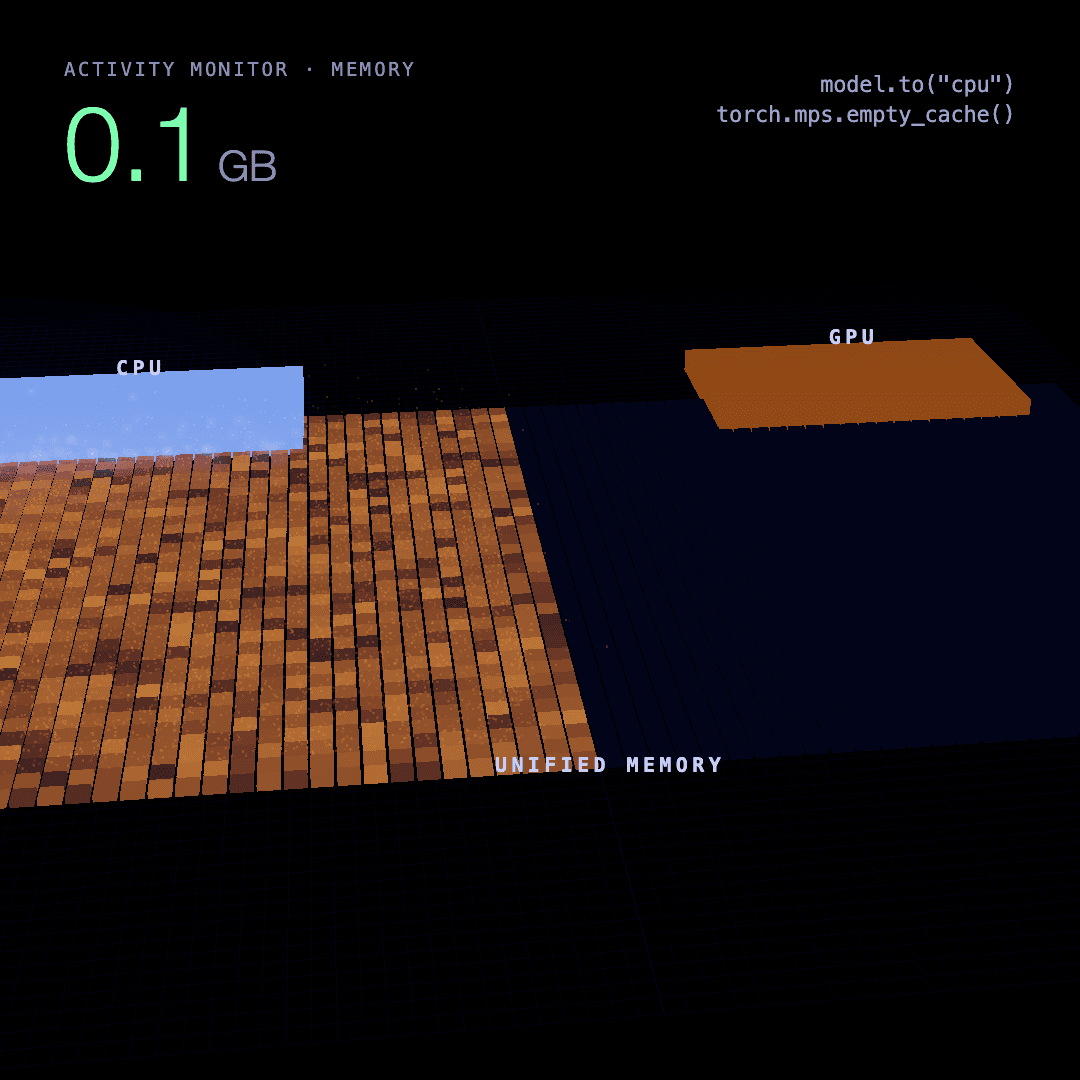
在 Mac 上,从 mps 移到 CPU 的张量看起来从内存里消失了。进程的 footprint,也就是活动监视器“内存”一栏里的数字,几乎降到零,MPS 驱动的计数也一样。可副本还在,仍然占着同样的内存。这是我为 diffusers 关于卸载的讨论 写的最小例子,用一个 4 GiB 的张量代替模型权重(torch 2.14.0、macOS 26.5.2、48 GB 的 M5 Pro):
import ctypes, os, time
import torch

# rusage_info_v2 from <libproc.h>; phys_footprint is the Memory column of Activity Monitor
FIELDS = ("user_time", "system_time", "pkg_idle_wkups", "interrupt_wkups", "pageins",
          "wired_size", "resident_size", "phys_footprint")
class RUsageInfoV2(ctypes.Structure):
    _fields_ = [("uuid", ctypes.c_uint8 * 16)] + [(f, ctypes.c_uint64) for f in FIELDS] \
        + [(f"rest{i}", ctypes.c_uint64) for i in range(10)]

libproc = ctypes.CDLL("/usr/lib/libproc.dylib")

def show(step):
    torch.mps.synchronize()
    info = RUsageInfoV2()
    libproc.proc_pid_rusage(os.getpid(), 2, ctypes.byref(info))
    print(f"{step:<14} footprint {info.phys_footprint / 2**30:4.1f} GiB, "
          f"mps driver {torch.mps.driver_allocated_memory() / 2**30:4.1f} GiB")

show("start")
w = torch.randn(2**30, device="mps")      # 4 GiB of float32, standing in for a model's weights
show("on mps")
w = w.to("cpu")                           # what model CPU offload does when a model's turn ends
torch.mps.empty_cache(); time.sleep(2)
show("moved to cpu")
float(w.sum())                            # read every page of the cpu copy
show("cpu copy read")
start footprint 0.1 GiB, mps driver 0.0 GiB
on mps footprint 4.2 GiB, mps driver 4.0 GiB
moved to cpu footprint 0.1 GiB, mps driver 0.0 GiB
cpu copy read footprint 4.2 GiB, mps driver 0.0 GiB我跑了三次,每次输出都一样。
这些数字说明了什么
刚移过去时,两个计数都回到接近零,但 w 里装着全部 4 GiB 的数值。CPU 一读完副本的每一页,footprint 又是 4.2 GiB。所以在 .to("cpu") 和 CPU 下一次碰这些权重之间测到的 footprint 看不到它们。
移动之所以什么也释放不了,根本在硬件。在 Apple Silicon 上,CPU 和 GPU 共用一个物理内存池。在 PC 上,把权重从 GPU 移到 CPU 会为下一个模型腾出显存。在 Mac 上,“在 CPU 上”的权重就躺在 GPU 需要的同一块 RAM 里。
为什么这对 model CPU offload 很重要
diffusers 的 enable_model_cpu_offload() 把每个模型放在 CPU 上,只在它运行时移到 GPU。我在同一台 Mac 上用这种方式以 1024 × 1024 跑了 Qwen-Image-2.1(跟踪记录和说明)。进程的 footprint 从没超过 18.5 GB,这在 48 GB 的 Mac 上绰绰有余。去噪期间交换空间增长了 3.5 GB,到 VAE 解码时已经增长了 9.6 GB,我的内存守卫在它写出图片之前停掉了这次运行。
只看 footprint 的图表会认为这次运行装得下。上面的例子说明了一种权重还在内存里、footprint 却保持很低的情况。offload 运行中哪些页进了交换空间,我没有测。
怎样检查自己的运行
看交换空间,而不只是 footprint:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
如果任务运行时交换空间在增长,那它就装不下,不管 footprint 怎么说。stageload(pip install stageload)是我为此写的一个小库,它用 MemoryMeter 每 0.5 秒把两者记进跟踪记录,stageload guard 会在交换空间增长超出预算时停掉命令:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py真正能释放内存的办法
对于一个接一个运行模型的管线,办法是在阶段开始时加载模型、阶段结束时释放它,而不是把它停放在 CPU 上。stageload 的 release(module) 把每个参数和缓冲区移到 PyTorch 的 meta 设备,回收垃圾并清空 MPS 缓存;meta 上的张量没有存储,所以即使别的代码还持有对模块的引用,内存也会还回来。用这种方式一次只加载文本编码器(16.3 GB)或 transformer(13.3 GB),Qwen-Image-2.1 在同一台 Mac 上的峰值是 19.0 GB,两次运行中交换空间都没有增长。完整设置见 如何在 48 GB 的 Mac 上不用交换空间运行 Qwen-Image-2.1。
我没有测的
- 例子运行期间整个系统的空闲内存:这台 Mac 上的其他任务在两次运行之间会让它变动好几 GiB,所以拿不到干净的数字。
del加torch.mps.empty_cache()是否能像移到meta一样完全地还回内存,以及有多快。- 其他 macOS 和 torch 版本,以及内存更大的 Mac。