Qwen-Image-2.1 在 diffusers 中通过 QwenImage21Pipeline 运行。在 bfloat16 下,它的文本编码器占 16.3 GB,transformer 占 13.3 GB,VAE 占 1.3 GB,所以在 48 GB 的 Mac 上,加载后的流水线达到 31.4 GB,而解码一张 1024 × 1024 的图像又让它高出 11 GB。本指南介绍常规写法在这台 Mac 上的表现、model CPU offload 为什么没有帮助,以及最终跑完的做法:两个大模型同一时间只有一个在内存里。
运行环境是 48 GB 的 Apple M5 Pro、torch 2.14.0 和从 main 安装的 diffusers 0.41.0.dev0。QwenImage21Pipeline 也包含在 diffusers 0.41.0 正式版中,但我没有用正式版运行。每次运行都用 20 步、种子 7 生成一张 1024 × 1024 的图像,并在内存防护程序下进行:swap 一旦增长 8 GB,它就停止运行。
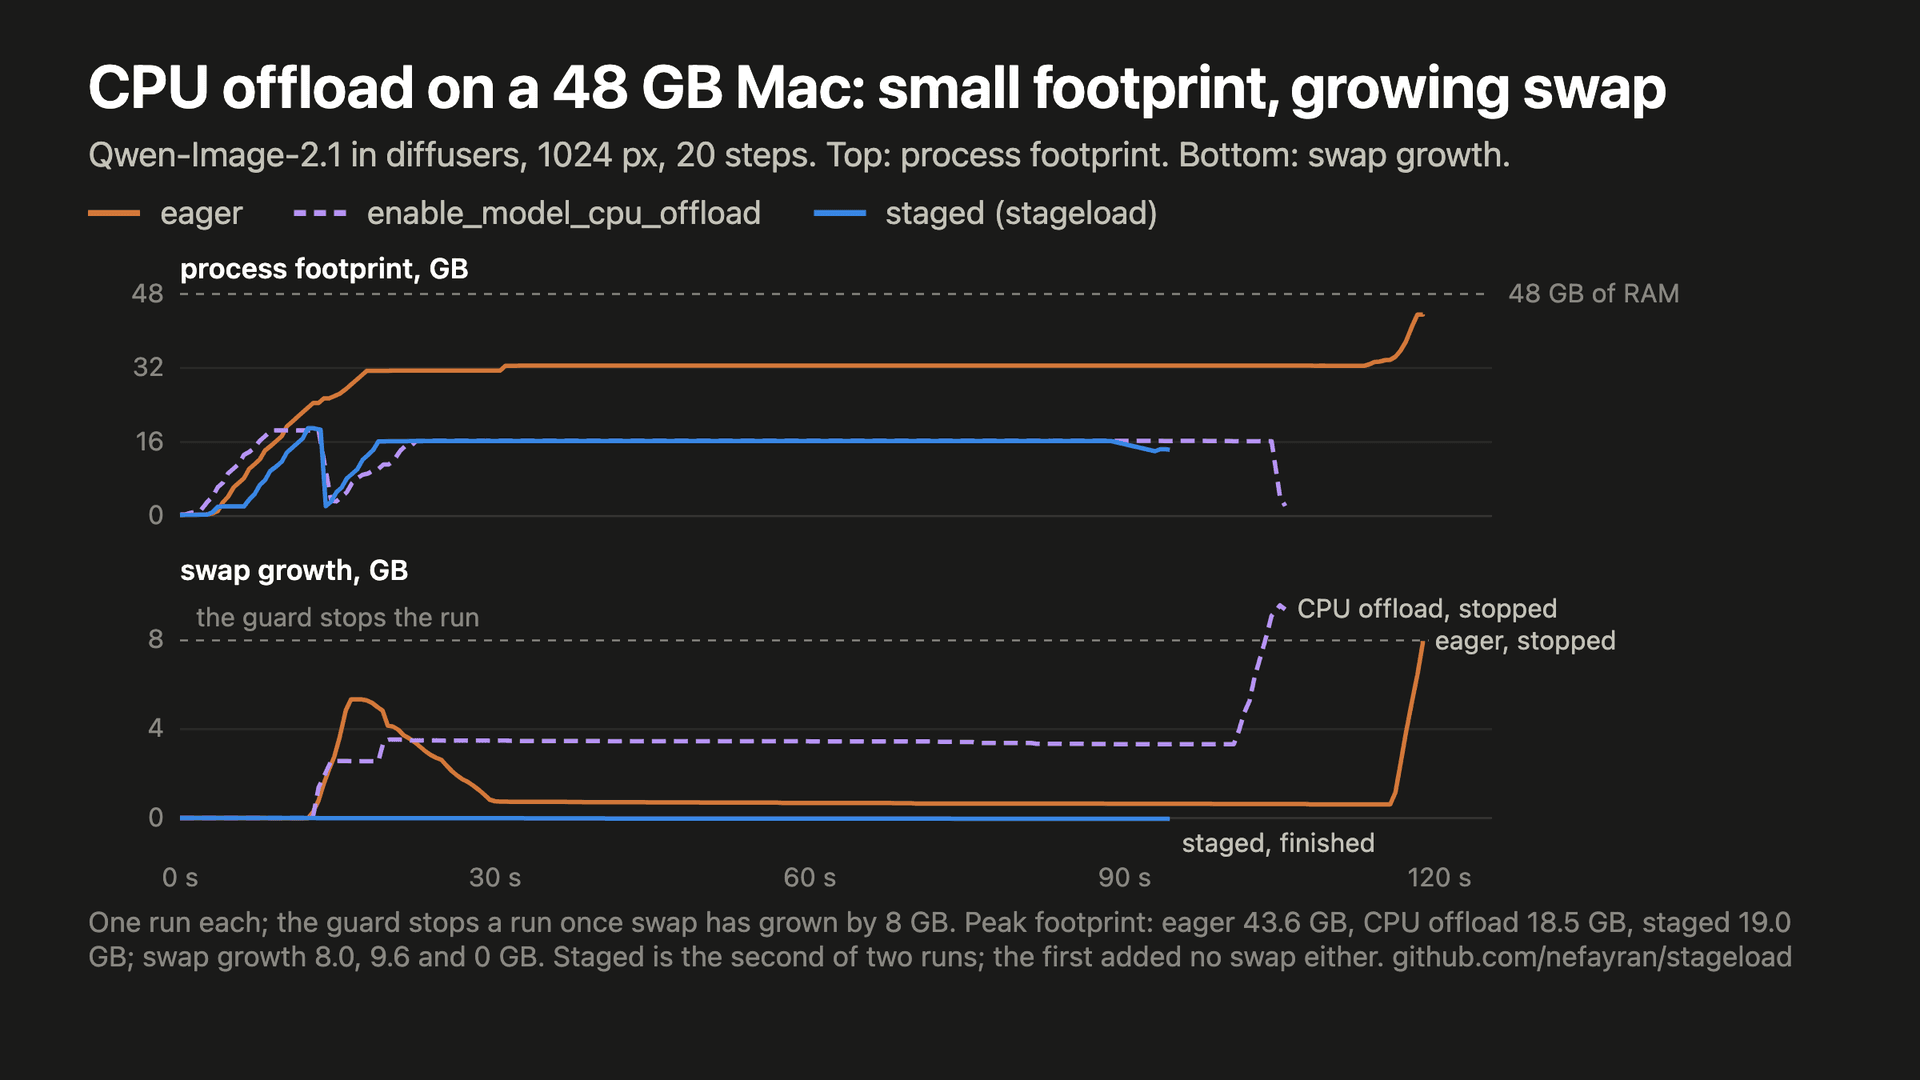
eager 在解码时进入 swap
常规代码把三个模型全部加载到 GPU 上,并一直留在那里:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("mps")
image = pipe(prompt=prompt, width=1024, height=1024, num_inference_steps=20).images[0]
它在 31 到 33 GB 之间完成了编码和全部 20 步去噪。随后 VAE 解码把 footprint 从 32.5 GB 推到 43.6 GB,swap 增长了 8 GB,防护程序在写出图像之前停止了运行。在此之前 PyTorch 没有报内存不足的错误,Mac 直接进入了 swap。
为什么 model CPU offload 在 Mac 上没有帮助
对于内存放不下的流水线,diffusers 内置的办法是 model CPU offload:每个模型在 CPU 上等待,只在运行时移到 GPU。
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.enable_model_cpu_offload(device="mps")
在 Mac 上,CPU 和 GPU 共用同一块内存,所以“在 CPU 上”等待的模型仍然占着同一块 RAM。在唯一一次 offload 运行中,进程 footprint 从未超过 18.5 GB,看起来放得下。但 swap 还是在增长:去噪期间增长 3.5 GB,VAE 解码时达到 9.6 GB,防护程序在停下 eager 的同一位置停止了运行。footprint,也就是活动监视器为进程显示的数字,不计入已经换出到 swap 的页,所以从它看不出这一点。
每个阶段只加载一个模型
流水线按顺序使用它的模型:文本编码器只用于编码提示词,transformer 只用于去噪循环,VAE 解码时两者都不用。所以两个大模型从来不需要同时在内存里。stageload 负责记录这件事:StagedModels 在某个阶段第一次需要某个模型时加载它,并在流水线进入不包含该模型的阶段时释放它。
from stageload import StagedModels, on_call

STAGES = {"encode": ["text_encoder"], "denoise": ["transformer"], "decode": []}
models = StagedModels({"text_encoder": text_encoder, "transformer": transformer}, stages=STAGES)

on_call(pipe, "encode_prompt", before=lambda *a, **k: models.enter("encode"))
on_call(pipe, "prepare_latents", before=lambda *a, **k: models.enter("denoise"))
on_call(pipe, "_unpack_latents", before=lambda *a, **k: models.enter("decode"))
text_encoder 和 transformer 是两个函数,分别用 from_pretrained(..., subfolder=...) 加载各自的模型并移到 mps。流水线本身用 text_encoder=None, transformer=None 和一直保持加载的 VAE 构建。on_call 在每个阶段开始的流水线方法之前调用 models.enter(stage),所以流水线的代码保持不变。还需要一处处理:流水线在去噪开始前会读取 transformer 的 config,因此 pipe.text_encoder 和 pipe.transformer 是替身,对 .config 用检查点中的配置回答,其他任何使用都会加载真正的模型。包含替身和内存跟踪的完整脚本在 bench/qwen_image.py,库用 pip install stageload 安装。
两次 staged 运行都跑完了,分别用时 94 秒和 124 秒。footprint 的峰值在编码时为 19.0 GB,两次运行的去噪阶段分别为 16.2 GB 和 18.6 GB,解码时为 14.4 GB。两次运行的 swap 都没有增长,空闲内存从未低于 51%。每次运行加载两个模型约用 13 秒,解码前释放 transformer 又用了 4 到 5 秒。从 transformer 进入内存算到解码开始,20 步在一次 staged 运行中用了 70 秒,另一次用了 99 秒,eager 为 77.5 秒;从跟踪数据看不出两次 staged 运行为何不同。两次生成的图像逐位相同。
检查一次运行是否用了 swap
不管 footprint 显示什么,只要运行期间 swap 没有增长,就说明放得下。两条命令就能看出来:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
stageload 的 MemoryMeter 每 0.5 秒把 footprint、swap 和空闲内存写入 JSONL 跟踪文件;stageload guard 在内存足够时启动命令,并在 swap 增长超过预算时停止它:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py我没有测量的内容
- VAE 分块解码(tiling)。
pipe.vae.enable_tiling()把图像分块解码,而 eager 和 offload 正是在解码时进入了 swap。我没有试过,所以无法判断它能否让 eager 在这台 Mac 上跑完。 - sequential CPU offload、量化权重,以及内存少于或多于 48 GB 的 Mac。
- staged 是否与 eager 生成相同的图像。eager 在这台 Mac 上从未写出过图像。
更详细的测量见 按阶段运行 Qwen-Image-2.1 和 在 48 GB 的 Mac 上用 model CPU offload,跟踪数据在 stageload 仓库 中。