stageload 的第二篇笔记在 48 GB 的 Mac 上用两种方式运行了 Qwen-Image-2.1。eager 在 VAE 解码时被内存防护程序停下,staged 跑完了。diffusers 还内置了第三种方式 enable_model_cpu_offload:每个模型都放在 CPU 上,只在运行时移到 GPU。10月8日,我用与10月6日那几次运行相同的提示词、尺寸、步数、种子和防护阈值运行了一次。
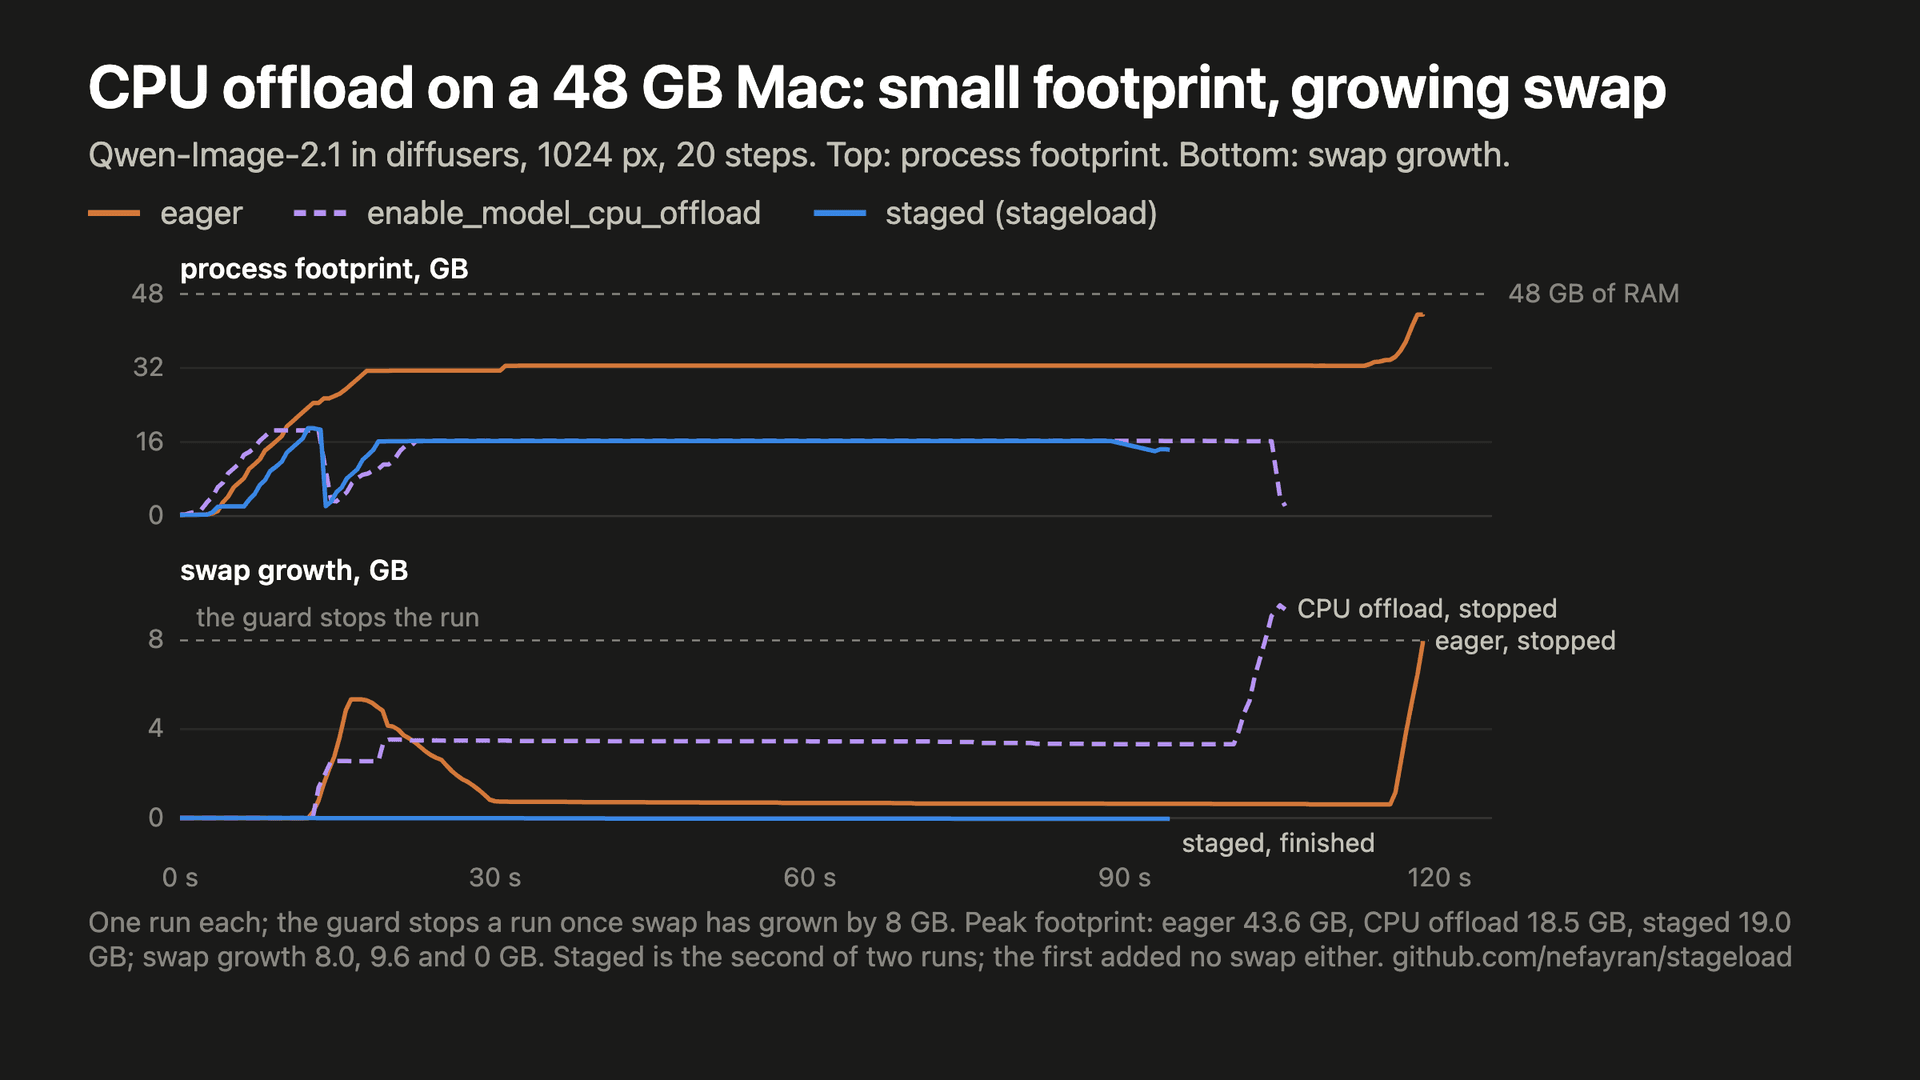
按进程 footprint 看,offload 和 staged 差不多:峰值 18.5 GB,staged 是 19.0 GB。区别在 swap 上。编码用了 8 秒,没有增加 swap。87 秒的去噪过程中,swap 增长了 3.5 GB,可用内存降到 27 %。VAE 解码把 swap 增长推到 9.6 GB,可用内存降到 22 %,防护程序在运行第 105 秒时把它停下,图片没有写出。staged 两次运行都没有增加 swap,分别用 94 秒和 124 秒跑完。
footprint 显示不出这一点,因为它不计入已经换出到 swap 的页面。Mac 上 CPU 和 GPU 共用一块内存,所以“放在 CPU 上”的模型和正在运行的模型占的是同一块 RAM。只看 footprint,offload 会排在 staged 旁边。看 swap,它排在 eager 旁边:eager 也是在同一个位置、新增 8 GB swap 之后被防护程序停下的。
我没能证明的
这只是一次运行。再跑一次,只会为了一个防护程序已经给出的结果,再把机器推进 swap。我没有测量哪些页面进了 swap,也没有在内存更大的 Mac 上试过 offload。
脚本在 bench/qwen_image_offload.py,trace 在仓库里。stageload 用 pip install stageload 安装。