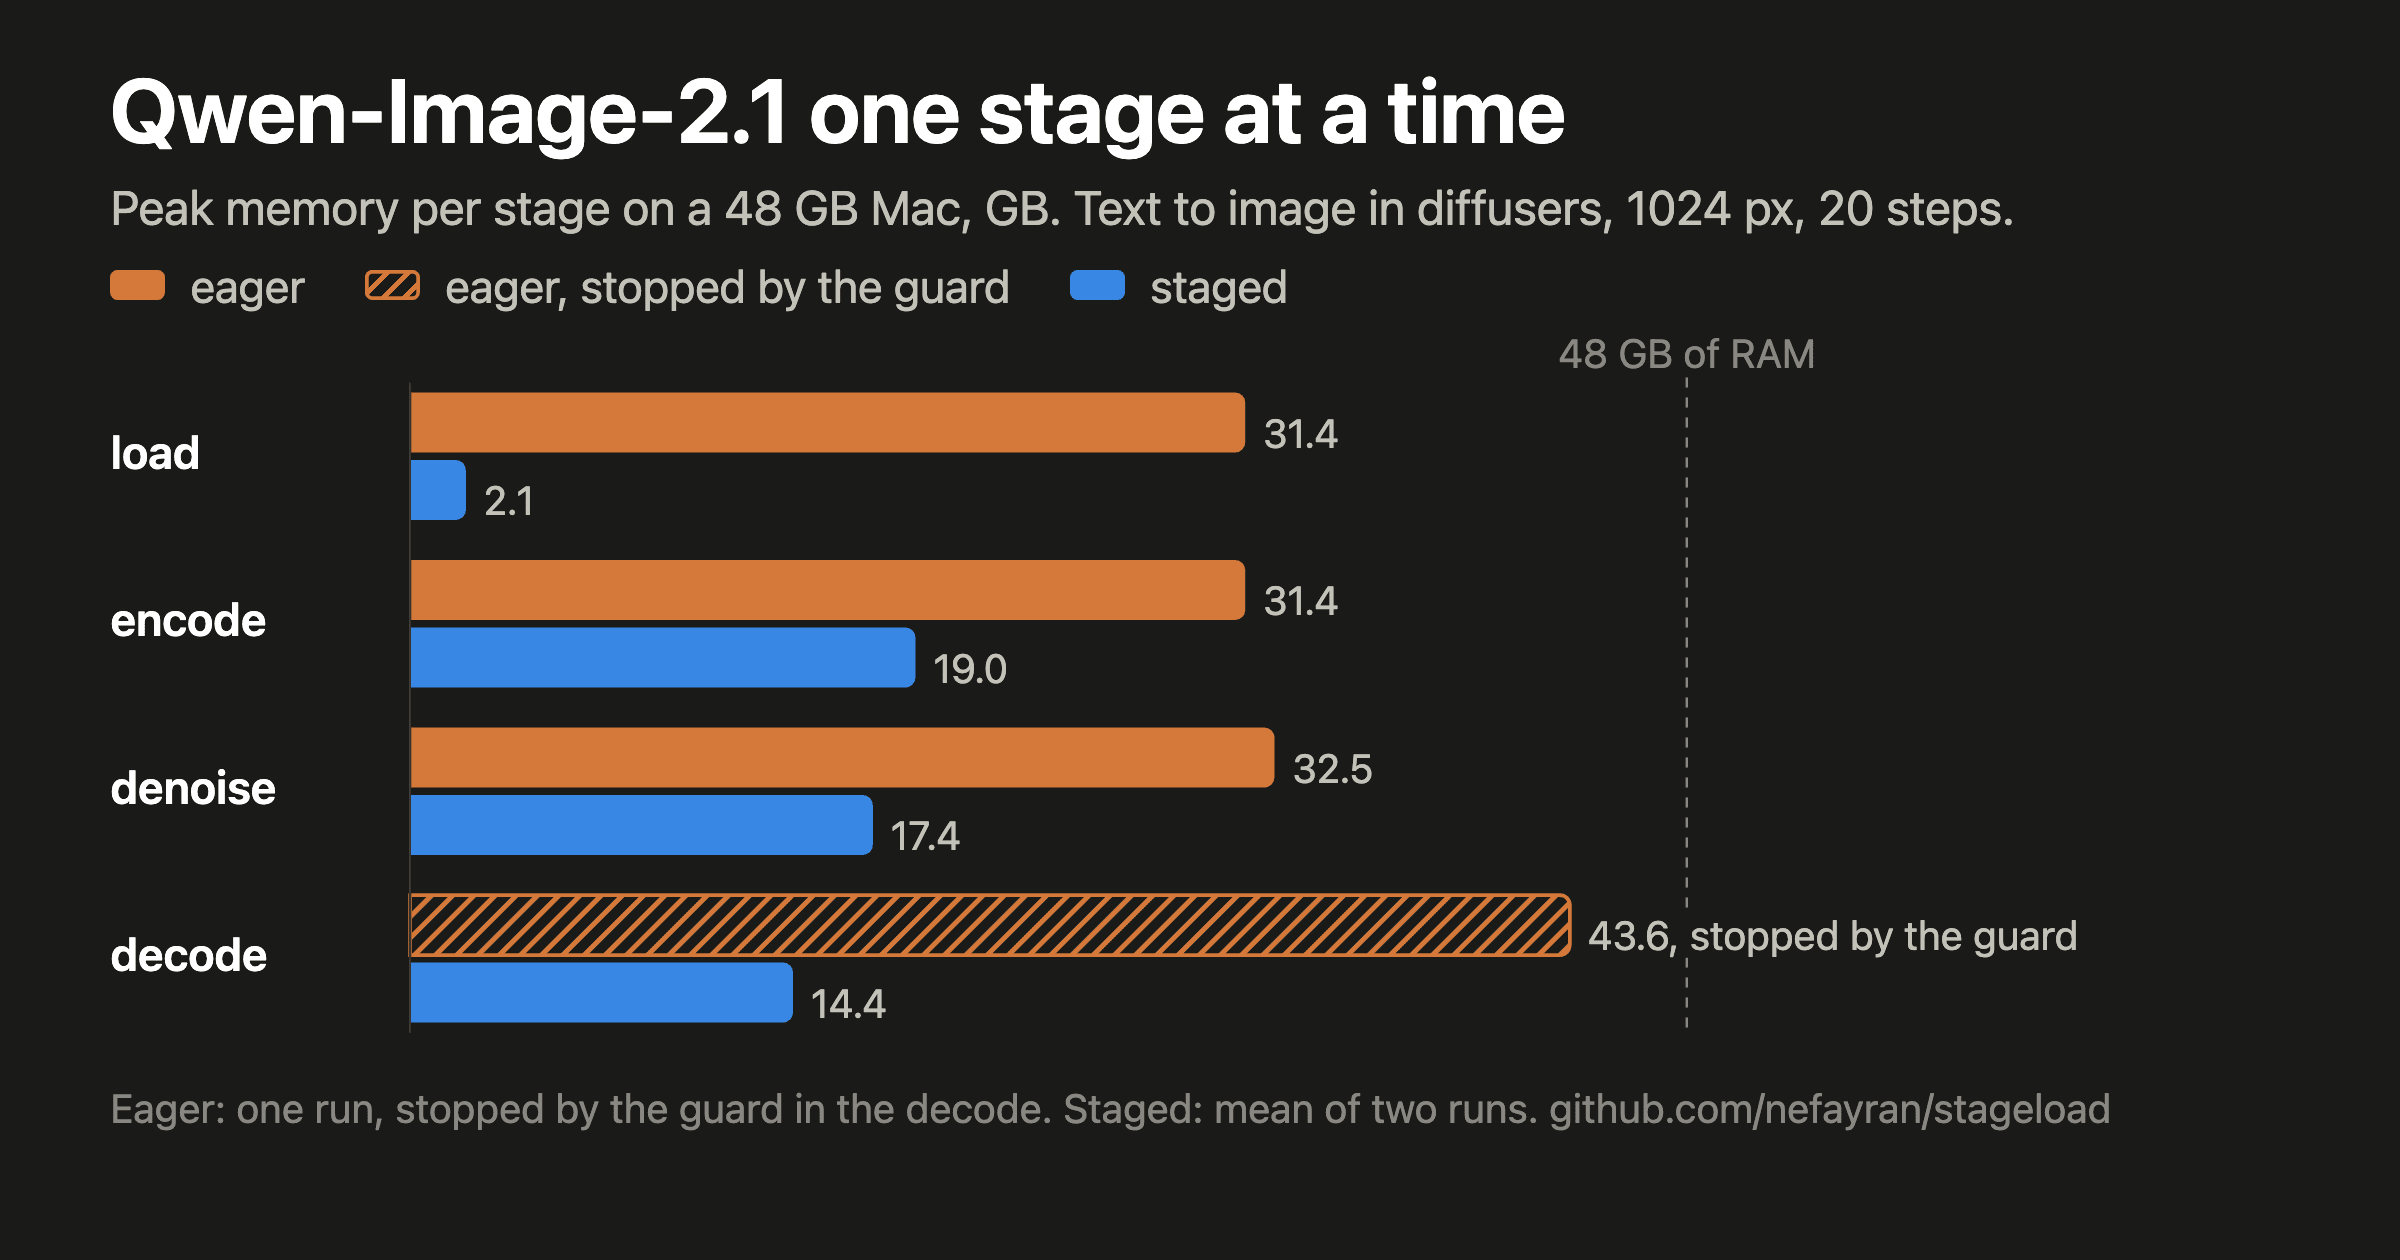
按阶段运行 Qwen-Image-2.1:stageload 的第二条流水线
在 48 GB 的 Mac 上用 stageload 加载 diffusers 里的一条文生图流水线:eager 在 VAE 解码时达到 43.6 GB,被内存防护程序停下;staged 不改流水线代码,峰值不超过 19.0 GB。
阅读笔记 →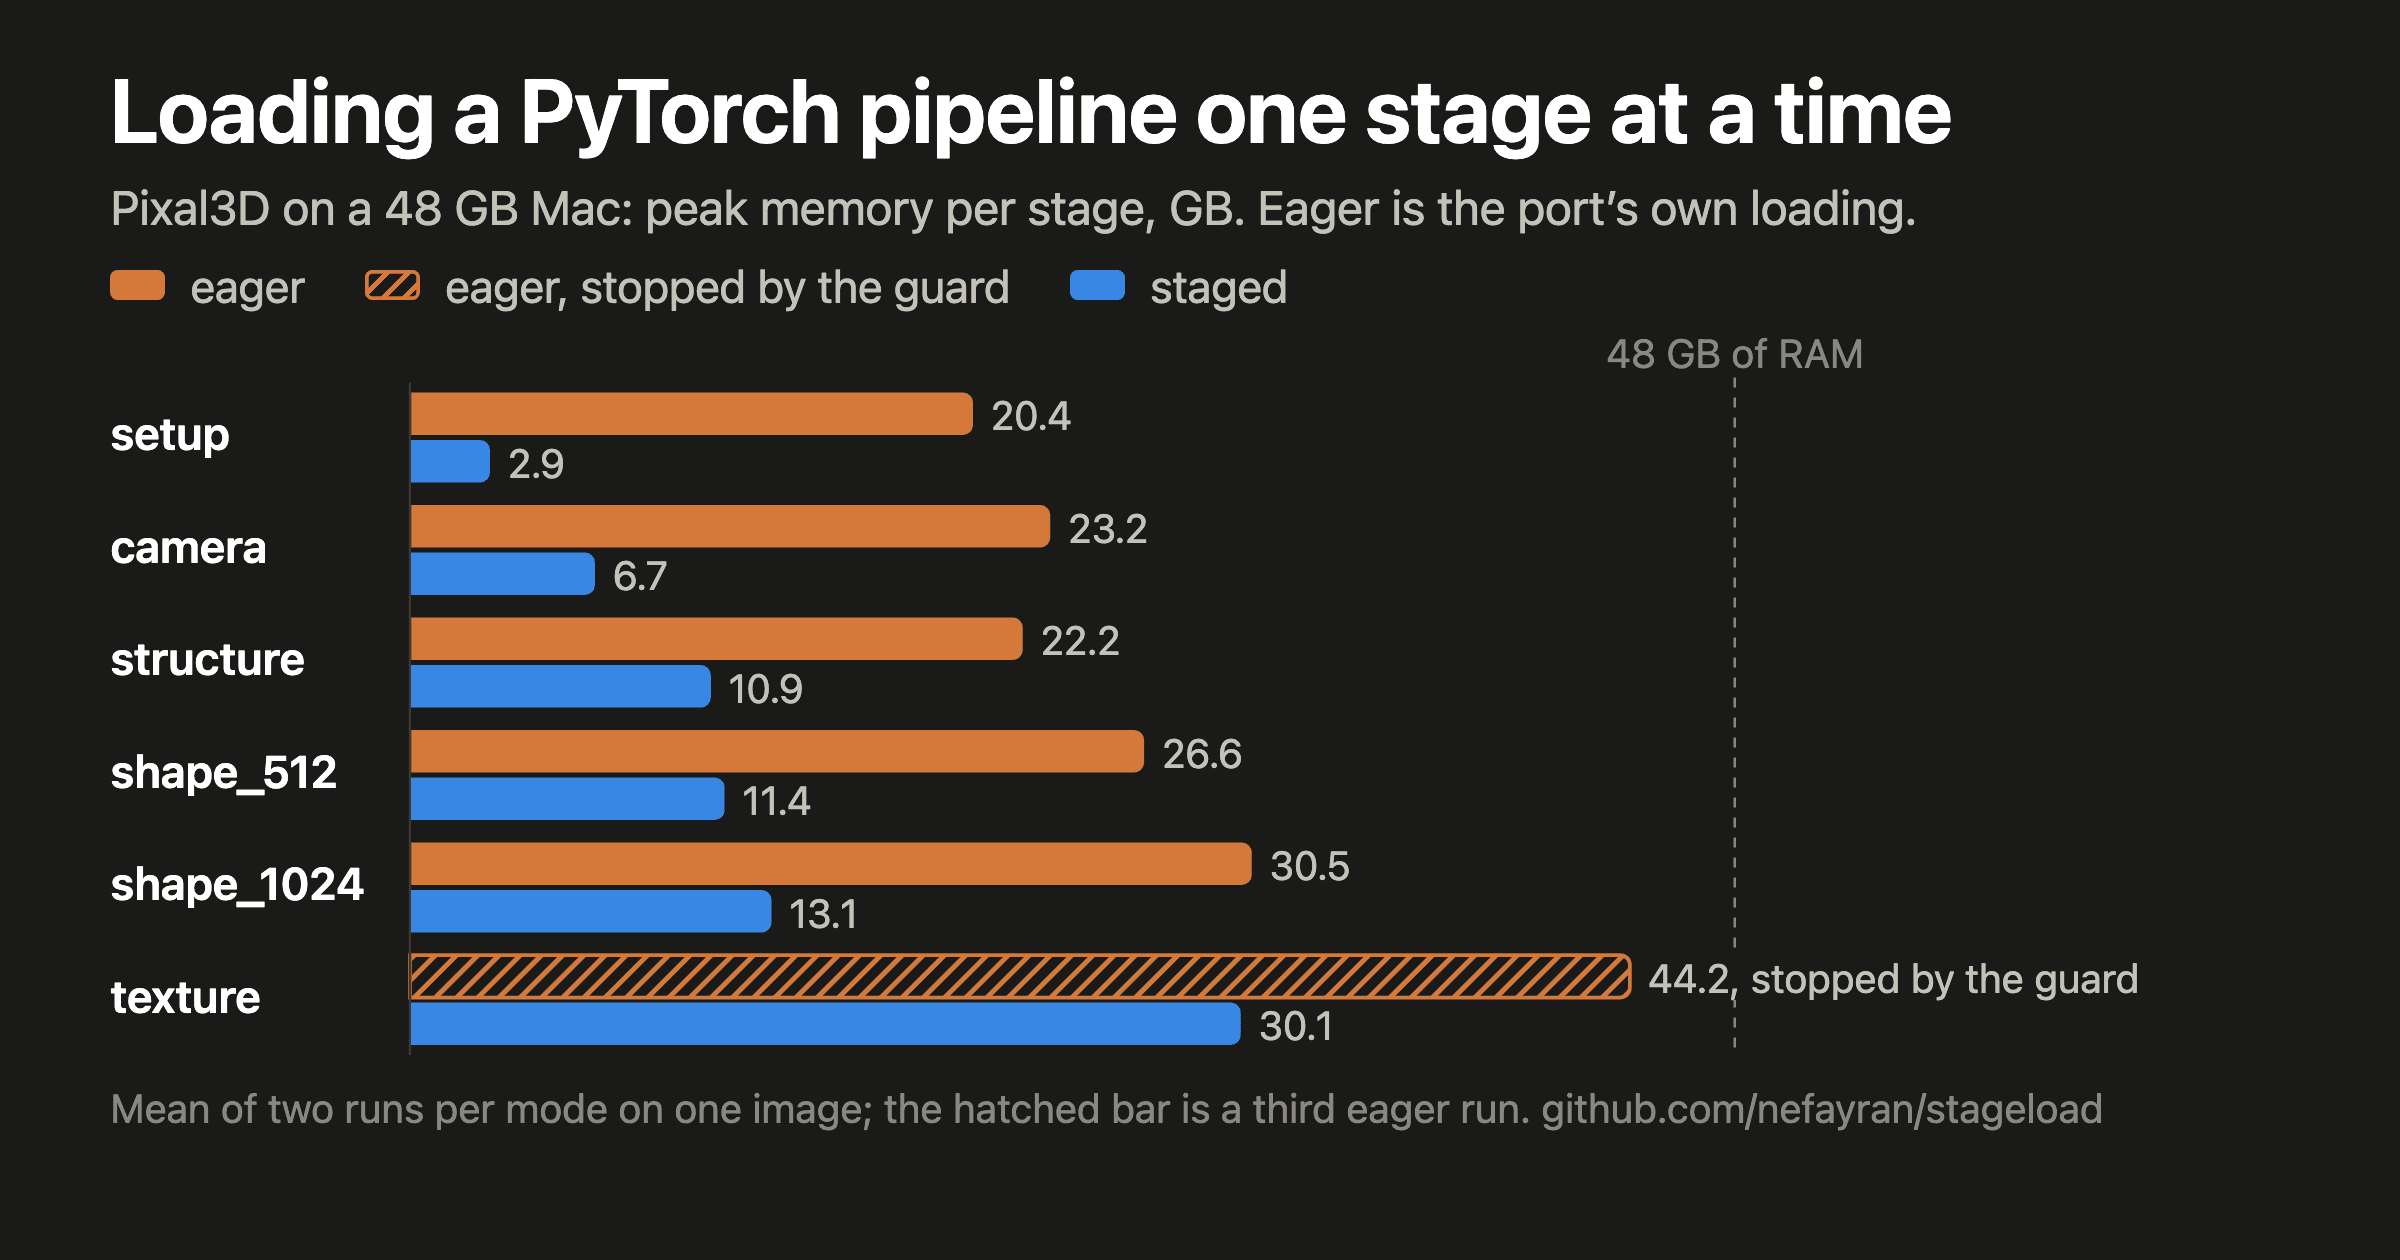
按阶段加载 PyTorch 流水线:在 48 GB 的 Mac 上运行 Pixal3D
stageload 适用于任何依次运行各个模型的 PyTorch 流水线:阶段开始时加载这个阶段需要的模型,阶段结束时释放它们。在 48 GB 的 Mac 上运行 Pixal3D-mac 时,在两种方式都到达的每个阶段,它都把峰值降低了 11 到 17 GB;而移植版自己的加载方式把机器推进了 swap,直到防护程序把它停下。
阅读笔记 →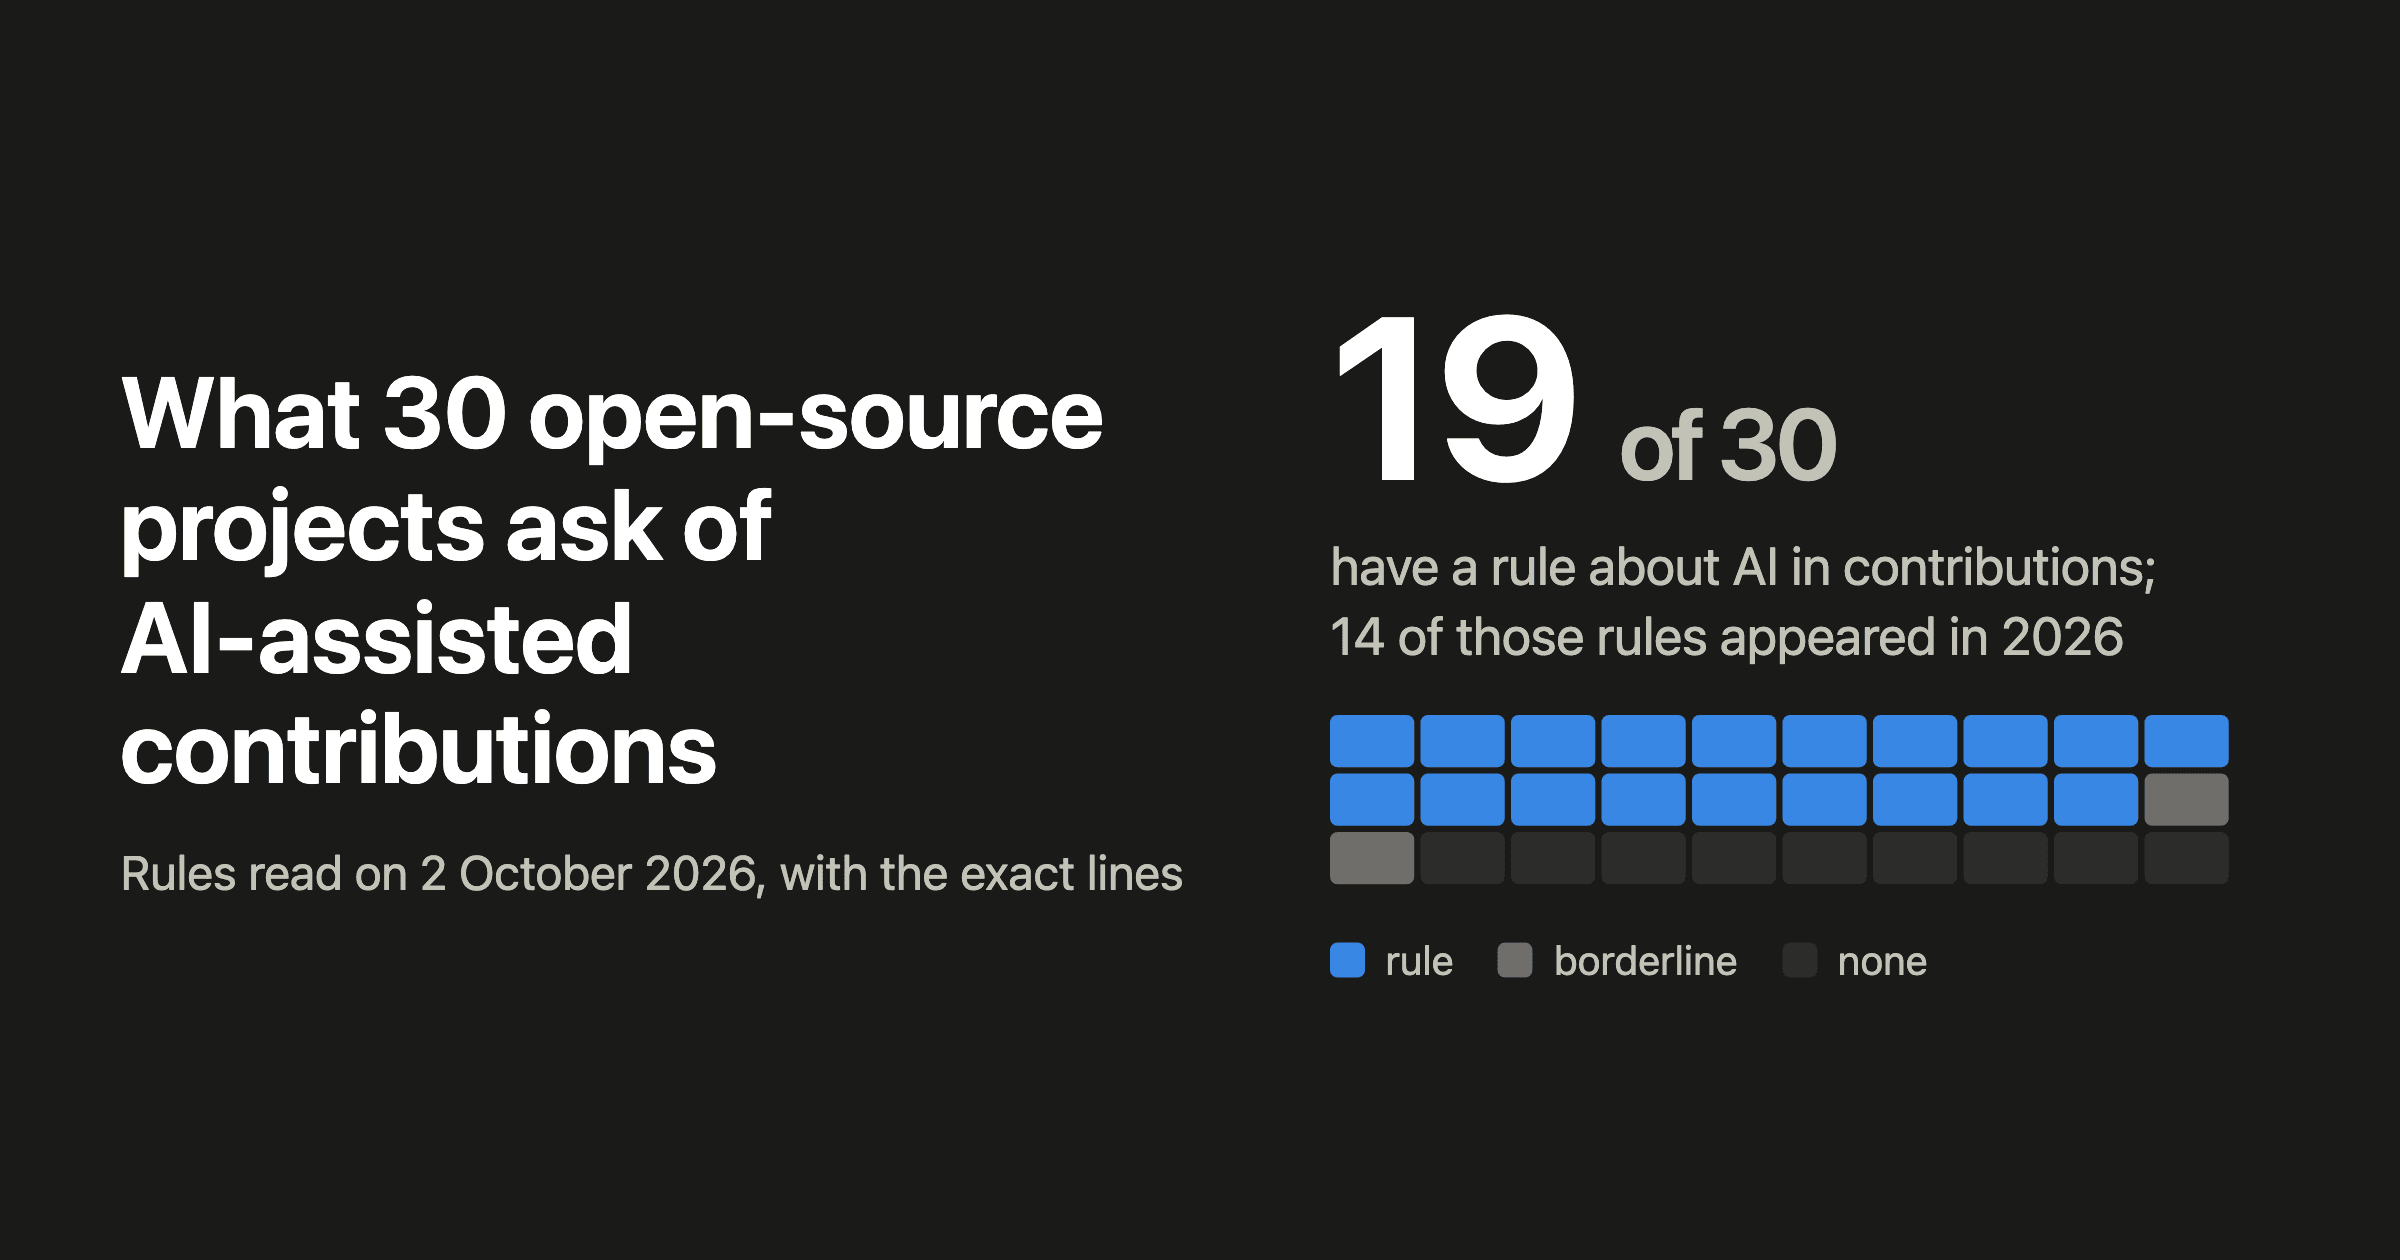
30 个开源项目对 AI 辅助的贡献有哪些要求
2026年10月2日,我读了 30 个开源仓库的贡献规则。其中 19 个有关于 AI 的规则,这些规则里有 14 条是2026年才出现的。十五个要求说明用了 AI,十个要求文字由人来写;编程智能体默认添加的提交尾注,有的项目要求加,有的项目禁止加。最后讲讲那一周我借助智能体发给十二个项目的工作后来怎样了。
阅读笔记 →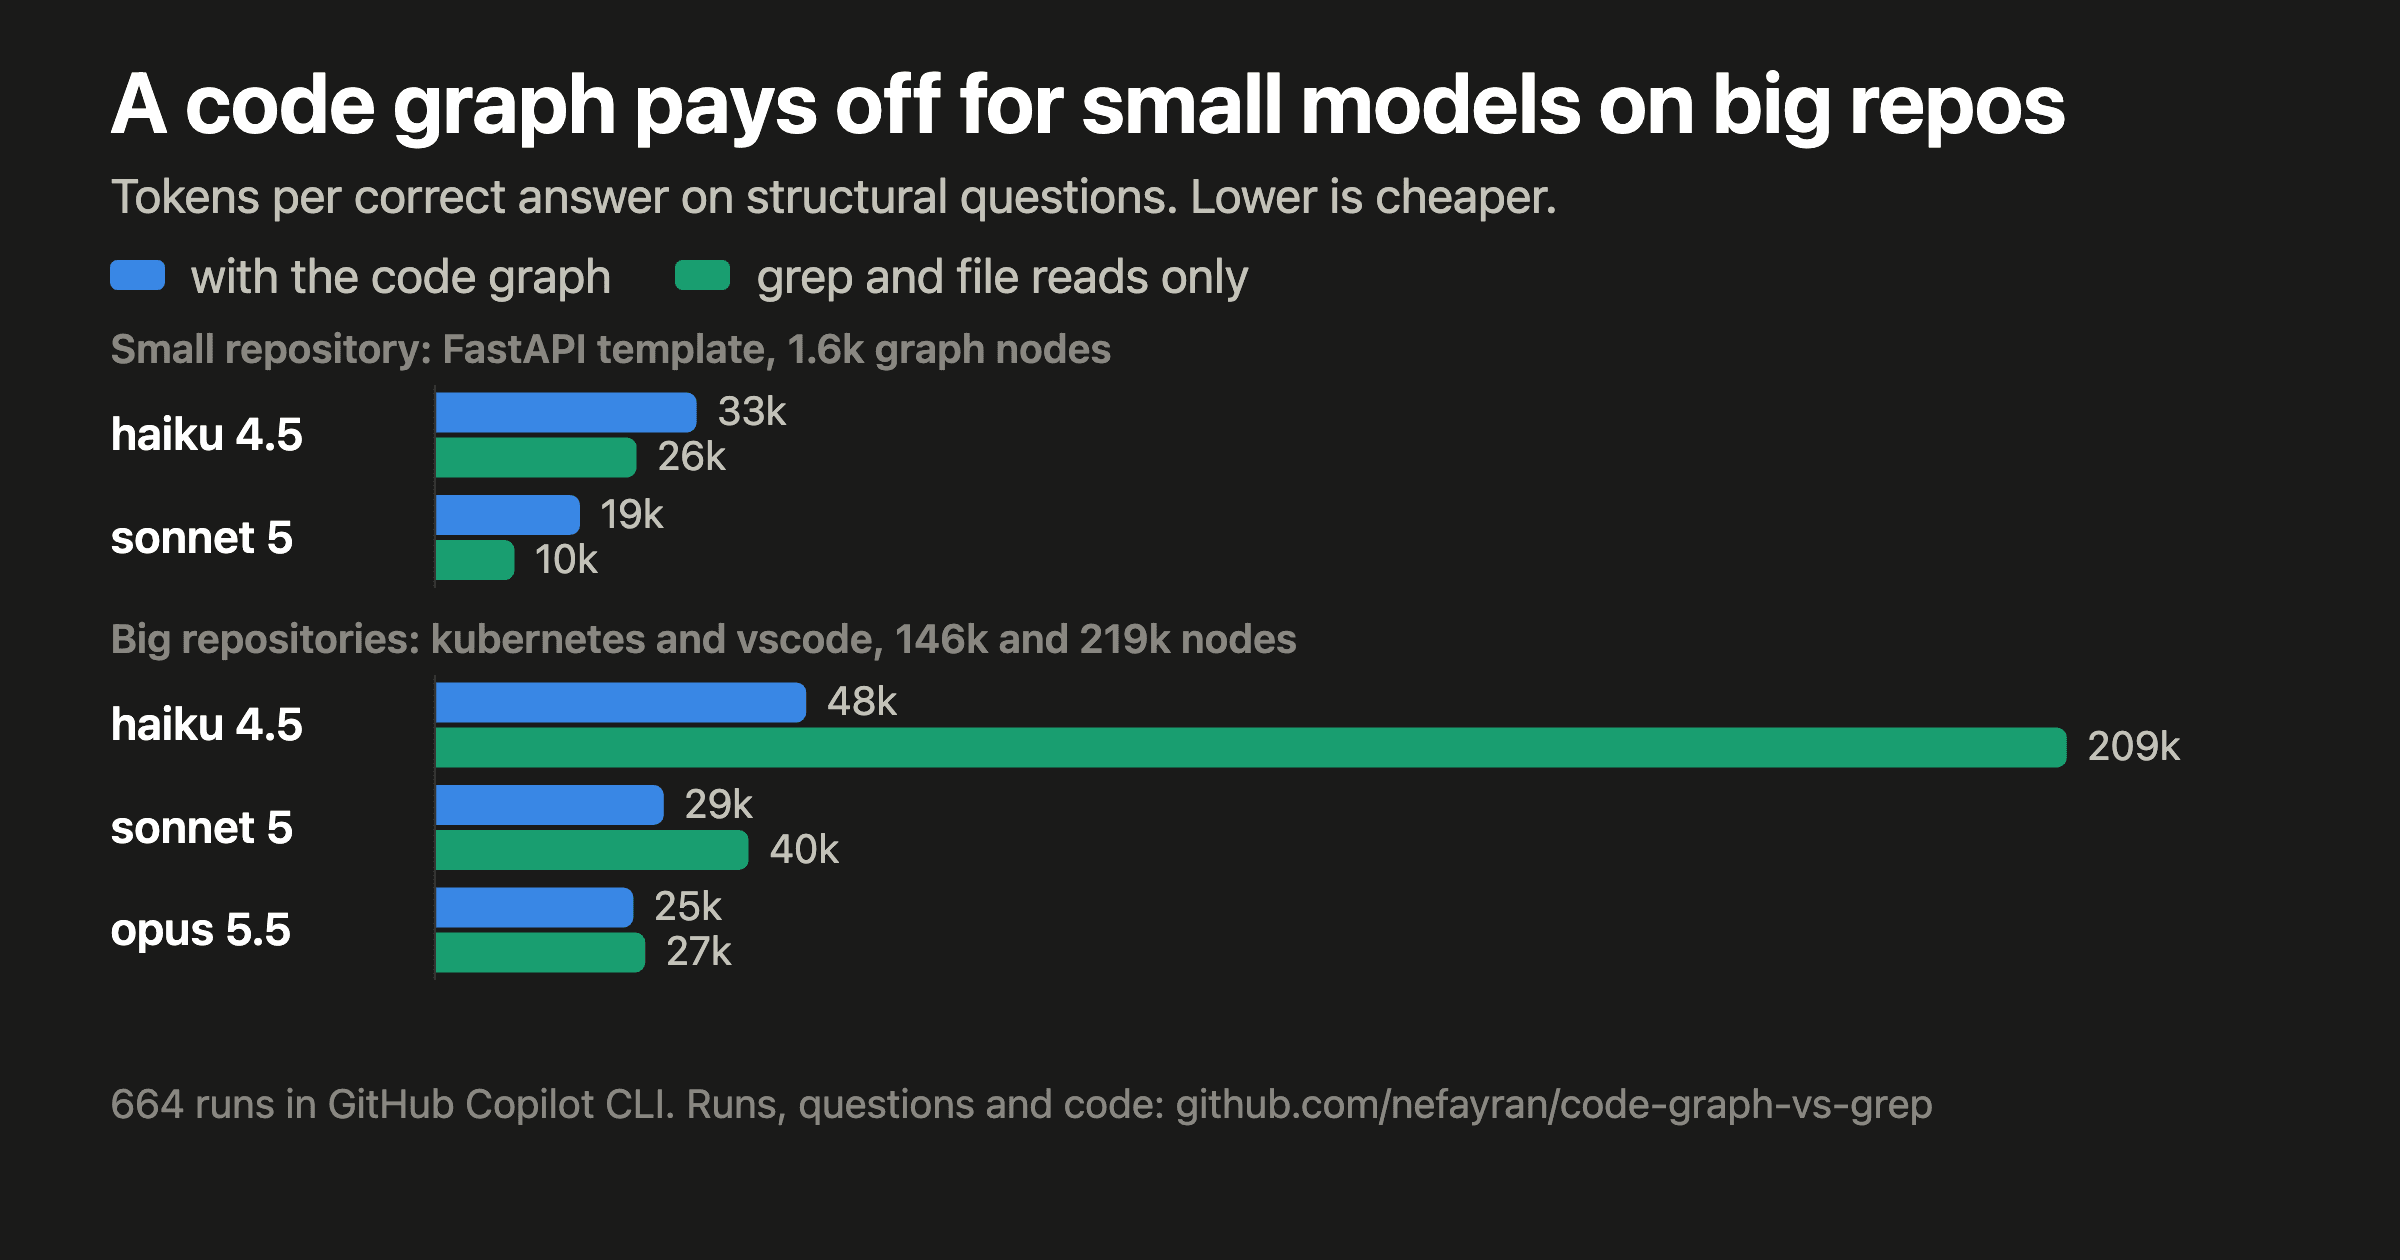
代码图在什么情况下划算:大仓库、小模型
在四个公开仓库上跑了 664 次无头 GitHub Copilot CLI,图节点数从 1.6k 到 219k,模型为 haiku 4.5、sonnet 5 和 opus 5.5。在 kubernetes 和 vscode 上,代码图把 haiku 回答结构性问题的成本降到了 grep 的 0.29。Sonnet 省下了大约四分之一,opus 什么也没省;而在小仓库上,图让 sonnet 多花了 40% 到 50%。
阅读笔记 →
什么都没算的 500 倍加速:WebGPU 模拟中的六个无声故障
一个 WebGPU 粒子模拟里的六个 bug 没有报任何错,还返回了看似可信的数字。每个 bug 看起来是什么样,以及改了什么。
阅读笔记 →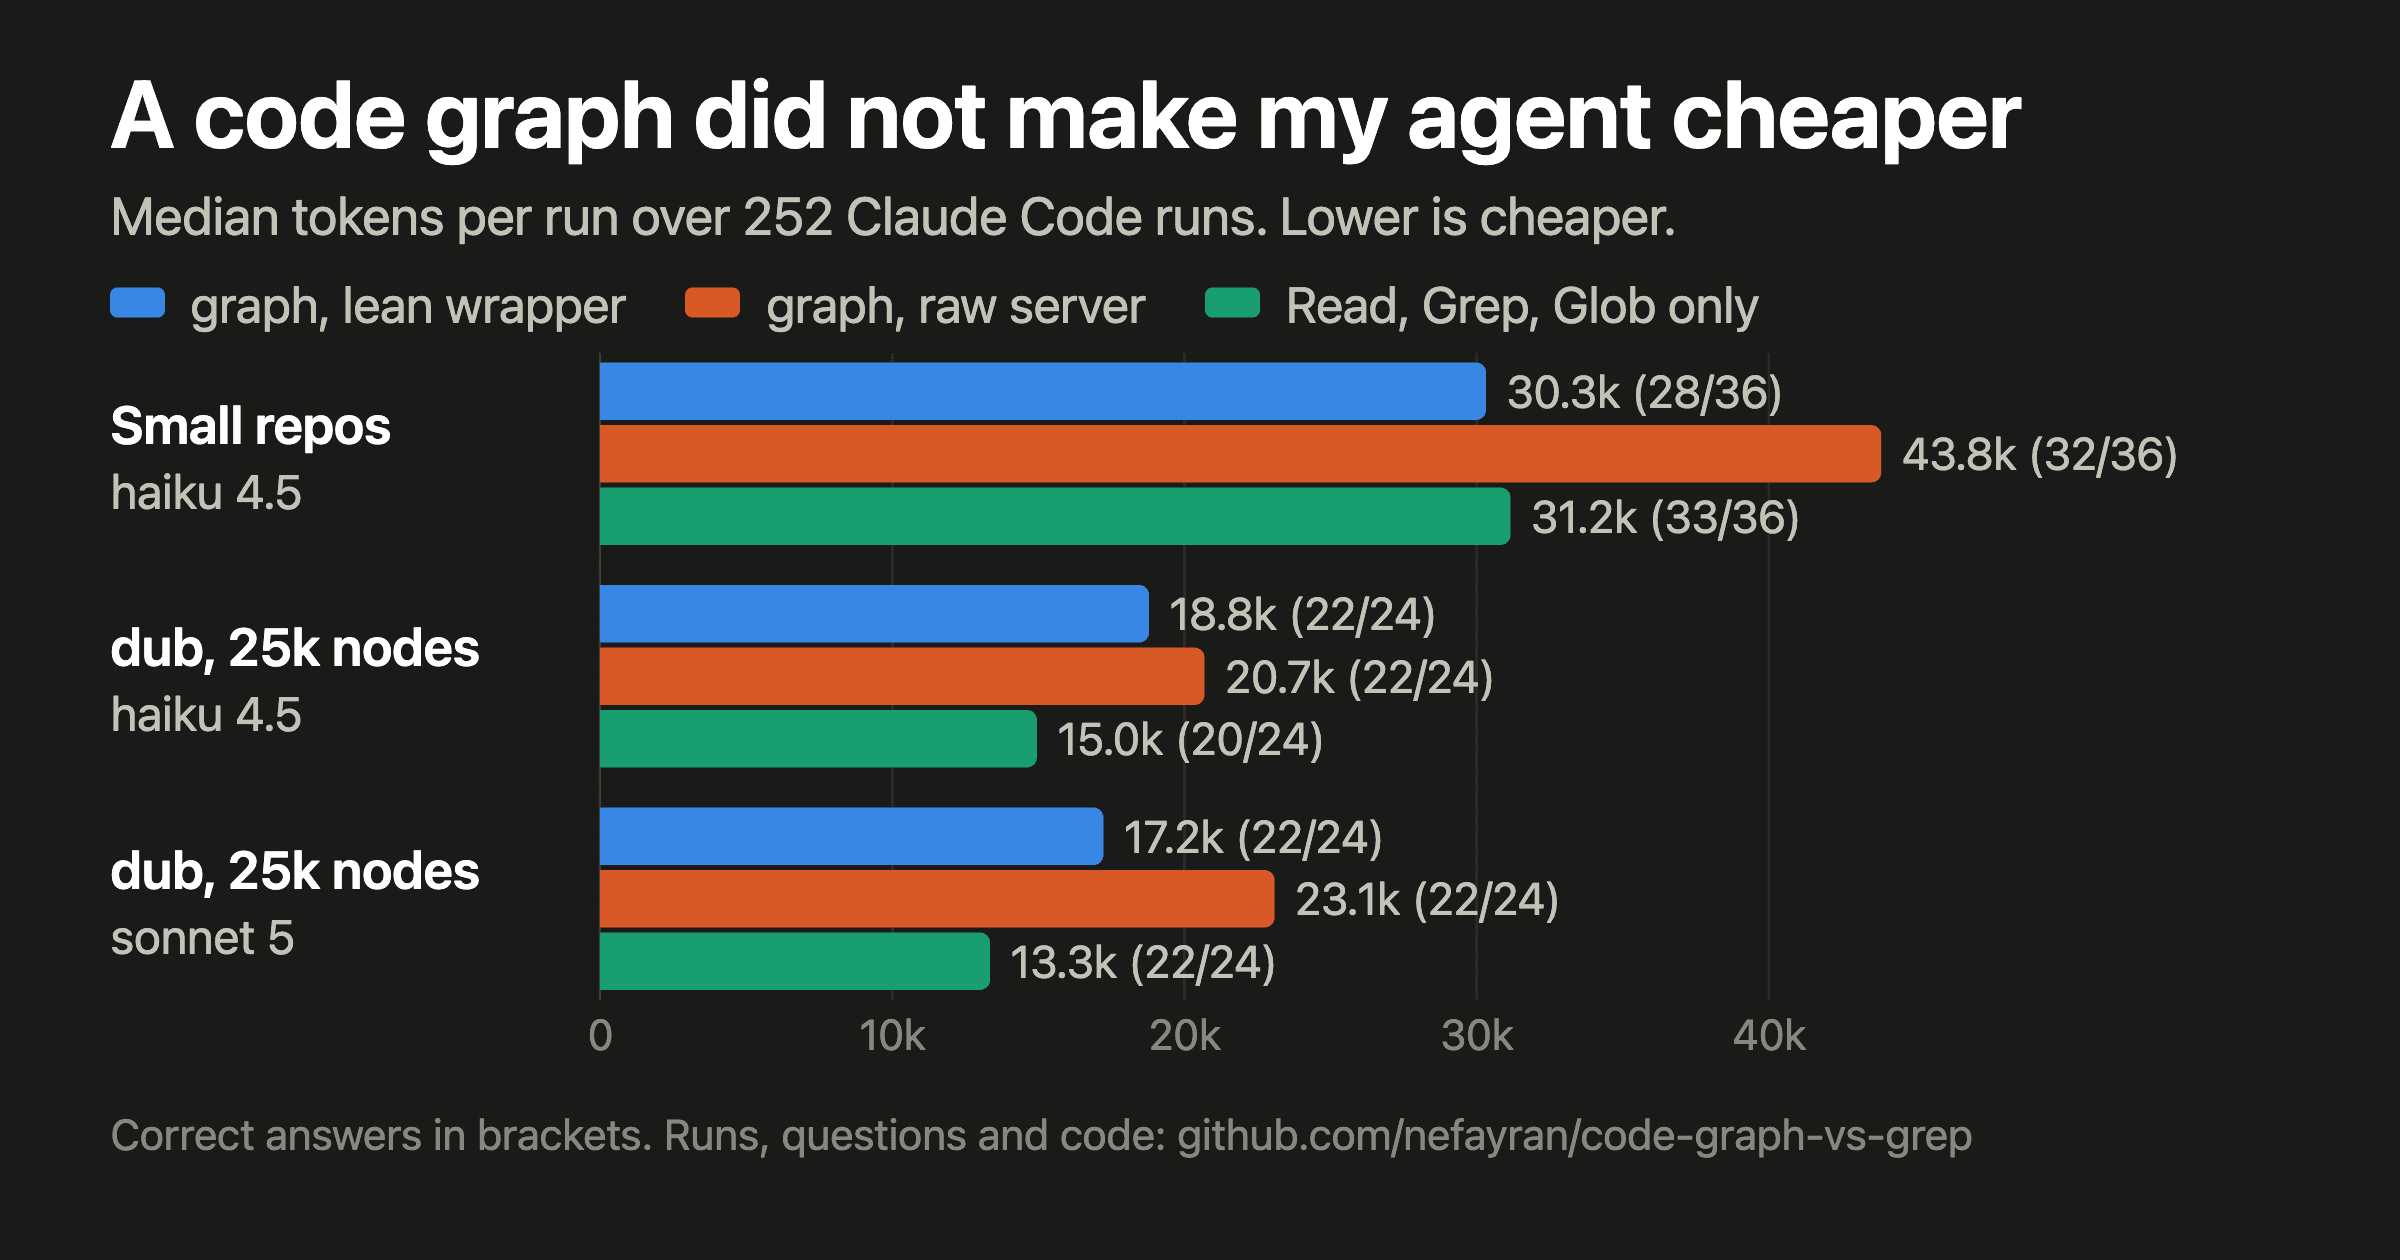
代码图没有让我的编程智能体更省钱
在公开仓库上跑了 252 次无头 Claude Code,图的节点数从 1.6k 到 25k,模型为 haiku 4.5 和 sonnet 5。按 token 计,代码图一次也没赢过 Read 和 Grep;精简包装层总是赢过原始图服务器;而在默认设置下,智能体几乎不调用图。
阅读笔记 →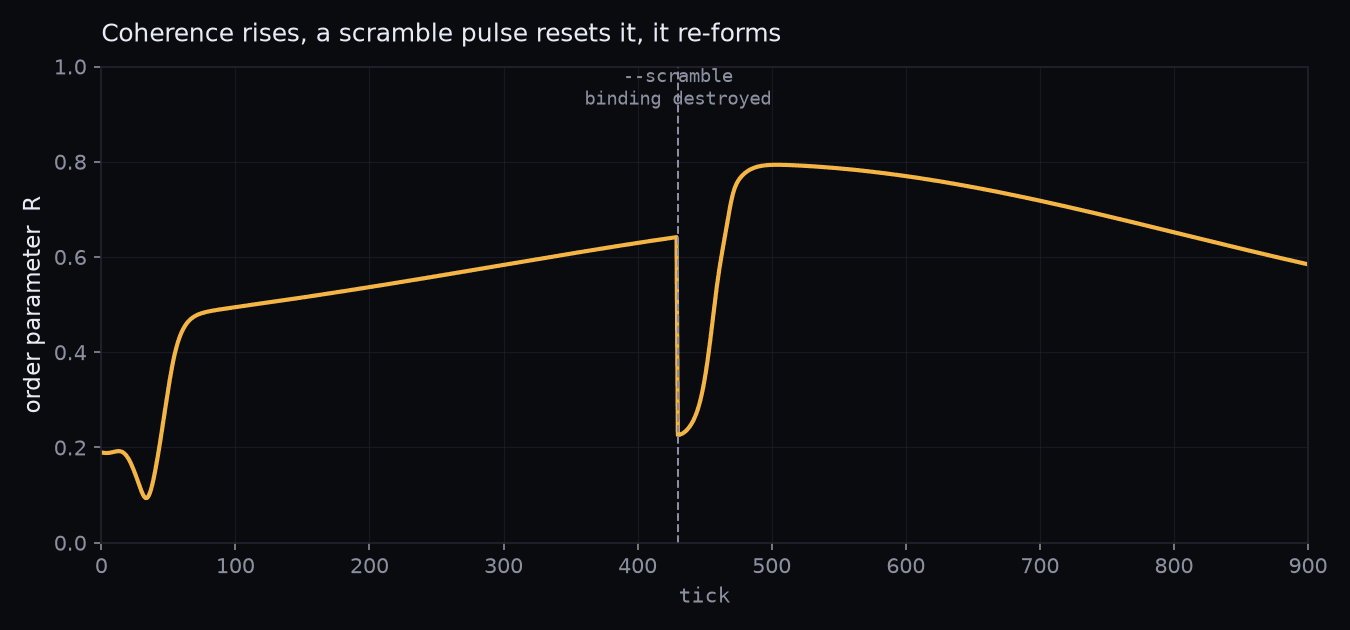
振荡器、嵌入,以及当场揭穿我们的对照实验
实验 002 把语言节点换成了按相位同步放电、以嵌入相似度耦合的概念神经元。打乱相位的对照仍然得到了连贯的解读,所以意义来自读取场的模型,而不是网络本身。
阅读笔记 →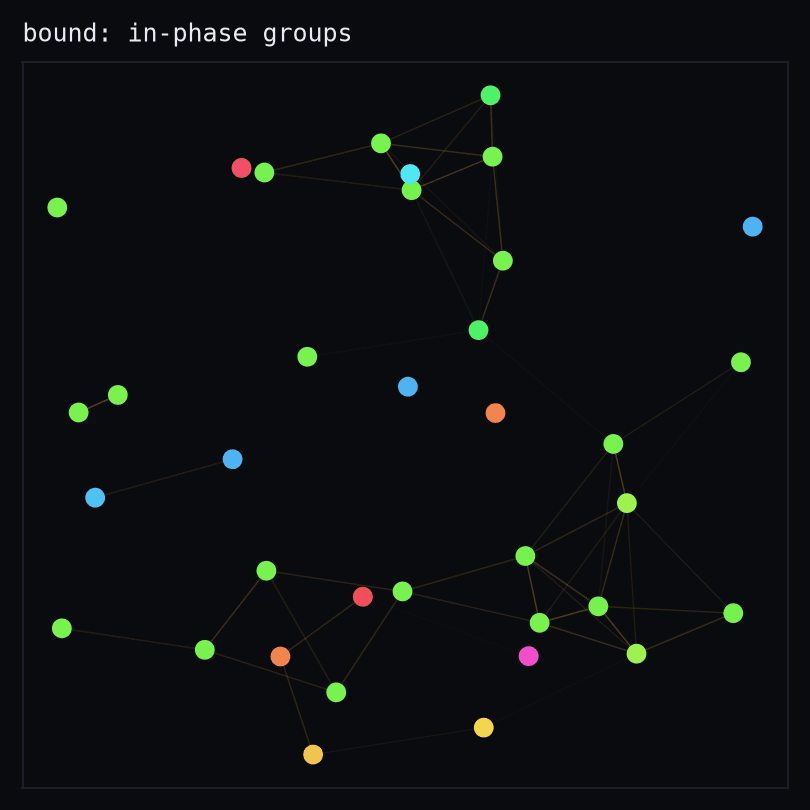
我们把语言模型连成一个心智,它塌缩成了一句话。
把同一个语言模型的八个副本连成一个环,不分角色,让它们接着彼此的思路往下想。它们收敛到同一句话上,不停重复:这就是模式崩溃。一个否定的结果。
阅读笔记 →