我上一次的基准测试得出的结论是,代码图没有让我的编程智能体更省钱。那次测试规模太小,只能说到这一步:24 个问题,没有一个仓库超过 25k 图节点,也没有 Opus。所以我换到一个答案有可能改变的规模重新跑了一遍,并且先把计划写了下来。假设、仓库、预算和分析方法都在 PLAN-v2.md 里,在任何一次运行之前就已提交。
简单地说:当模型不用图就得一直搜下去时,图才划算。Haiku 在 kubernetes 和 vscode 上就是这种情况。Sonnet 在那里能省一点,opus 什么也省不下;而在小仓库上,sonnet 用图比用普通 grep 还要贵。
设置
智能体用的是 GitHub Copilot CLI 1.0.90,以无头模式运行,每个会话一个问题,分两种方案:
- grep 方案:只有 Copilot 的 view、grep 和 glob 工具,别无其他;
- 图方案:同样这三个工具,再加上 cbm-lean(我给 codebase-memory-mcp 0.9.0 写的一层薄包装)和提示词开头的一条路由规则:调用方、被调用方和调用链交给图,精确字符串交给 grep。
四个公开仓库,每个都固定在一个提交上:
| 仓库 | 语言 | 图节点数 |
|---|---|---|
| full-stack-fastapi-template | Python、TypeScript | 1,601 |
| dub | TypeScript | 25,023 |
| kubernetes | Go | 146,421 |
| vscode | TypeScript | 218,883 |
每个仓库有 16 个问题。八个是结构性的:谁调用了某个函数,它又调用了什么,从一条 CLI 命令或一个 HTTP 处理函数一直到某个指定函数的调用路径,以及改动某个签名会让哪些函数出错。另外八个是精确性的:一个配置值,某个环境变量在哪里被读取,某个错误在哪一行抛出,某个类型在哪一行定义。每条标准答案我都在固定的提交上亲手核对过,而且其中每一项只按整词匹配,所以 init_db 不能算作 init。
Haiku 4.5 在每种方案下把全部 64 个问题各回答了三次,sonnet 5 各回答了两次。在 Copilot 里,Opus 5.5 每个提示词要消耗 15 次高级请求,所以它把来自 kubernetes 和 vscode 的十二个结构性问题各回答了一次。总计 664 次运行,约 744 次高级请求。
和第一篇笔记一样,成本用 tokenEquiv 衡量:未缓存的输入,加 1.25 × 缓存写入,加 0.1 × 缓存读取,再对一次运行中的所有模型调用求和。
结果
图的成本占 grep 成本的比例:对每个问题,用图方案在各次重复上的中位数除以 grep 方案的中位数,再对所有问题取中位数,并给出 95% bootstrap 置信区间。低于 1 表示图更便宜。
| 模型 | 仓库规模 | 结构性 | 精确性 |
|---|---|---|---|
| haiku 4.5 | 小型(1.6k 节点) | 0.88 (0.65–1.29) | 0.92 (0.72–1.15) |
| haiku 4.5 | 中型(25k) | 0.61 (0.11–1.50) | 0.96 (0.75–1.37) |
| haiku 4.5 | 大型(146k、219k) | 0.29 (0.11–0.70) | 1.01 (0.94–1.28) |
| sonnet 5 | 小型 | 1.51 (1.45–1.70) | 1.42 (1.20–1.71) |
| sonnet 5 | 中型 | 0.94 (0.57–2.00) | 1.14 (1.05–1.30) |
| sonnet 5 | 大型 | 0.74 (0.62–0.92) | 1.13 (1.01–1.29) |
| opus 5.5 | 大型 | 0.97 (0.72–1.10) | – |
结构性问题的正确答案数,图对 grep:
| 模型 | 小型 | 中型 | 大型 |
|---|---|---|---|
| haiku 4.5 | 13/24 对 19/24 | 20/24 对 22/24 | 38/47 对 33/48 |
| sonnet 5 | 13/16 对 15/16 | 16/16 对 16/16 | 32/32 对 28/32 |
| opus 5.5 | – | – | 12/12 对 12/12 |
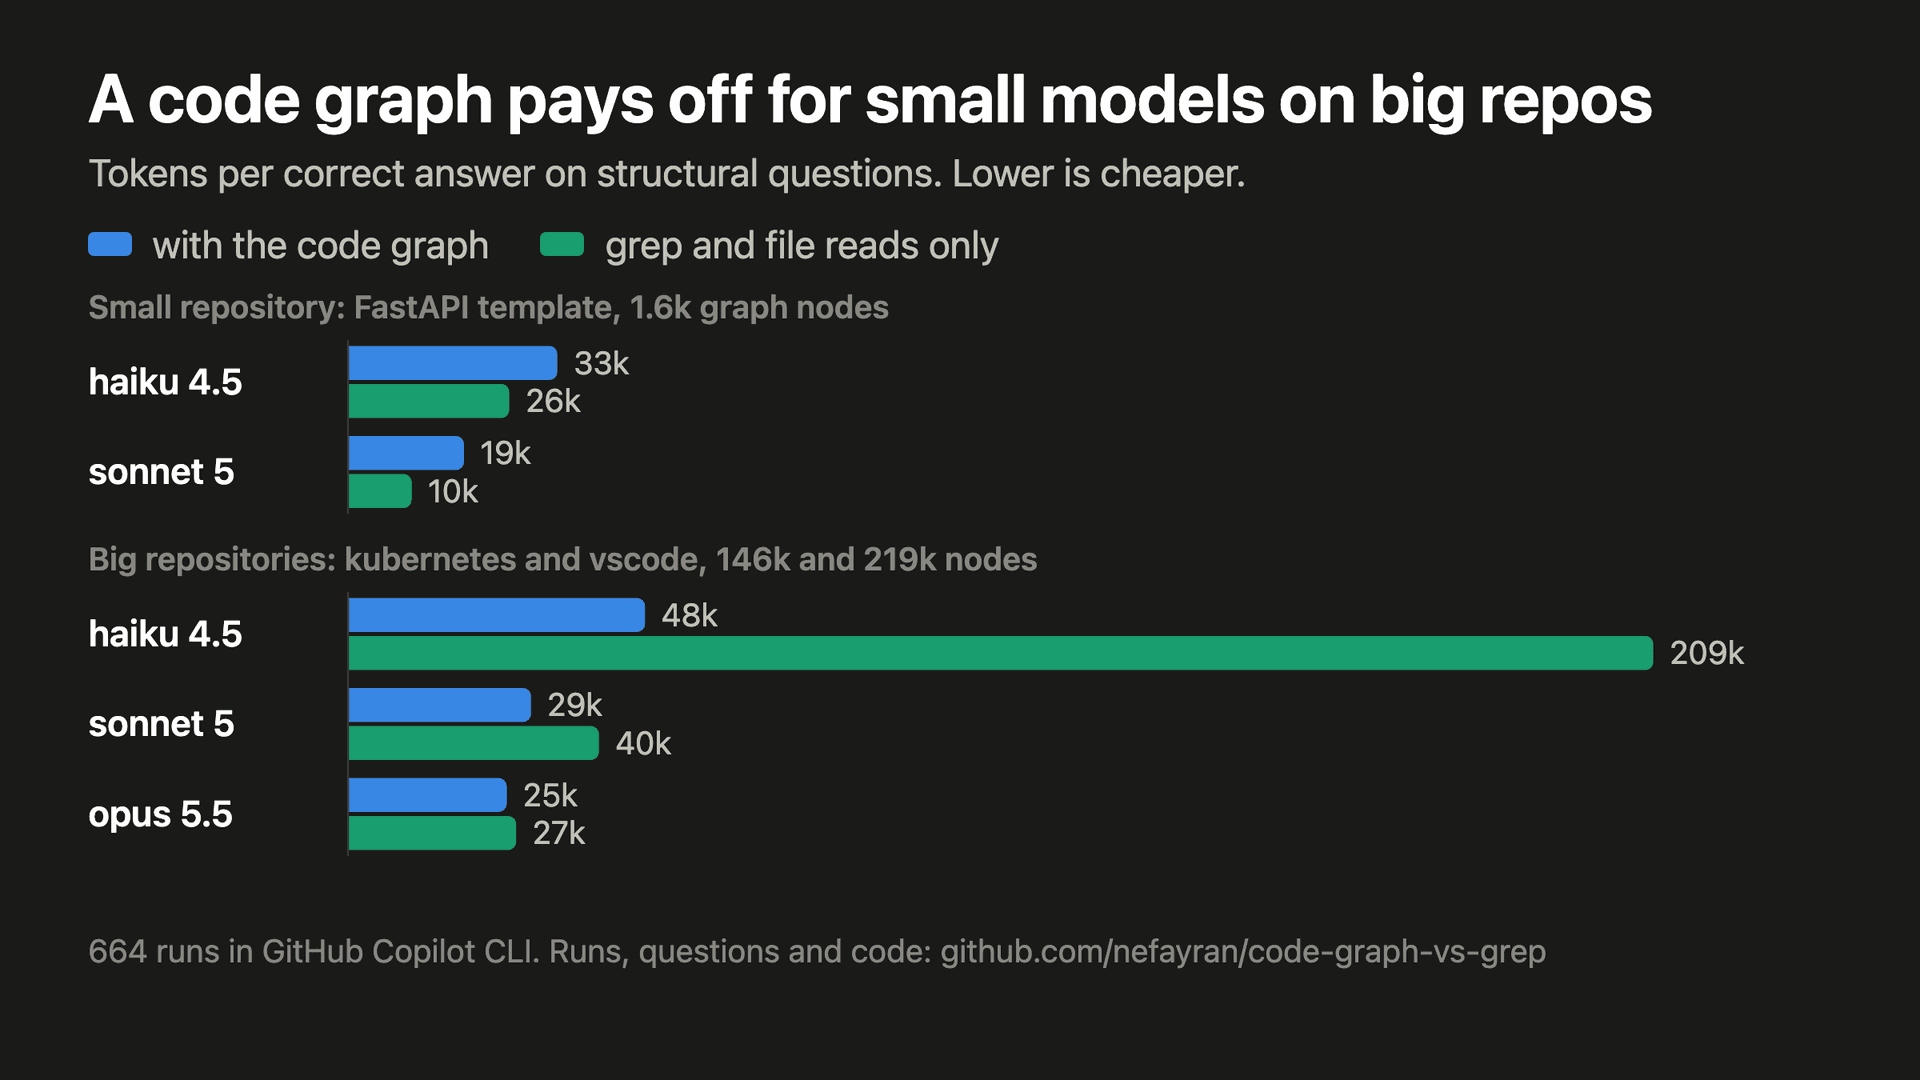
把成本和准确率合在一起看,即结构性问题上每个正确答案的 tokenEquiv:
站得住的结果:
- 在 kubernetes 和 vscode 上,haiku 用图回答结构性问题的花费是用 grep 时的 0.29,16 个问题中有 15 个更便宜。它答对的次数也更多,所以按每个正确答案算,差距是 47k 对 209k tokenEquiv。这是 13 项检验经 Holm 校正后唯一仍然显著的结果(p = 0.006)。
- Sonnet 在同样的问题上:0.74,16 个中有 12 个更便宜,答对 32 个中的 32 个,grep 是 32 个中的 28 个。Opus:0.97,12 个中有 7 个更便宜,两种方案下全部答对。
- 在小仓库上,图一次也没有划算过。Haiku 花得差不多,结构性问题却答错得更多。Sonnet 多花了 42% 到 51%。
- 在精确性问题上,图对 haiku 没有带来可测量的差异,而 sonnet 为它多付了 13% 到 42%。
- 图的工具 schema 和路由规则会给每一次模型调用固定增加提示词 token:haiku 是 1.56k,sonnet 和 opus 是 2.07k,在每种仓库规模下都一样。
为什么小模型获益最多
数一数模型调用的次数。用 grep 时,haiku 每回答一个结构性问题,所需调用次数的中位数在 kubernetes 上是 22 次,在 vscode 上是 20 次,有一个影响分析问题用了 114 次。用图时分别是 5 次和 4 次。每次调用都要把整段对话重新发送一遍,所以长搜索的成本远比它的调用次数看上去要高:haiku 用 grep 时最贵的一个答案达到了 471k tokenEquiv。
Sonnet 用 grep 时的搜索要短一些,8 次调用,用图时是 4 次。Opus 无论用哪种方式都是 4 或 5 次调用,所以图没有什么可削减的,而它的固定开销把省下的那一点点也吃掉了。
我的猜测(没有直接检验过):图替代的是搜索回合,所以当模型本来要走很多回合时,图才划算,也就是较弱的模型遇上较大的仓库。强模型用 grep 本来就搜得很高效,而在小仓库上,谁都用不着很多回合。
Copilot 按提示词收取高级请求,不管调用了多少次,所以在 Copilot 里用图省不了钱。它省的是时间:haiku 在大仓库上回答结构性问题,用图的耗时中位数是 71 秒,用 grep 是 157 秒。在小仓库上,图方案更慢。
每种方案错在哪里
- 一个叫
lines的字段。被问到HorizontalController定义在哪一行时,图方案在全部五次运行中都回答 horizontal.go:43,haiku 和 sonnet 都一样。这个结构体从第 93 行开始,长 43 行。codebase-memory-mcp 返回的代码片段带有"start_line": 93、"end_line": 135和"lines": 43,模型把最后一个读成了行号。同样的事在LemonSqueezyClient上又发生了一次(一个从第 59 行开始、长 129 行的类,答案是 client.ts:129),haiku 在CursorsController上也犯了同样的错。我的第一篇笔记把那个 client.ts:129 归咎于“来自图的行号”,它的来源就在这里。用 grep 的 sonnet 三个都答对了。现在 cbm-lean 把这个字段改名为line_count再往下传。 - 图有漏洞,却被照单全收。对于用
from x import y导入的函数,如果直接以裸名调用,codebase-memory-mcp 0.9.0 不会记录调用边。被问到recover_password调用了什么时,图方案在全部五次运行中都回答“只有 get_user_by_email”,haiku 和 sonnet 都一样,答案直接取自图,一次 grep 都没做。这个函数还调用了generate_password_reset_token、generate_reset_password_email和send_email,而 grep 方案每次都把这四个全部找到了。 - 少了一个短横线。Copilot 的 grep 工具只有收到
"-n": true时才显示行号,而它的 view 工具返回的文件不带行号。Sonnet 在 571 次 grep 调用中有 508 次传了-n,opus 则 53 次全都传了。在 haiku 的 1,949 次 grep 调用中,有 920 次传的是不带短横线的n,有 22 次传的是-n。工具会忽略不认识的键,所以 haiku 拿不到行号,只能在 view 打开的文件里自己数行,结果差了几行:对于一个在第 112 行抛出的错误,它的回答是 105, 107, 108 和 113。在精确性问题上,haiku 的 79 个错误答案中除了一个,其余全是行号错误。 - 搜索很长,照样失败。在从
kubeadm token create一直到encodeTokenSecretData的调用链上,用 grep 的 haiku 用了 18 到 22 次调用,三次都把路径答错了。用图时它也答错了。Sonnet 在两种方案下都答对了。 - Haiku 在 grep 方案中三次试图调用 bash。Copilot 拒绝了,因为那里没有这个工具,所以没有任何一次运行用到了不属于自己方案的工具。
与第一篇笔记相比有什么变化
第一篇笔记说,在节点数不超过 25k 的仓库上配合 Claude 模型使用图,不要指望能省 token。在这样的规模上,这一点依然成立。它没有看到超过这个规模之后的情况:在 kubernetes 和 vscode 上,较小的模型会获益,而且模型越小,获益越多。
我会对正在把图接入智能体的团队说什么
- 先用你们最便宜的模型,在你们最大的仓库上测一测。图正是在那里才物有所值。
- 如果是强模型配小型或中型仓库,就别接入图。你要在每次调用上为它的 schema 付费,却什么也得不到。
- 精确问题继续交给 grep。在这类问题上,图从来没有赢过。
- 不要让模型不加核实就采信图输出里的行号,或者“这就是完整列表”这类说法。像
lines这样的字段,在到达模型之前就删掉或改名。
局限
- 只有一个智能体框架(Copilot CLI)和一个图(codebase-memory-mcp 0.9.0,外面套着我的包装层)。换成 Claude Code、另一个图或者更新的版本,可能会得出不同的数字。
- 在小型和中型仓库上,每个单元格只有八个问题。在 Holm 校正下共有 13 项检验,一个只有八个问题的单元格即使图赢下每一个问题,也达不到显著性,所以只有大仓库上 haiku 的结果是显著的。
- Opus 回答了十二个问题,每个只答一次。
- tokenEquiv 没有把输出 token 算进去。如果算上它们,haiku 在大仓库上的差距还会更大:它在那里用 grep 给出的答案,输出 token 的中位数是 7.0k,用图时是 0.9k。
- 有一次 haiku 运行在 Copilot 打开会话之前就失败了,没有计入。有三次 sonnet 运行在任何模型调用之前就没能获取 Copilot 的模型列表,于是重新跑了。这两种情况都记录在计划里。
复现
所有东西都在 code-graph-vs-grep 里:运行之前写好的计划、附有每条标准答案依据的问题、驱动程序、全部 664 次运行及其答案,以及分析。
node bench/run-copilot.mjs --model claude-haiku-4.5 --reps 3 --out results/v2/claude-haiku-4.5.json
python3 bench/stats-v2.py results/v2/*.json