10月4日,我的 Mac 上有一次 Pixal3D 运行进入了纹理阶段,十秒之内,进程就从 27 GB 涨到了 44 GB。可用内存降到 6%,swap 增长了 12 GB,于是我跑重任务时都会套上的防护程序把它停了下来。这台 Mac 有 48 GB 内存。在有这个防护程序之前,有两次 Pixal3D 运行以 Mac 重启告终,其中一次是和别的重任务同时跑的。
Pixal3D 把一张图片变成带纹理的 3D 网格,Pixal3D-mac 是它在 Apple Silicon 上的移植版。1024_cascade 流水线依次运行七个模型:用于粗略结构的一个流模型和一个解码器,分别用于 512 和 1024 形状的两个流模型,一个形状解码器,以及用于纹理的一个流模型和一个解码器。围绕它们工作的还有四个图像特征提取器、一个背景去除器和一个相机估计器。每个阶段要用到这七个模型中的一两个,而移植版从第一秒到最后一秒都把它们全部留在内存里。
为什么内存回不来
在 Apple Silicon 上,CPU 和 GPU 共用同一个内存池。Pixal3D 的低显存模式默认开启,它把空闲的模型留在 CPU 上,把当前在用的那个复制到 GPU。在带独立显卡的 PC 上,这样能省下显存。而在 Mac 上,CPU 上的副本和 GPU 上的副本待在同一块内存里,所以这个模式让每个模型都常驻内存,还给当前在用的那个加了第二份副本。四个特征提取器还把同一个 DINOv3 骨干网络加载了四次。
一次加载一个阶段
stageload 是我为此写的一个小库。它把流水线的模型字典换成另一个字典,新字典在某个阶段第一次请求某个模型时才加载它,并释放下一个阶段没有列出的所有模型。释放就是把模块的每个张量都移到 PyTorch 的 meta 设备上。这样即使别的代码还持有对这个模块的引用,存储也会被释放;之后再调用这个模块,抛出的错误会写明它是哪个模块、由哪个阶段释放,而不是在 PyTorch 内部的某个地方失败。
移植版自己的 run() 原封不动地执行。stageload 包装了流水线的四个方法,以此得知每个阶段从哪里开始:背景去除、第一次图像条件化、每一轮形状和纹理的条件化,以及最后的解码。四个特征提取器被构建成共用同一个骨干网络。
其中有一部分出了问题也不会报任何错误。Pixal3D 在运行开始时设置一次种子,之后每个阶段的噪声都从 CPU 随机数生成器中抽取。构建模型时会执行它的随机初始化,而随机初始化同样从这个生成器中抽取。因此,在运行中途惰性构建一个模型,会改变它之后每个阶段的噪声,网格也会跟着改变。stageload 在每次加载之前保存这些生成器的状态,加载之后再恢复:torch 的 CPU、MPS 和 CUDA 生成器,Python 的 random,以及 NumPy 的全局生成器。在一个像移植版那样设置种子、抽取噪声的替身流水线上,有一个测试检查 staged 和 eager 两种运行得到的潜变量是否逐位相同,而关掉恢复的对照测试会看到两者逐渐偏离。
不只是 Pixal3D
stageload 的核心对 Pixal3D 一无所知。它对一条流水线只要求三样东西:一个能单独构建每个模型的函数,一份每个阶段用到哪些模型的列表,以及在每个阶段开始的地方的一次调用。如果是你自己的代码,这次调用只有一行:models.enter("decode")。如果是别人的代码,比如这个移植版,on_call 会把它挂到一个本来就在那个位置运行的方法上,流水线本身保持原样。文生图流水线和 Pixal3D 的结构一样:文本编码器、去噪器和图像解码器依次运行。内存计量器和防护程序适用于 Mac 上的任何程序。到目前为止,我只测量过 Pixal3D 这一条流水线;README 用一条由两个模型组成的小流水线演示了核心,这个例子会作为测试运行。
它改变了什么
在这台 48 GB 的 M5 Pro 上,我用 1024_cascade 跑了移植版自带的示例图片,种子为 7,纹理为 2048 像素,每种模式跑两次,每次都在防护程序之下的独立进程里运行。“eager”是移植版自己的加载方式,“staged”是 stageload。在这台机器上,eager 运行无法在防护程序的限制之内跑完纹理阶段,所以两次 eager 运行都停在纹理阶段开始的地方。eager 的纹理数字来自10月4日那次进入了纹理阶段的运行。
| 阶段 | eager 峰值占用 | staged 峰值占用 |
|---|---|---|
| setup | 20.4 GB | 2.9 GB |
| camera | 23.2 GB | 6.7 GB |
| structure | 22.2 GB | 10.9 GB |
| shape_512 | 26.6 GB | 11.4 到 11.5 GB |
| shape_1024 | 30.5 GB | 13.1 GB |
| texture | 在 44.2 GB 时被防护程序停止 | 30.1 GB |
| decode | 未到达 | 17.9 到 18.4 GB |
| export | 未到达 | 69.6 到 70.2 GB |
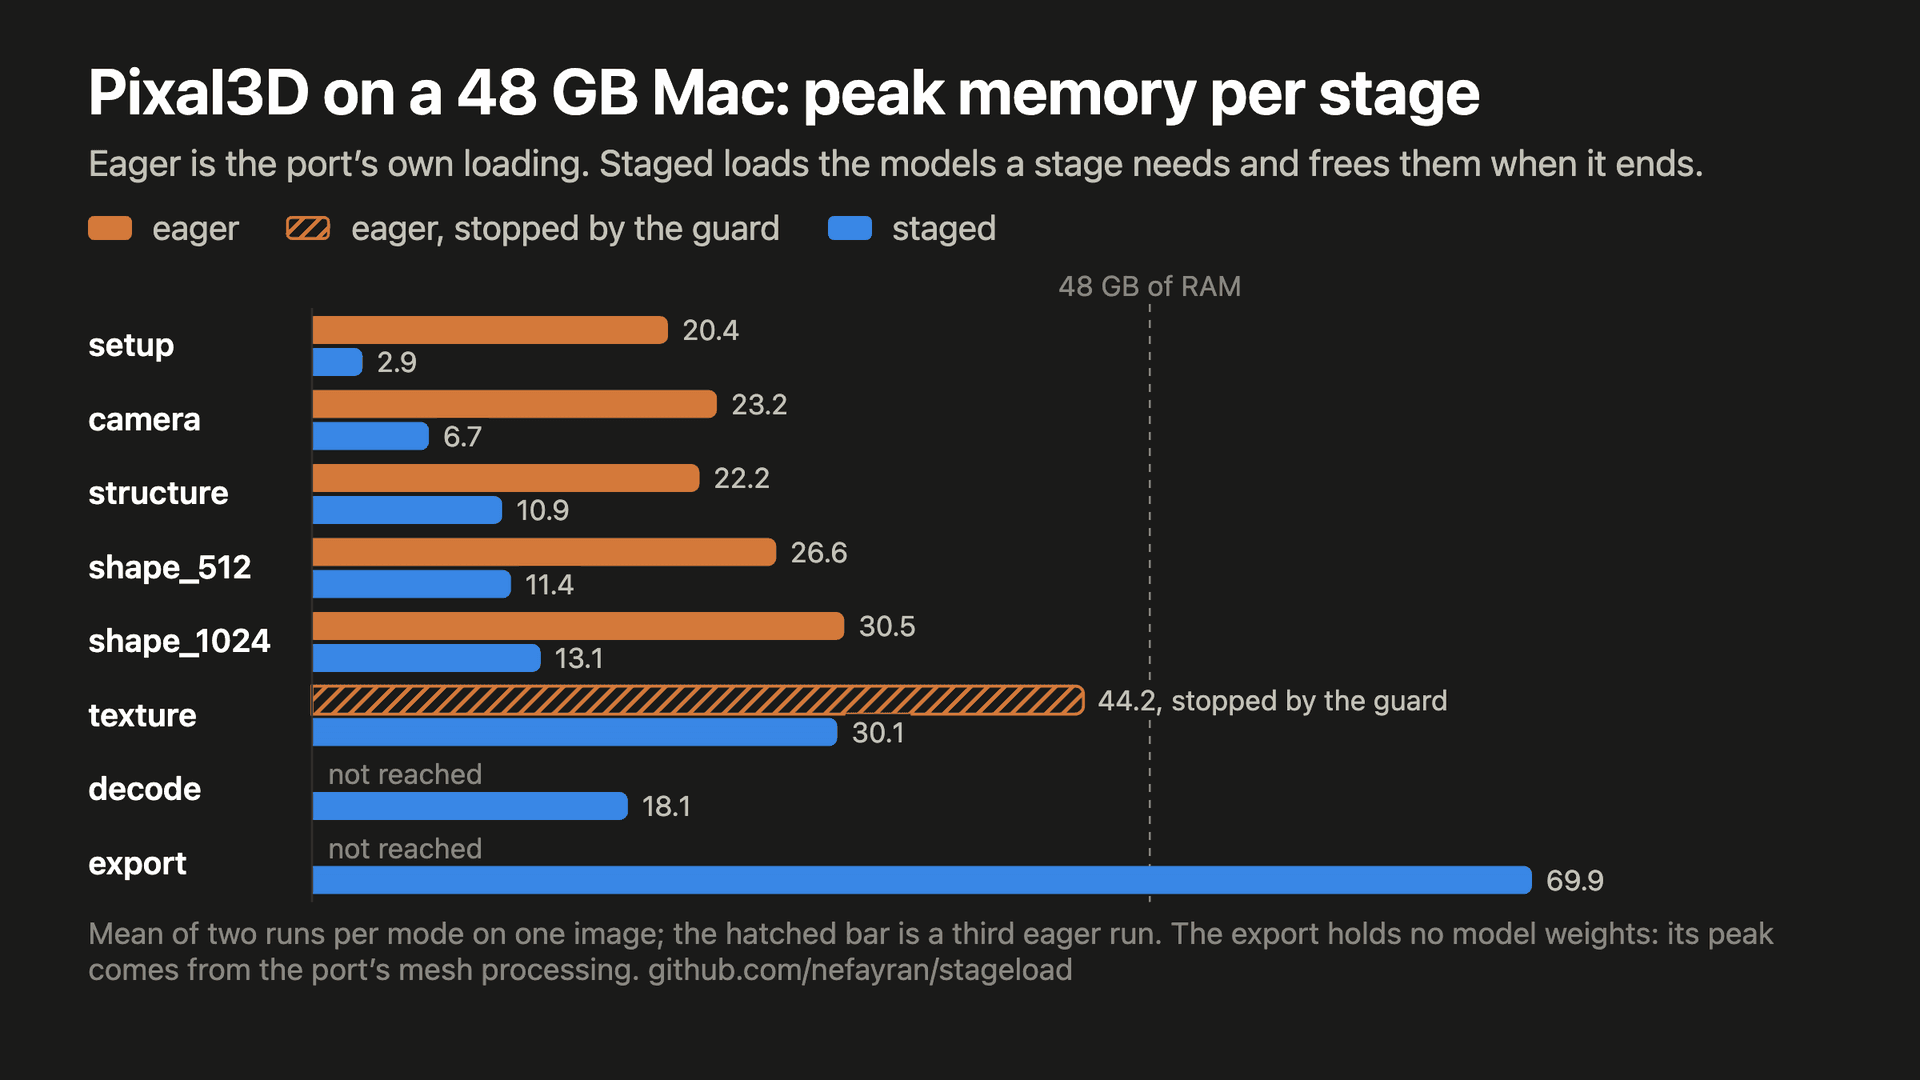
在两种模式都跑到的每个阶段里,staged 都少占了 11.3 到 17.5 GB。八次加载,也就是七个模型加上解码时第二次加载的形状解码器,在每次大约十分钟的运行中,用 24 秒读取了 13.2 GB。
纹理阶段的 30 GB 大部分是工作内存:纹理模型本身是 2.6 GB。解码开始时,stageload 把它和特征提取器一起释放,并清空了 MPS 分配器的缓存,两秒之内,占用在一次运行中降到了 4.5 GB,在另一次中降到了 8.0 GB。
staged 的最高数字约为 70 GB,出现在导出阶段,此时所有模型权重都已释放。它来自移植版的网格处理(重新网格化、UV 展开、烘焙),这部分 stageload 不碰。这里说的占用就是活动监视器显示的那个数字,它把 macOS 压缩过的内存也算在内,所以可能比 48 GB 的物理内存还大。
我没能证明的
第一点是 staged 加载会不会改变结果。每次运行都保存了每个采样器输出的哈希值和一份副本。第一个潜变量,也就是粗略结构,在全部四次运行中逐位相同。从 512 形状阶段起,即使种子相同,移植版在 MPS 上也不能复现自身的结果:两次 eager 运行的形状潜变量最多相差 1.77,一次 staged 运行与一次 eager 运行相差 1.24 到 1.86。所以,这次比较说明的是:staged 加载带来的任何变化都不大于移植版自身的波动,而这个波动是在那唯一一对 eager 运行上测得的。纹理潜变量和最终网格完全没有比较,因为在这里 eager 运行根本到不了那一步。
在 CPU 上构建也无济于事。stageload 直接在 GPU 上构建每个模型,这会改变一个检查点不覆盖的张量:稀疏注意力的旋转频率是在构建模型时计算的,结果最多相差 6e-8。为了看看这是否能解释那些差异,我跑了一遍 staged,像移植版那样先在 CPU 上构建每个模型,再移到 GPU 上。它的潜变量与 eager 运行相差 1.84 和 1.12,和其他每一对处于同一量级。加载用了 82 秒,而不是 24 秒;有三个阶段的峰值高出 2.6 到 3.8 GB,另外两个阶段则更低。我又改回了在 GPU 上构建。
我自己写的汇总有一个 bug,把一个数字算大了。它从阶段被记录为开始的那一刻起计算每个阶段的峰值,但释放上一个阶段的模型最多要 1.7 秒。这段空档里的一个内存采样,让在 CPU 上构建的那次运行的解码峰值成了 29.5 GB;从释放结束时算起,它是 16.7。这是一次代码审查发现的。现在,一个阶段的窗口要等它开始时触发的那些释放全部完成之后才开始。
防护程序
这些运行都是通过 stageload 的第二部分 stageload guard 来跑的,因为这台 Mac 上也在跑别的重任务。只有当可用内存足够,并且已经有一段时间没见到与重任务列表匹配的进程时,它才会启动一条命令。命令运行期间,如果 swap 的增长超过预算,或者可用内存持续低于 10%,它就停掉这条命令的整个进程组。它不需要 root 权限,而且它停掉的只会是它自己启动的进程。
等待安静的做法来自一次失败。一串视频任务之间会留下短暂的空隙,一次运行在其中一个空隙里启动了,而下一个视频任务在 20 秒内就让 swap 超出了预算。在这次基准测试中,每次运行都要等到连续三分钟看不到任何重任务之后才启动。
换一张图片
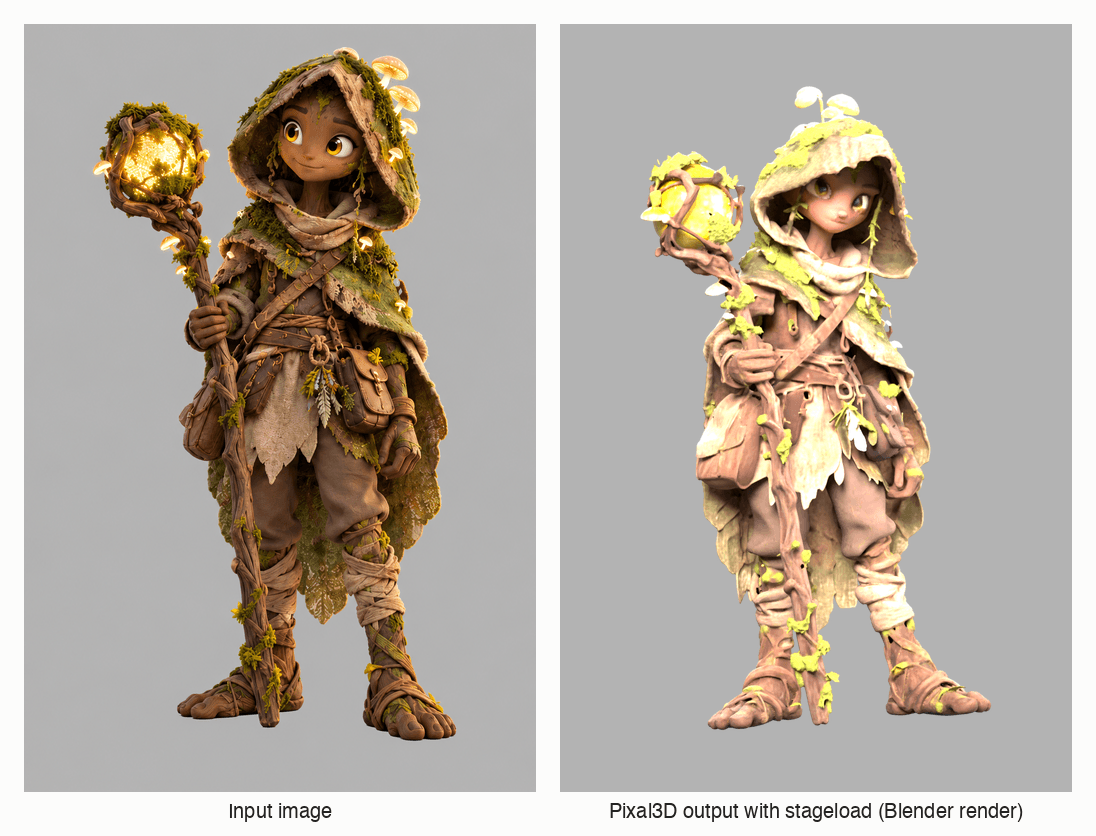
同样的 staged 运行,用在我正在做的一款游戏里的一个角色上,耗时 416 秒,用 37 秒加载了同样的 13.2 GB。它的纹理阶段峰值为 30.1 GB,和在示例图片上一样。下面是输入和它生成的网格,用 Blender 渲染:
代码、每次运行的追踪记录以及绘制这些图表的脚本都在仓库里。Pixal3D 适配器只在 Pixal3D-mac 的一个提交上测试过。