在 Linux 上,可以用 ulimit -v、systemd-run -p MemoryMax= 或 cgroup 给任务的内存设上限,任务长得太大时会自己失败,而不会拖垮整台机器。macOS 上既没有 systemd 也没有 cgroup,而 ulimit 直接拒绝。这是 macOS 26.5.2:
$ /bin/bash -c 'ulimit -v 1048576'
/bin/bash: line 0: ulimit: virtual memory: cannot modify limit: Invalid argument
$ /bin/bash -c 'ulimit -m 1048576'
/bin/bash: line 0: ulimit: max memory size: cannot modify limit: Invalid argument
Python 里的 resource.setrlimit(resource.RLIMIT_DATA, ...) 会抛出 ValueError;在 ulimit -m 失败的那个 shell 里,一个脚本接着分配并写入了 3 GiB。macOS 的做法是压缩内存,再把它写进 swap。装不下的模型不会失败,它会变慢,Mac 上的其他东西也一起变慢。
所以该问的问题变了:任务开始前有没有空间?运行时 swap 有没有在增长?
任务运行时看 swap
sysctl vm.swapusage             # compare "used" before and after a run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
进程的 footprint,也就是活动监视器显示的那个数字,不统计已经换出到 swap 的页。在我的 48 GB M5 Pro 上,一次使用 diffusers 的 model CPU offload 运行 Qwen-Image-2.1 时,footprint 从没超过 18.5 GB,而 swap 增长了 9.6 GB。只看 footprint 的图会认为这次运行装得下。
在 swap 之前停下任务
stageload 是我为按阶段加载模型写的一个小库,里面带了一个守护(pip install stageload):
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py它会等到 kern.memorystatus_level 至少为 40 %,再启动命令。如果 swap 比启动时多出 8 GB 以上,或者空闲内存连续两次采样低于 10 %,它就向命令的进程组发送 SIGTERM,五秒后再向剩下的进程发送 SIGKILL。它不需要 root,而且只会停止这条命令和它的进程组。退出码 3 表示守护停止了命令,4 表示一直没找到启动的空间;其他情况下返回命令自己的退出码。
eager 模式的 Qwen-Image 就是这样结束的:它跑完了全部 20 步,VAE 解码把 footprint 推到 43.6 GB,swap 增长了 8 GB,守护在 Mac 卡死之前停下了它。
同时跑两个重任务
守护是各自独立判断的。两个守护在同一时刻发现有空间,就会各自启动任务,而每个任务都是按一台没有别的东西在跑的 Mac 来估算的。10月5日,我的一次运行在另一个脚本的两个视频任务之间的空档启动,结果下一个视频任务在 20 秒内就让 swap 超出了预算。
stageload run 把任务放进整台机器共用的一个队列,参数和守护相同。这里从两个终端启动了两个任务,分别占用 3 GiB 和 2 GiB:
stageload run --who images -- python3 alloc.py 3 10    # holds 3 GiB for 10 s
stageload run --who upscale -- python3 alloc.py 2 4    # holds 2 GiB for 4 s
$ stageload queue
ram 0 running images pid 32488 since 2026-10-12T14:08:56+00:00 python3 alloc.py 3 10
ram 1 waiting upscale pid 32499 since 2026-10-12T14:08:58+00:00 python3 alloc.py 2 4第一个任务结束后第二个才开始,之后照常进行守护的检查:
14:08:58Z queue: waiting in ram (1 ahead: images)
14:09:08Z queue: start in ram after 10 s, swap 6.0 GB, stop above 14.0 GB or under 10% available twice
$ stageload queue --history 2
done ram exit 0 images waited 0 s, ran 10 s, peak 3.0 GB python3 alloc.py 3 10
done ram exit 0 upscale waited 10 s, ran 4 s, peak 2.0 GB python3 alloc.py 2 4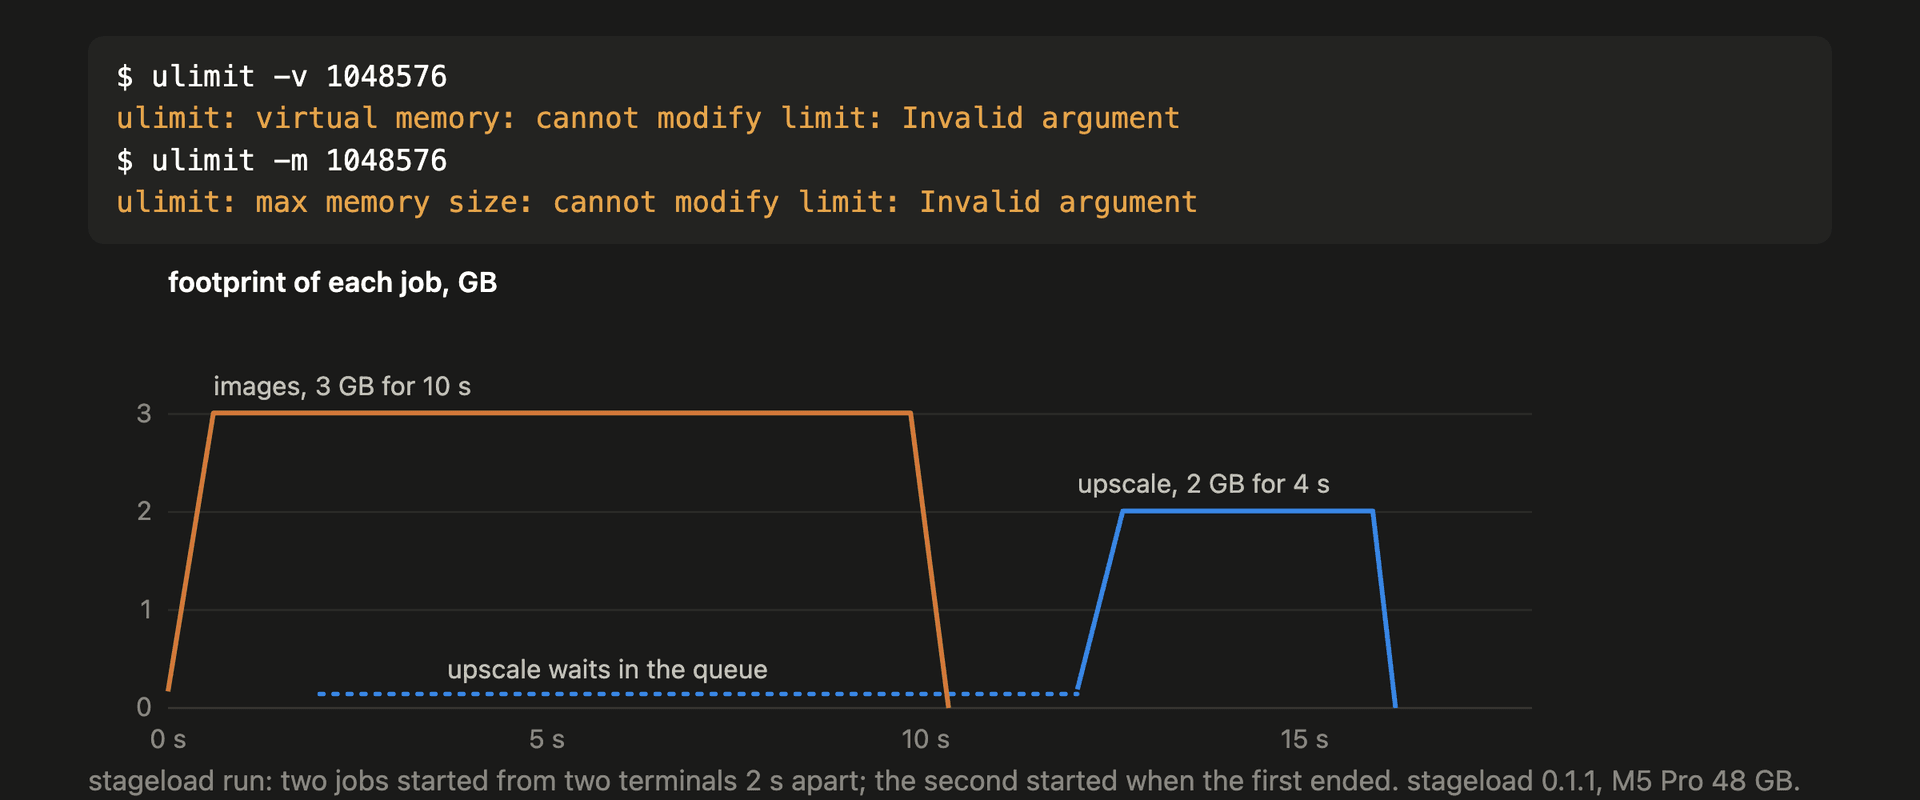
在共用的 Mac 上起作用的细节:
- 任务进入一条通道,默认是
ram。通道之间互不等待,所以受远程 API 配额限制的任务可以放进单独的通道(--lane api --wait-free 0),不会挡住需要内存的任务。 - 不同所有者之间轮流公平:最久没有启动过任务的所有者排在下一个,所以一个排了二十个任务的脚本也会和别人轮流,而不是霸占通道。所有者取
--owner,没有的话取--who第一个连字符之前的部分。 - 每次运行都会写下命令及其下所有进程的内存跟踪,并在
~/.stageload/history.jsonl里追加一行:等待时间、运行时间、footprint 峰值和 swap。 - 在队列之外启动的引擎写进
~/.stageload/busy.txt,每行一个模式。ram通道里的每次运行都会等到其中任何一个都已有 20 秒没出现为止。
局限
- 守护和计量器读取的是 macOS 的计数器(
libproc、sysctl),所以只能在 Mac 上运行。 - 守护只会停下任务,不会让任务变小。模型这一侧,是按阶段每次只加载一个模型,才让 Qwen-Image-2.1 在同一台 Mac 上从 43.6 GB 降到 19.0 GB:如何在 48 GB 的 Mac 上不用 swap 运行 Qwen-Image-2.1。
- 如果想给整台机器加一道保险,可以用 macos-oom-guard:它以 root 运行,在内核崩溃之前杀掉最大的进程。两者可以一起用。