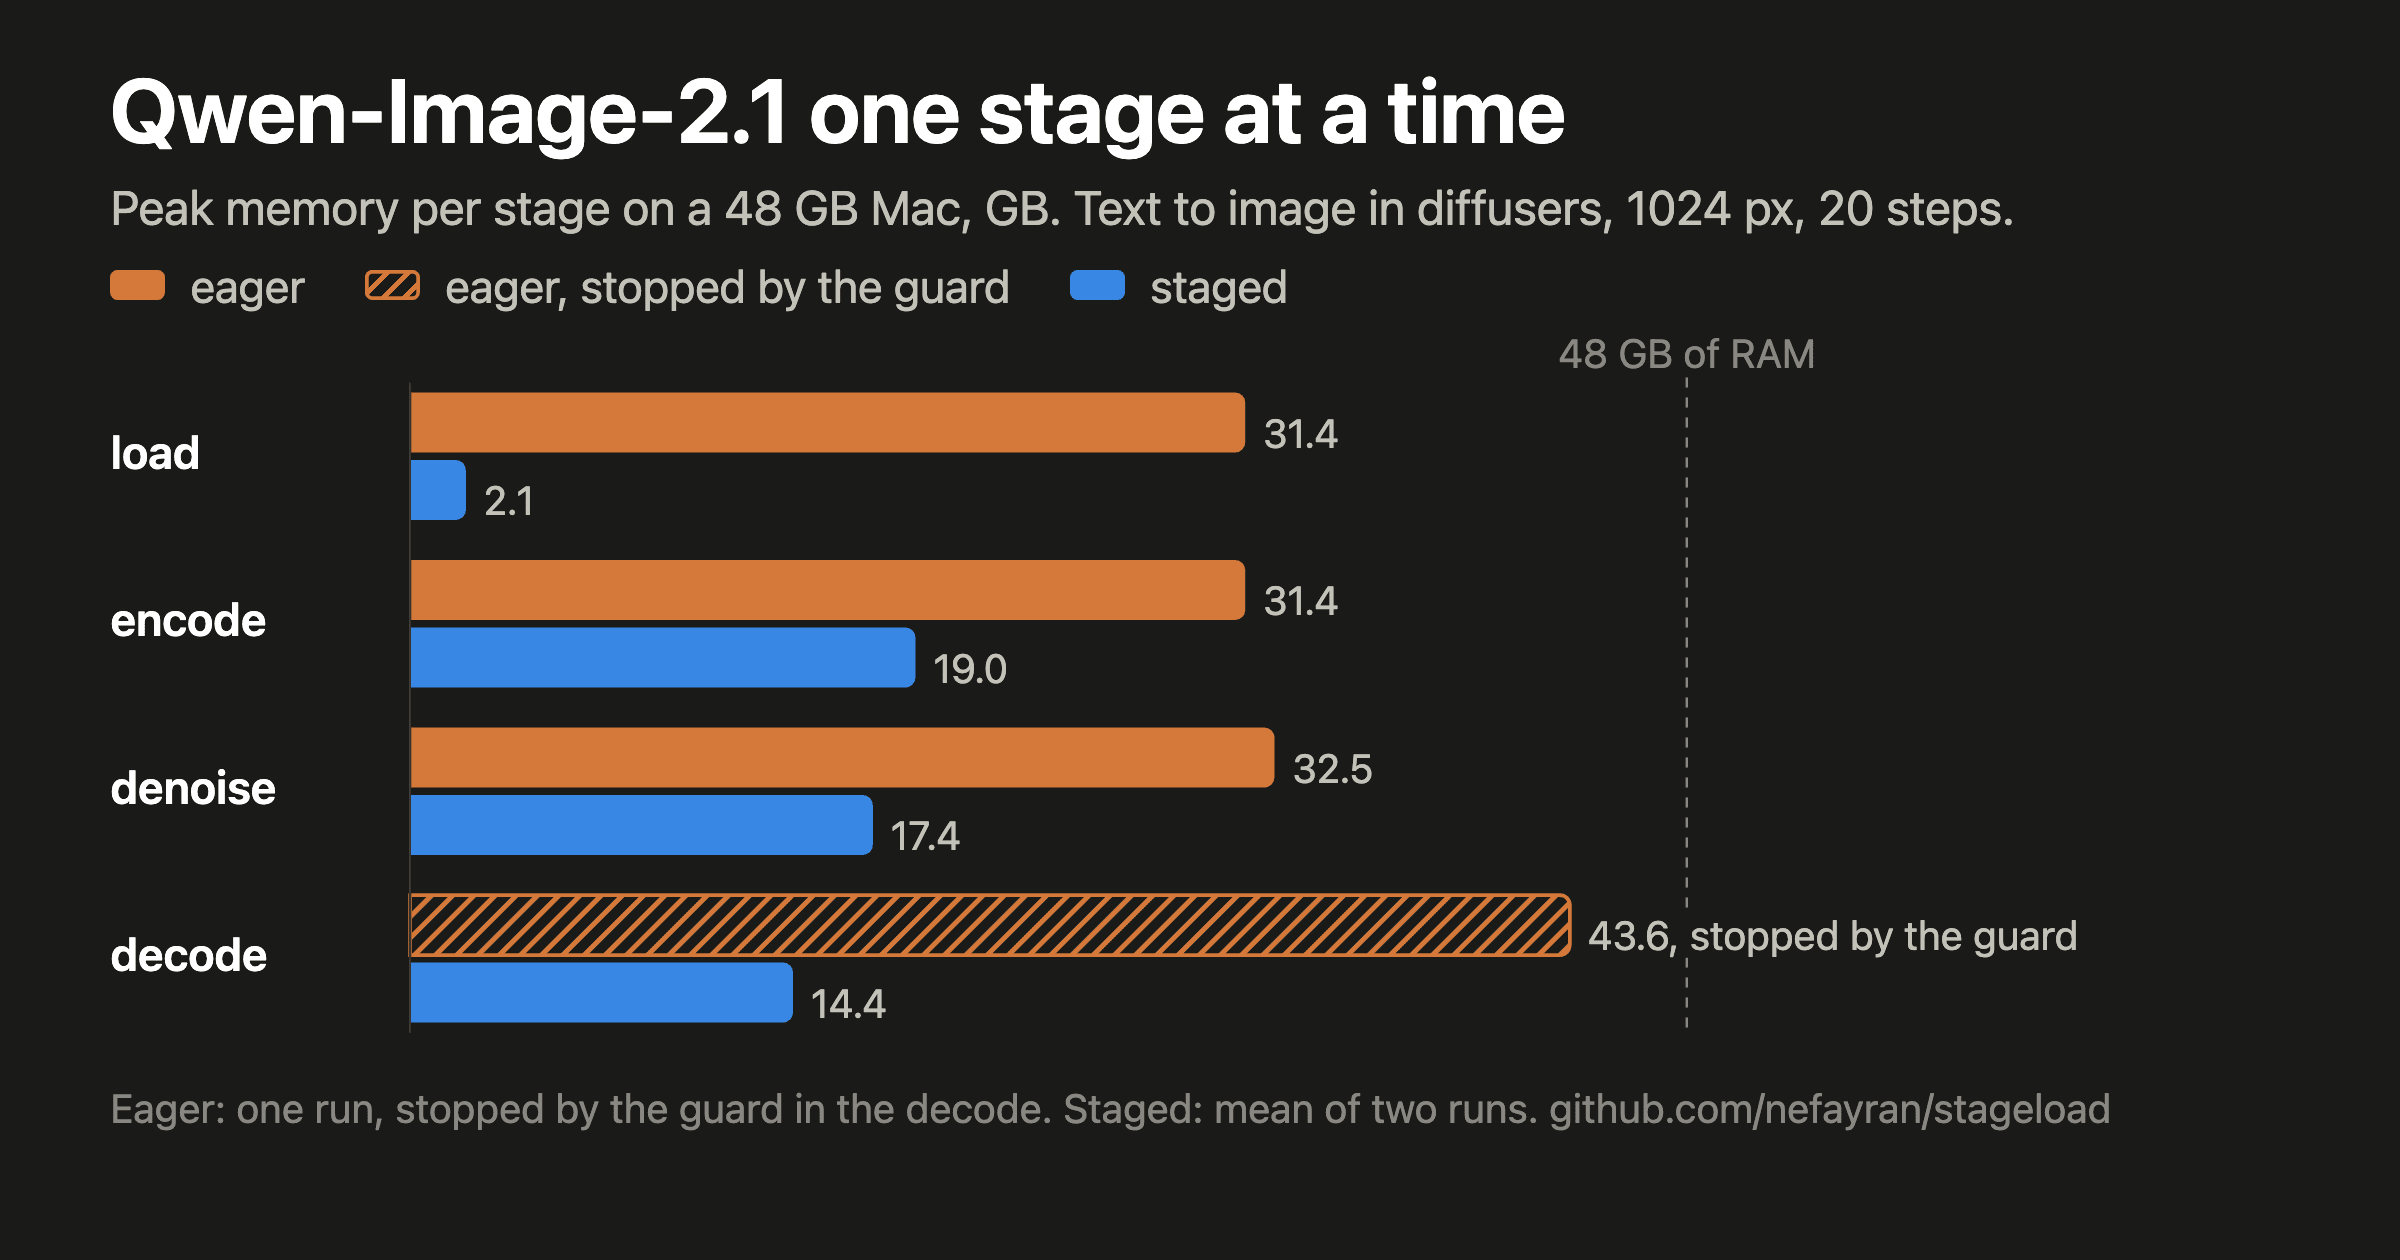
Qwen-Image-2.1 tahap demi tahap: pipeline kedua untuk stageload
Sebuah pipeline text-to-image di diffusers, dimuat dengan stageload di Mac 48 GB: eager mencapai 43,6 GB saat decode VAE dan penjaga memori menghentikannya, sedangkan staged tetap di 19,0 GB atau kurang tanpa mengubah kode pipeline.
Baca catatannya →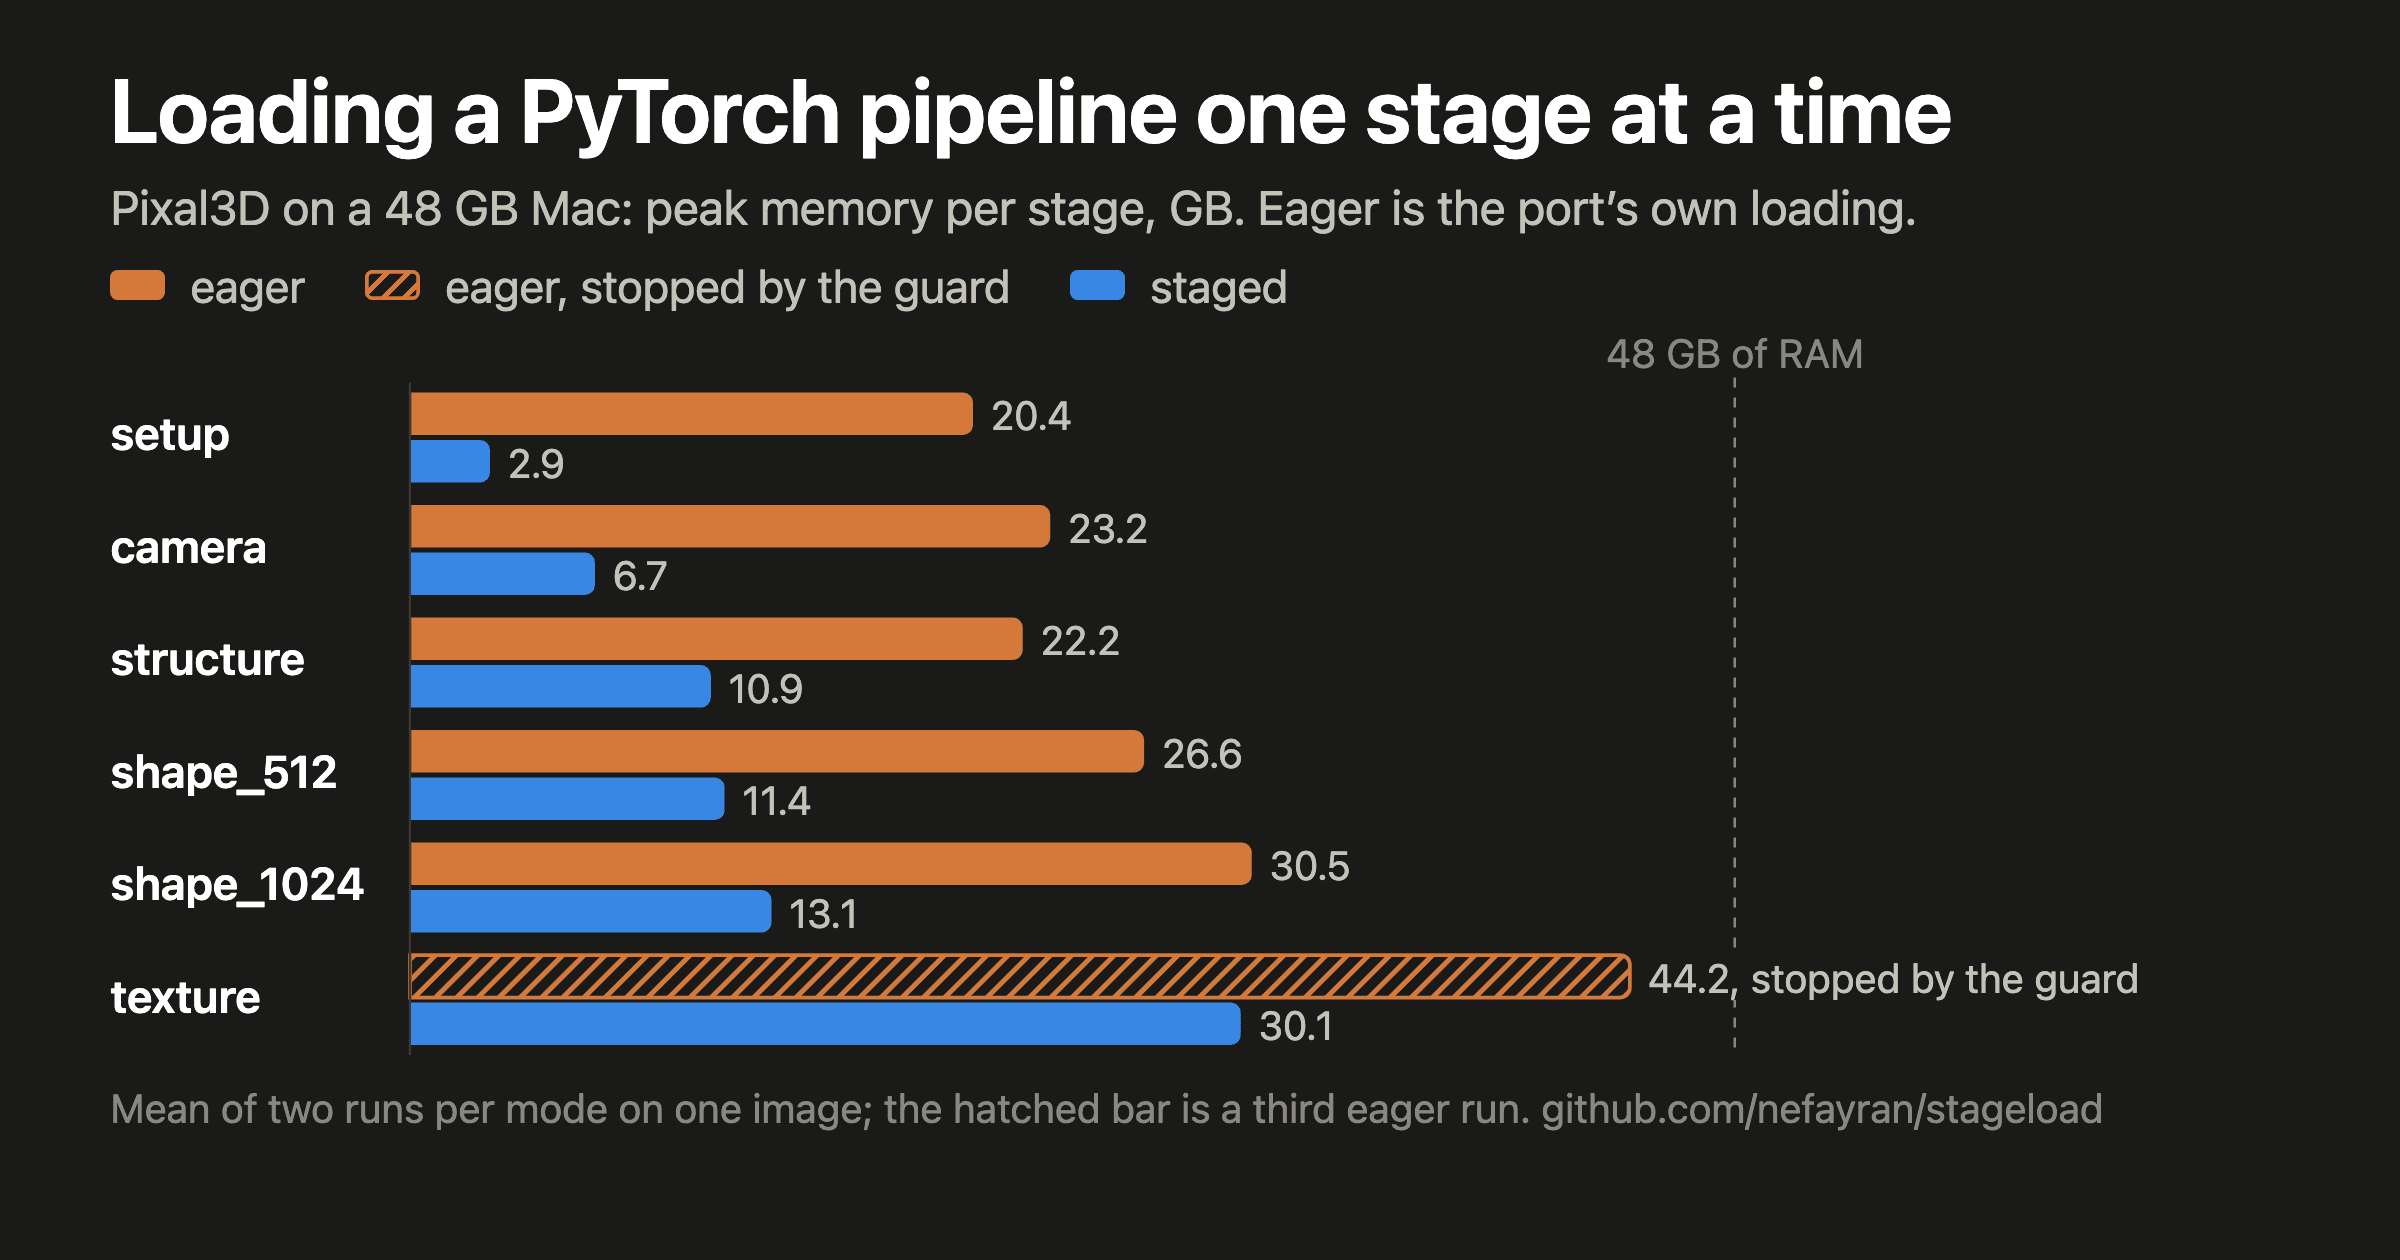
Memuat pipeline PyTorch tahap demi tahap: Pixal3D di Mac 48 GB
stageload memuat model sebuah tahap saat tahap itu dimulai dan melepaskannya saat tahap itu selesai, untuk pipeline PyTorch apa pun yang menjalankan modelnya bergiliran. Pada Pixal3D-mac di Mac 48 GB, cara ini menurunkan puncak sebesar 11 sampai 17 GB di setiap tahap yang dicapai kedua versi, sementara pemuatan bawaan port mendorong mesin ke swap sampai penjaga menghentikannya.
Baca catatannya →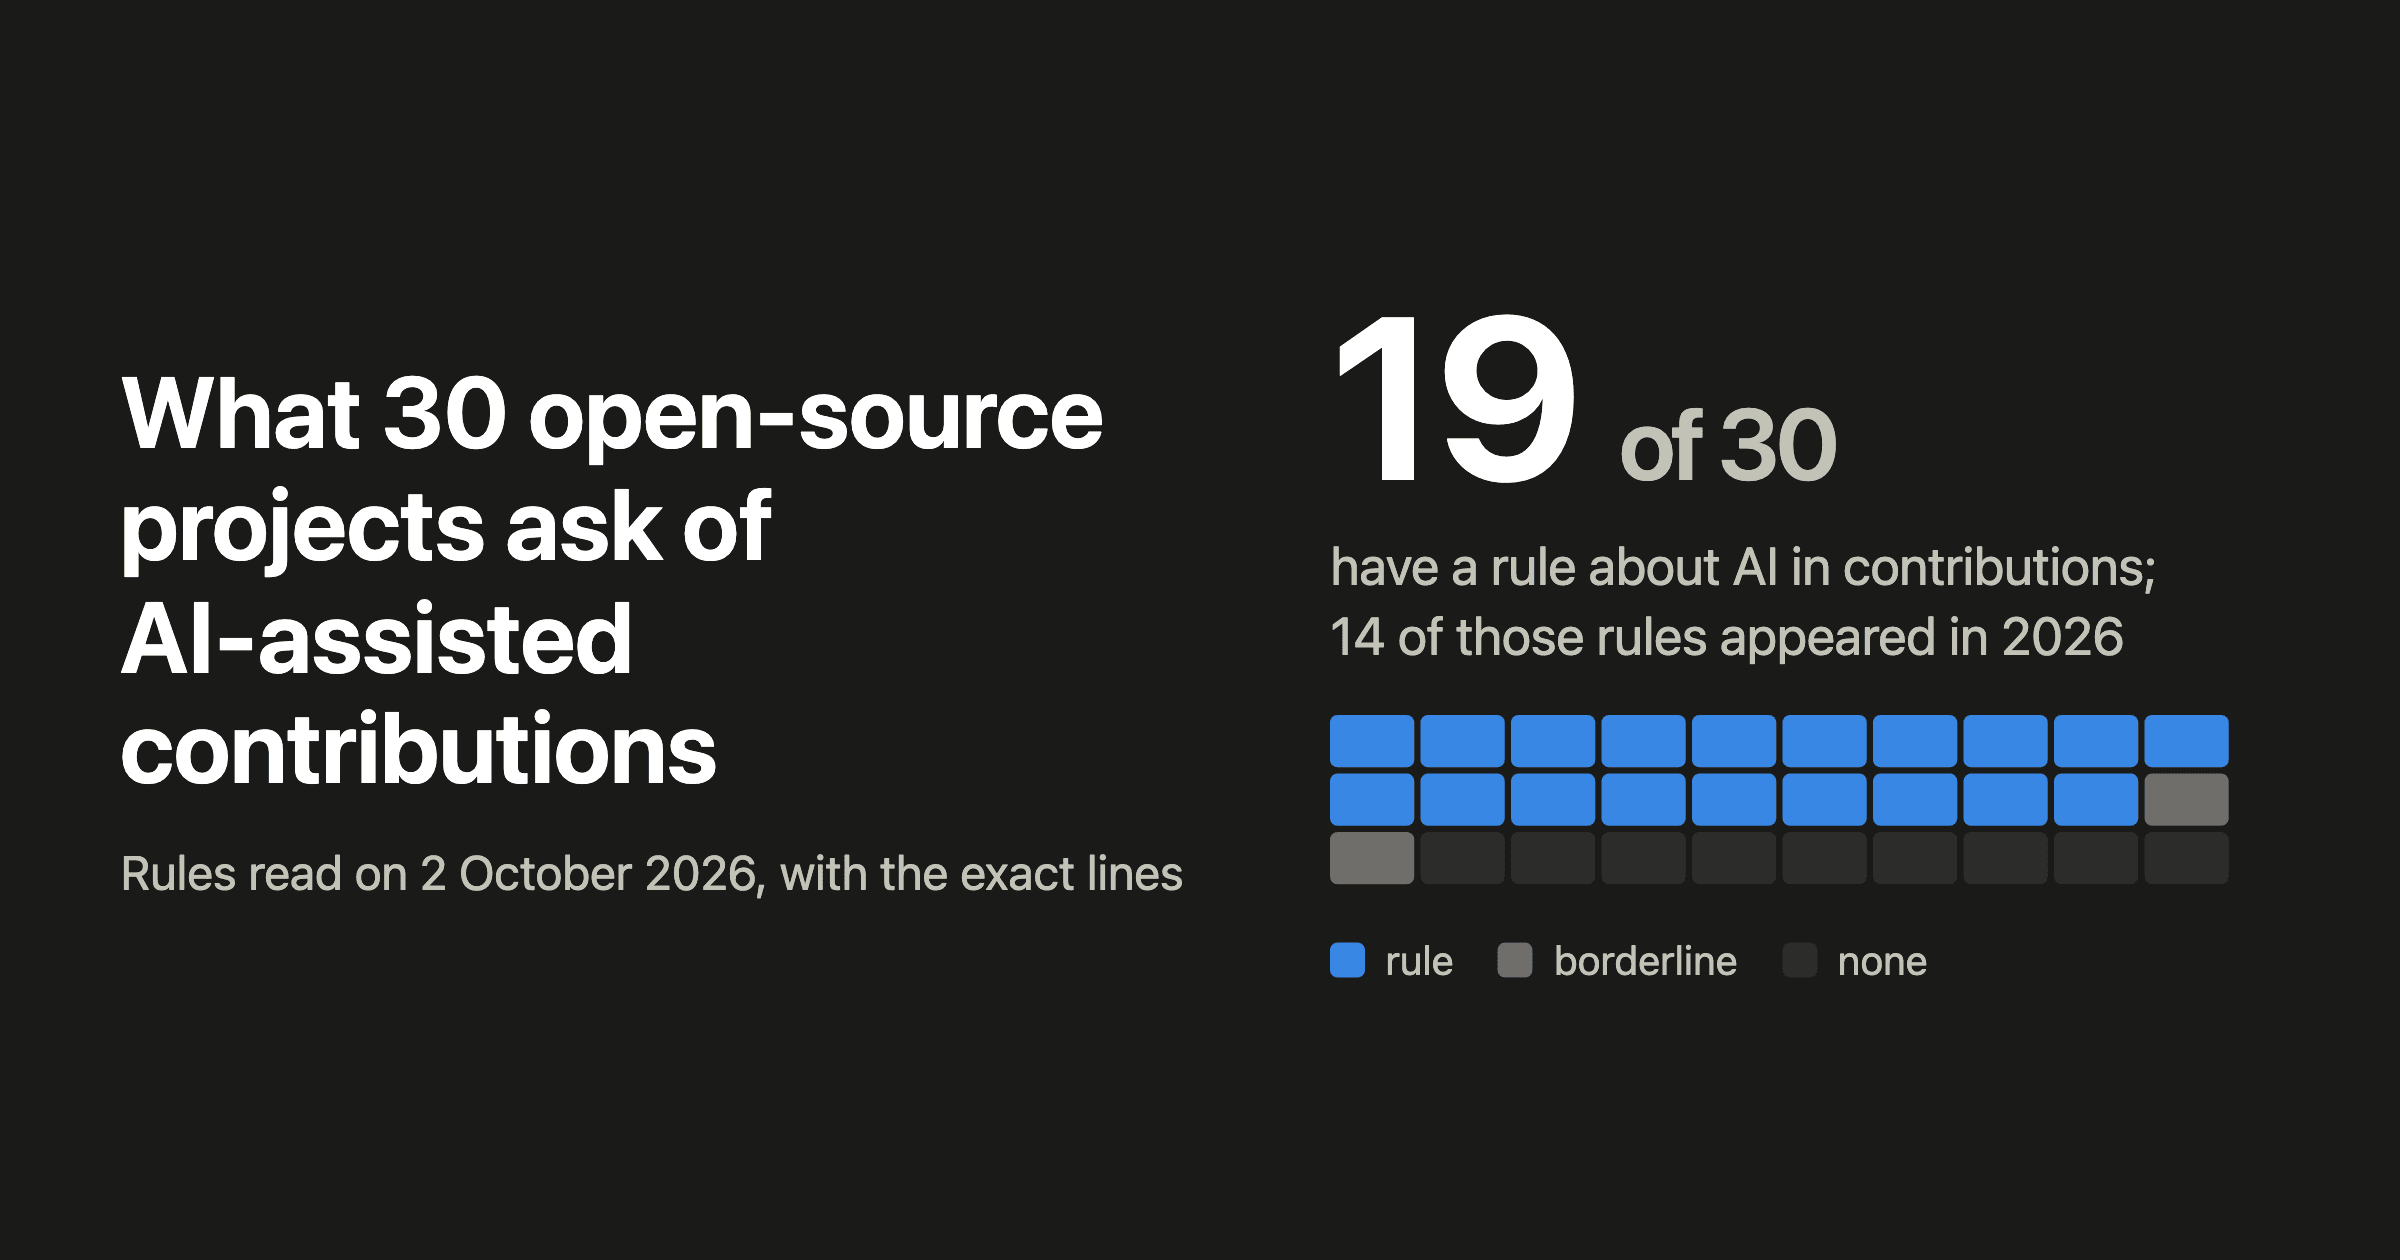
Apa yang diminta 30 proyek open source dari kontribusi yang dibantu AI
Pada 2 Oktober 2026 saya membaca aturan kontribusi di 30 repositori open source. 19 di antaranya punya aturan tentang AI, dan 14 dari aturan itu muncul pada 2026. Lima belas meminta Anda menyatakan bahwa Anda memakai AI, sepuluh ingin teksnya ditulis manusia, dan trailer commit yang ditambahkan agen coding secara bawaan diwajibkan oleh sebagian proyek dan dilarang oleh yang lain. Lalu, apa yang terjadi pada pekerjaan berbantuan agen yang saya kirim ke dua belas proyek pada minggu itu.
Baca catatannya →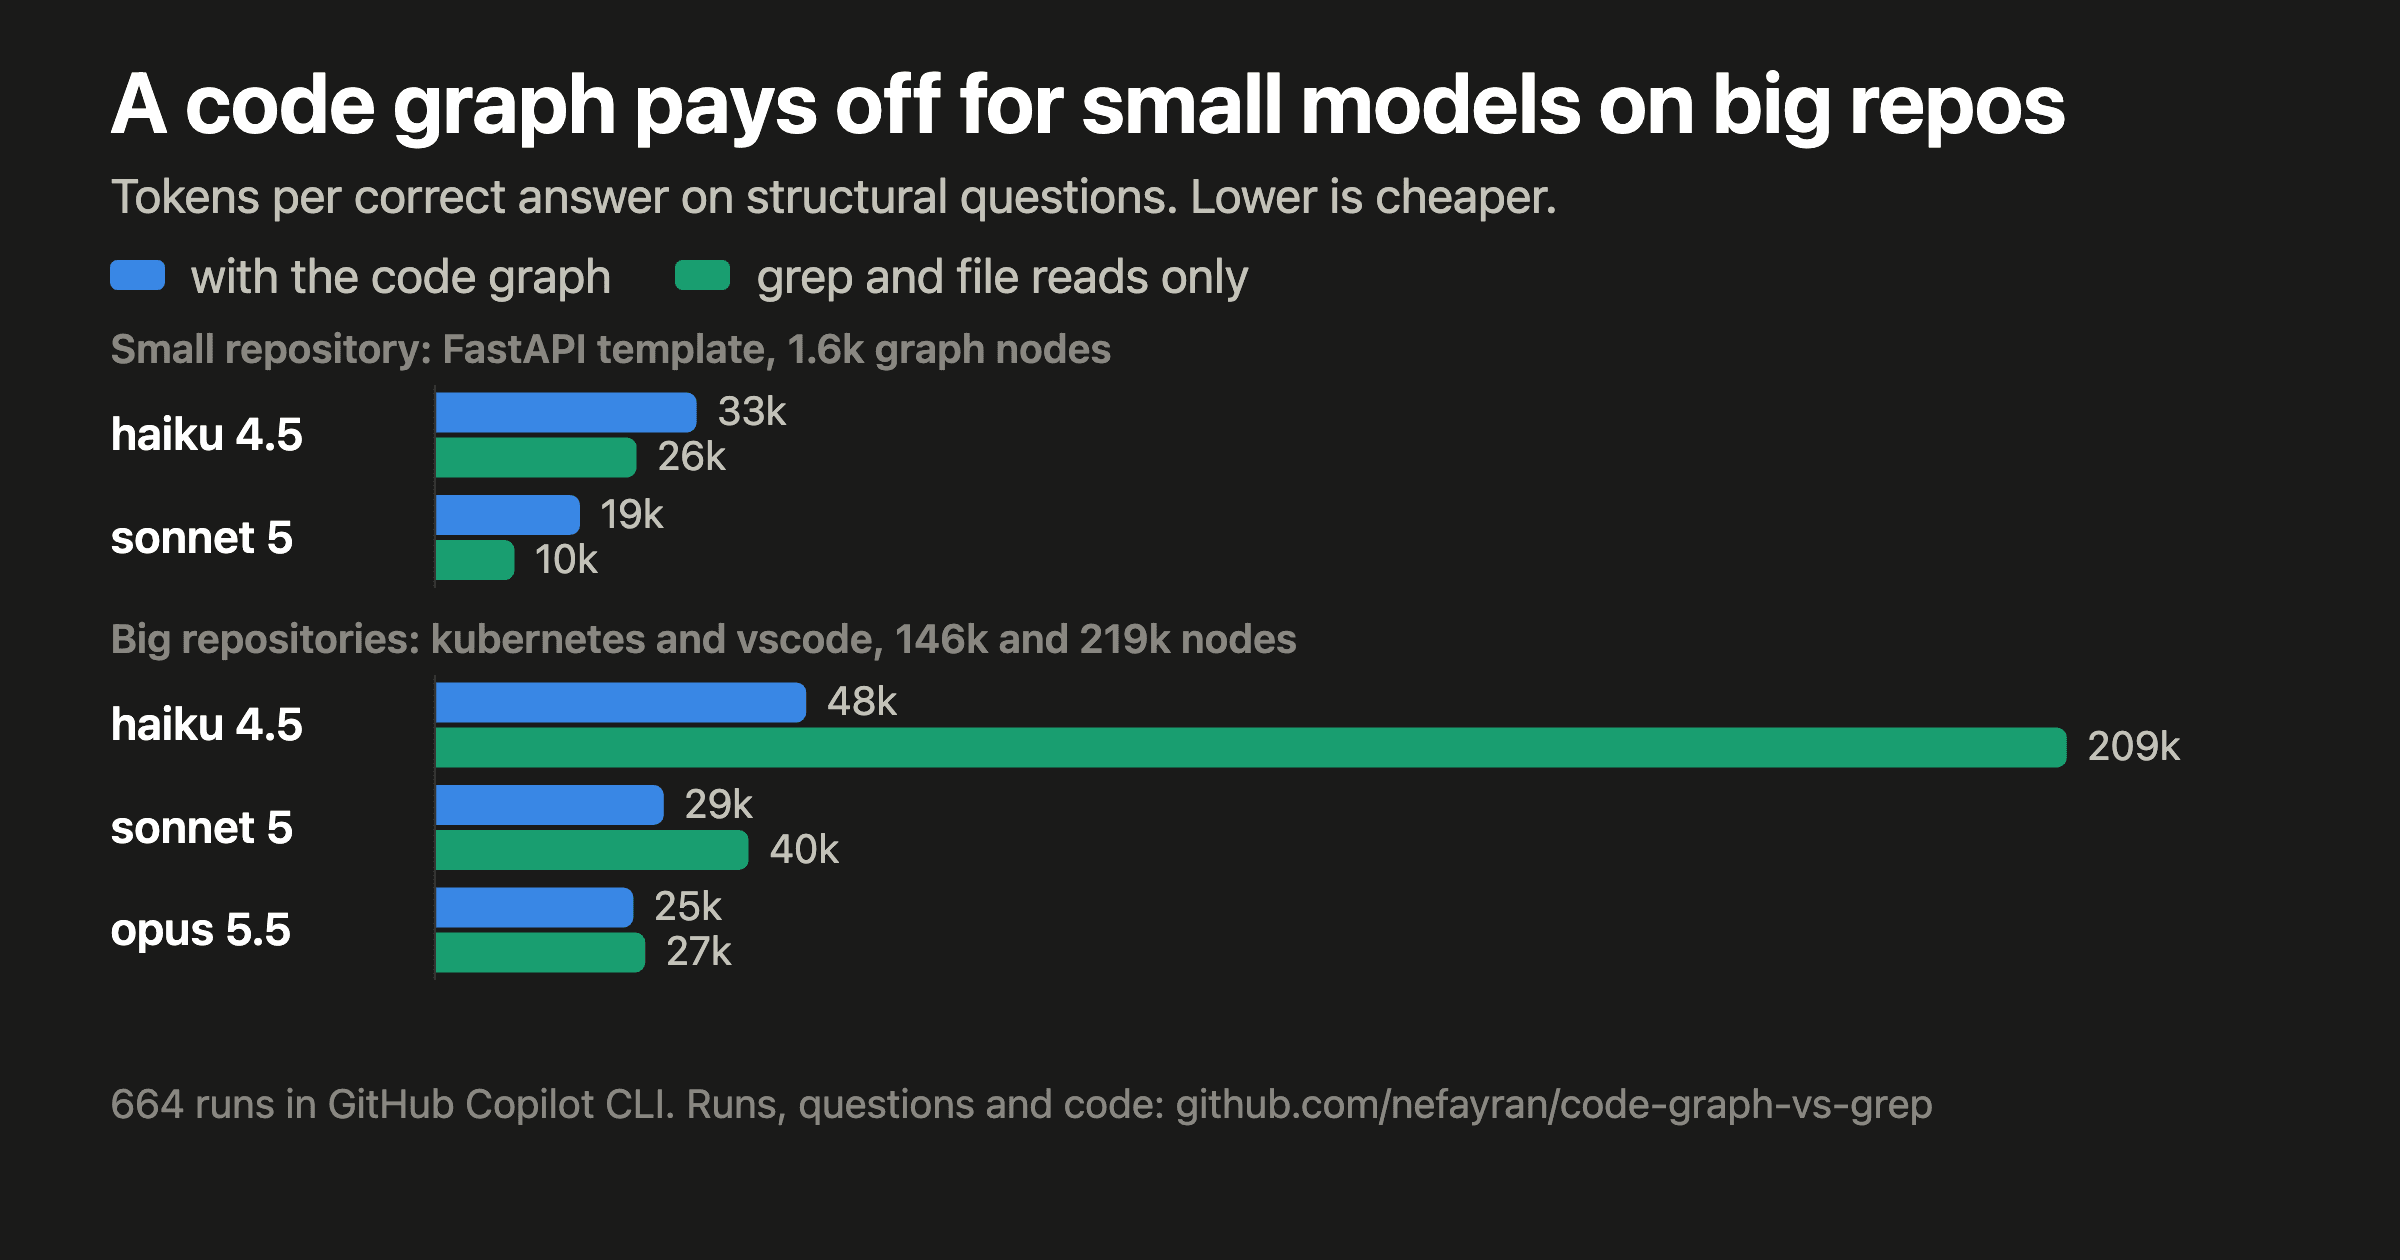
Kapan graf kode menguntungkan: repositori besar, model kecil
664 run headless di GitHub Copilot CLI pada empat repositori publik, dari 1,6 ribu hingga 219 ribu node graf, dengan haiku 4.5, sonnet 5, dan opus 5.5. Di kubernetes dan vscode, graf kode memangkas biaya haiku untuk pertanyaan struktural menjadi 0,29 dari biaya grep. Sonnet berhemat sekitar seperempat, opus tidak sama sekali, dan di repositori kecil graf membuat biaya sonnet 40 sampai 50% lebih tinggi.
Baca catatannya →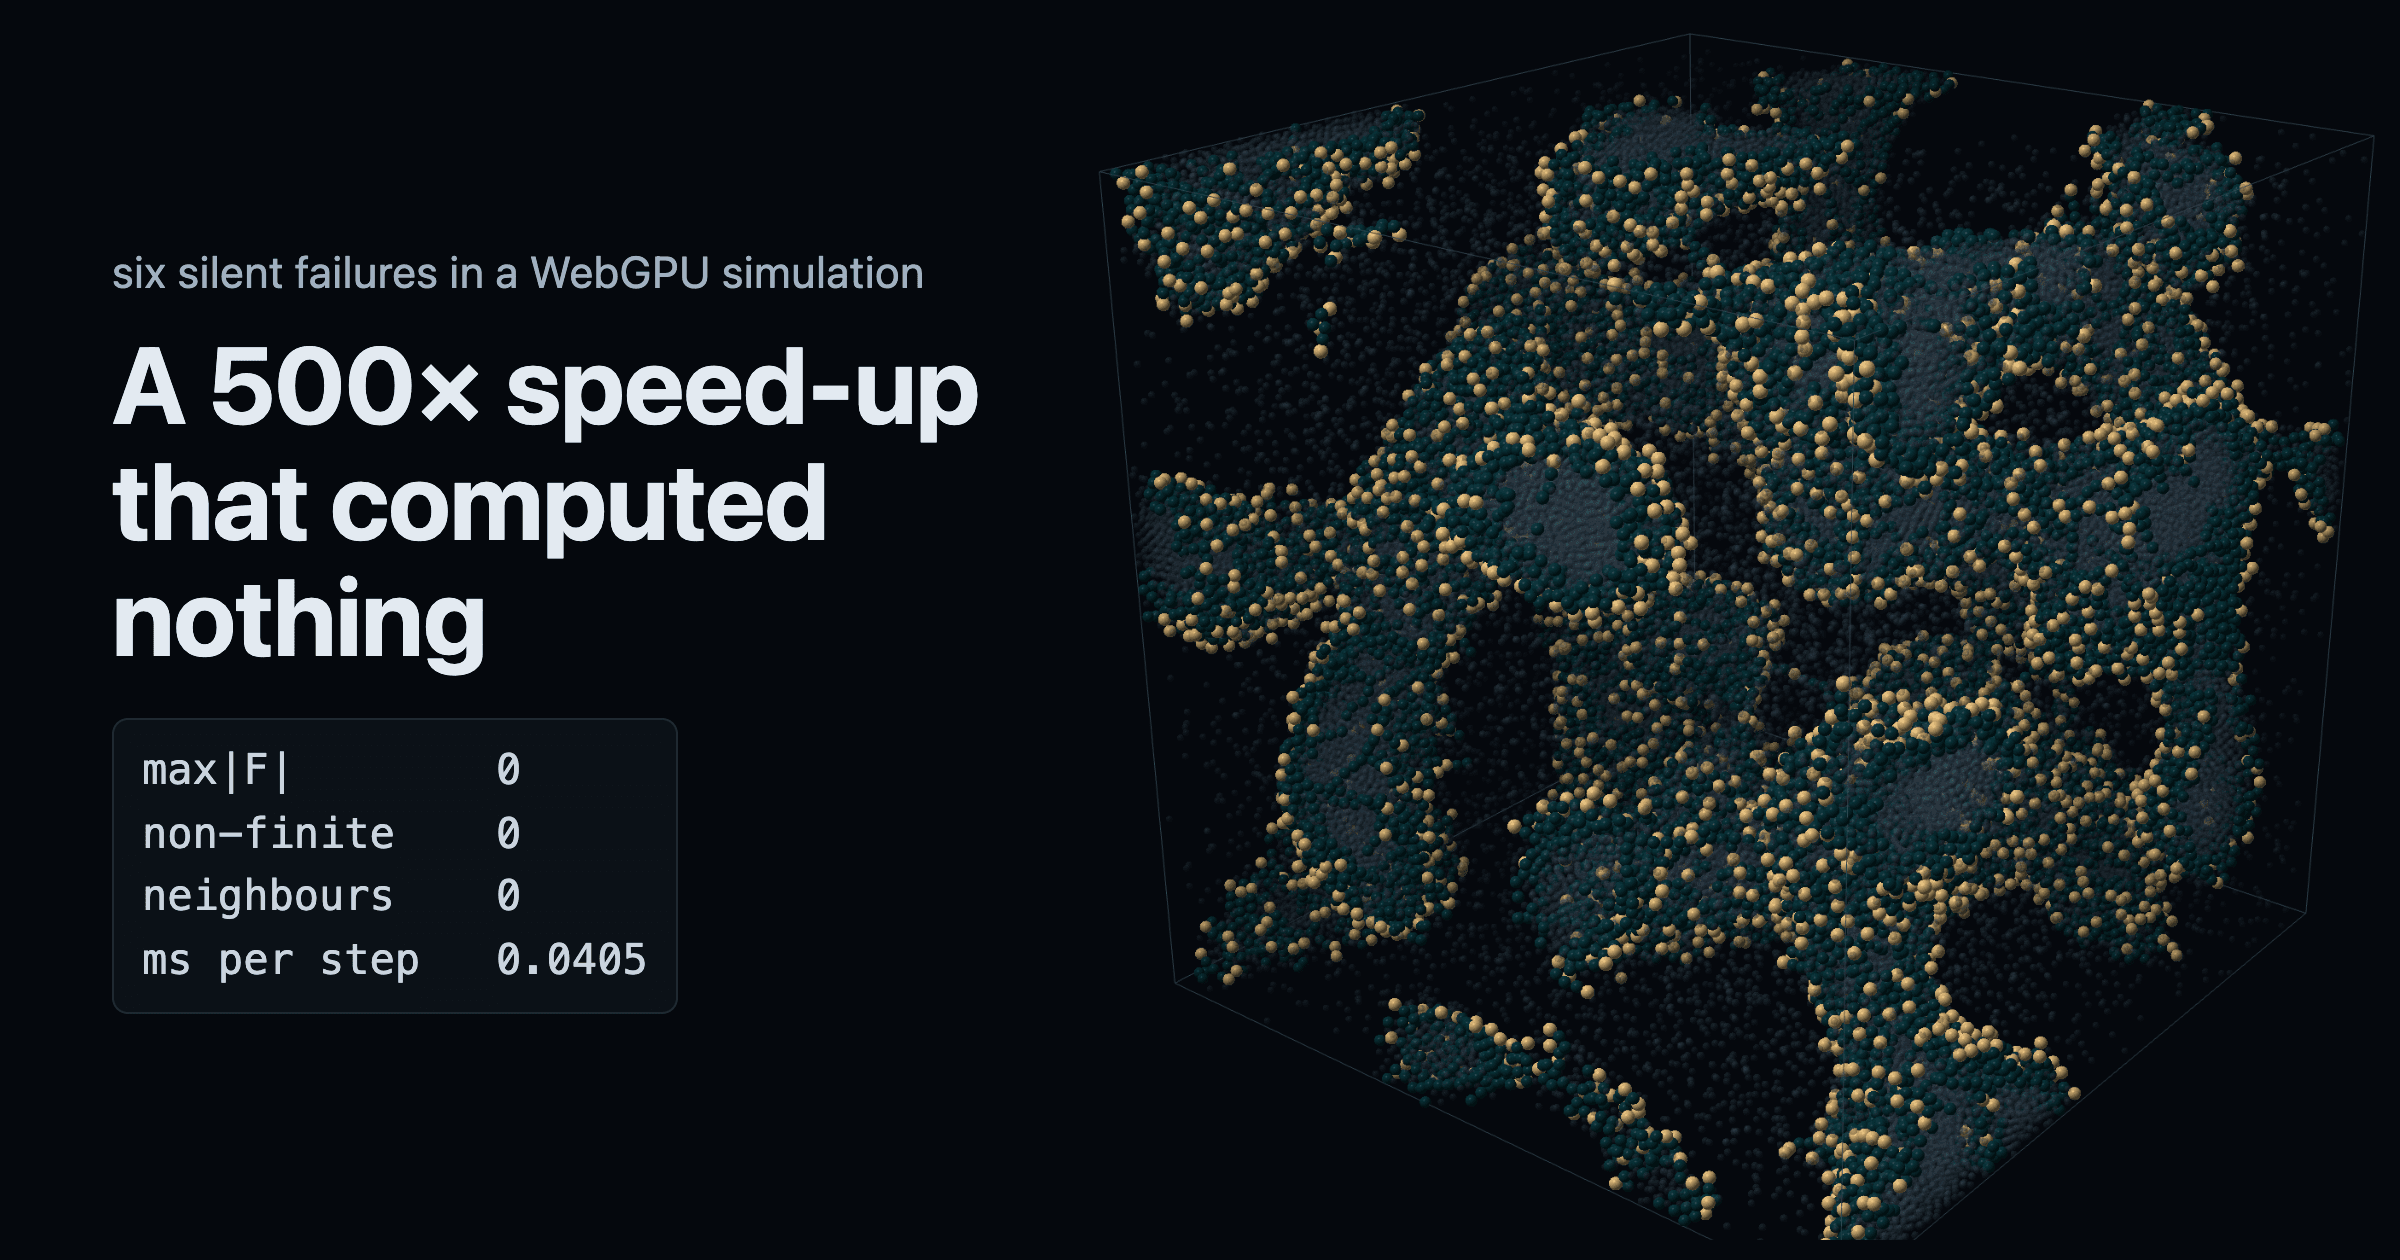
Percepatan 500× yang tidak menghitung apa pun: enam kegagalan senyap dalam simulasi WebGPU
Enam bug dalam simulasi partikel WebGPU tidak memunculkan satu error pun dan mengembalikan angka yang meyakinkan. Seperti apa masing-masing terlihat dan apa yang diubah.
Baca catatannya →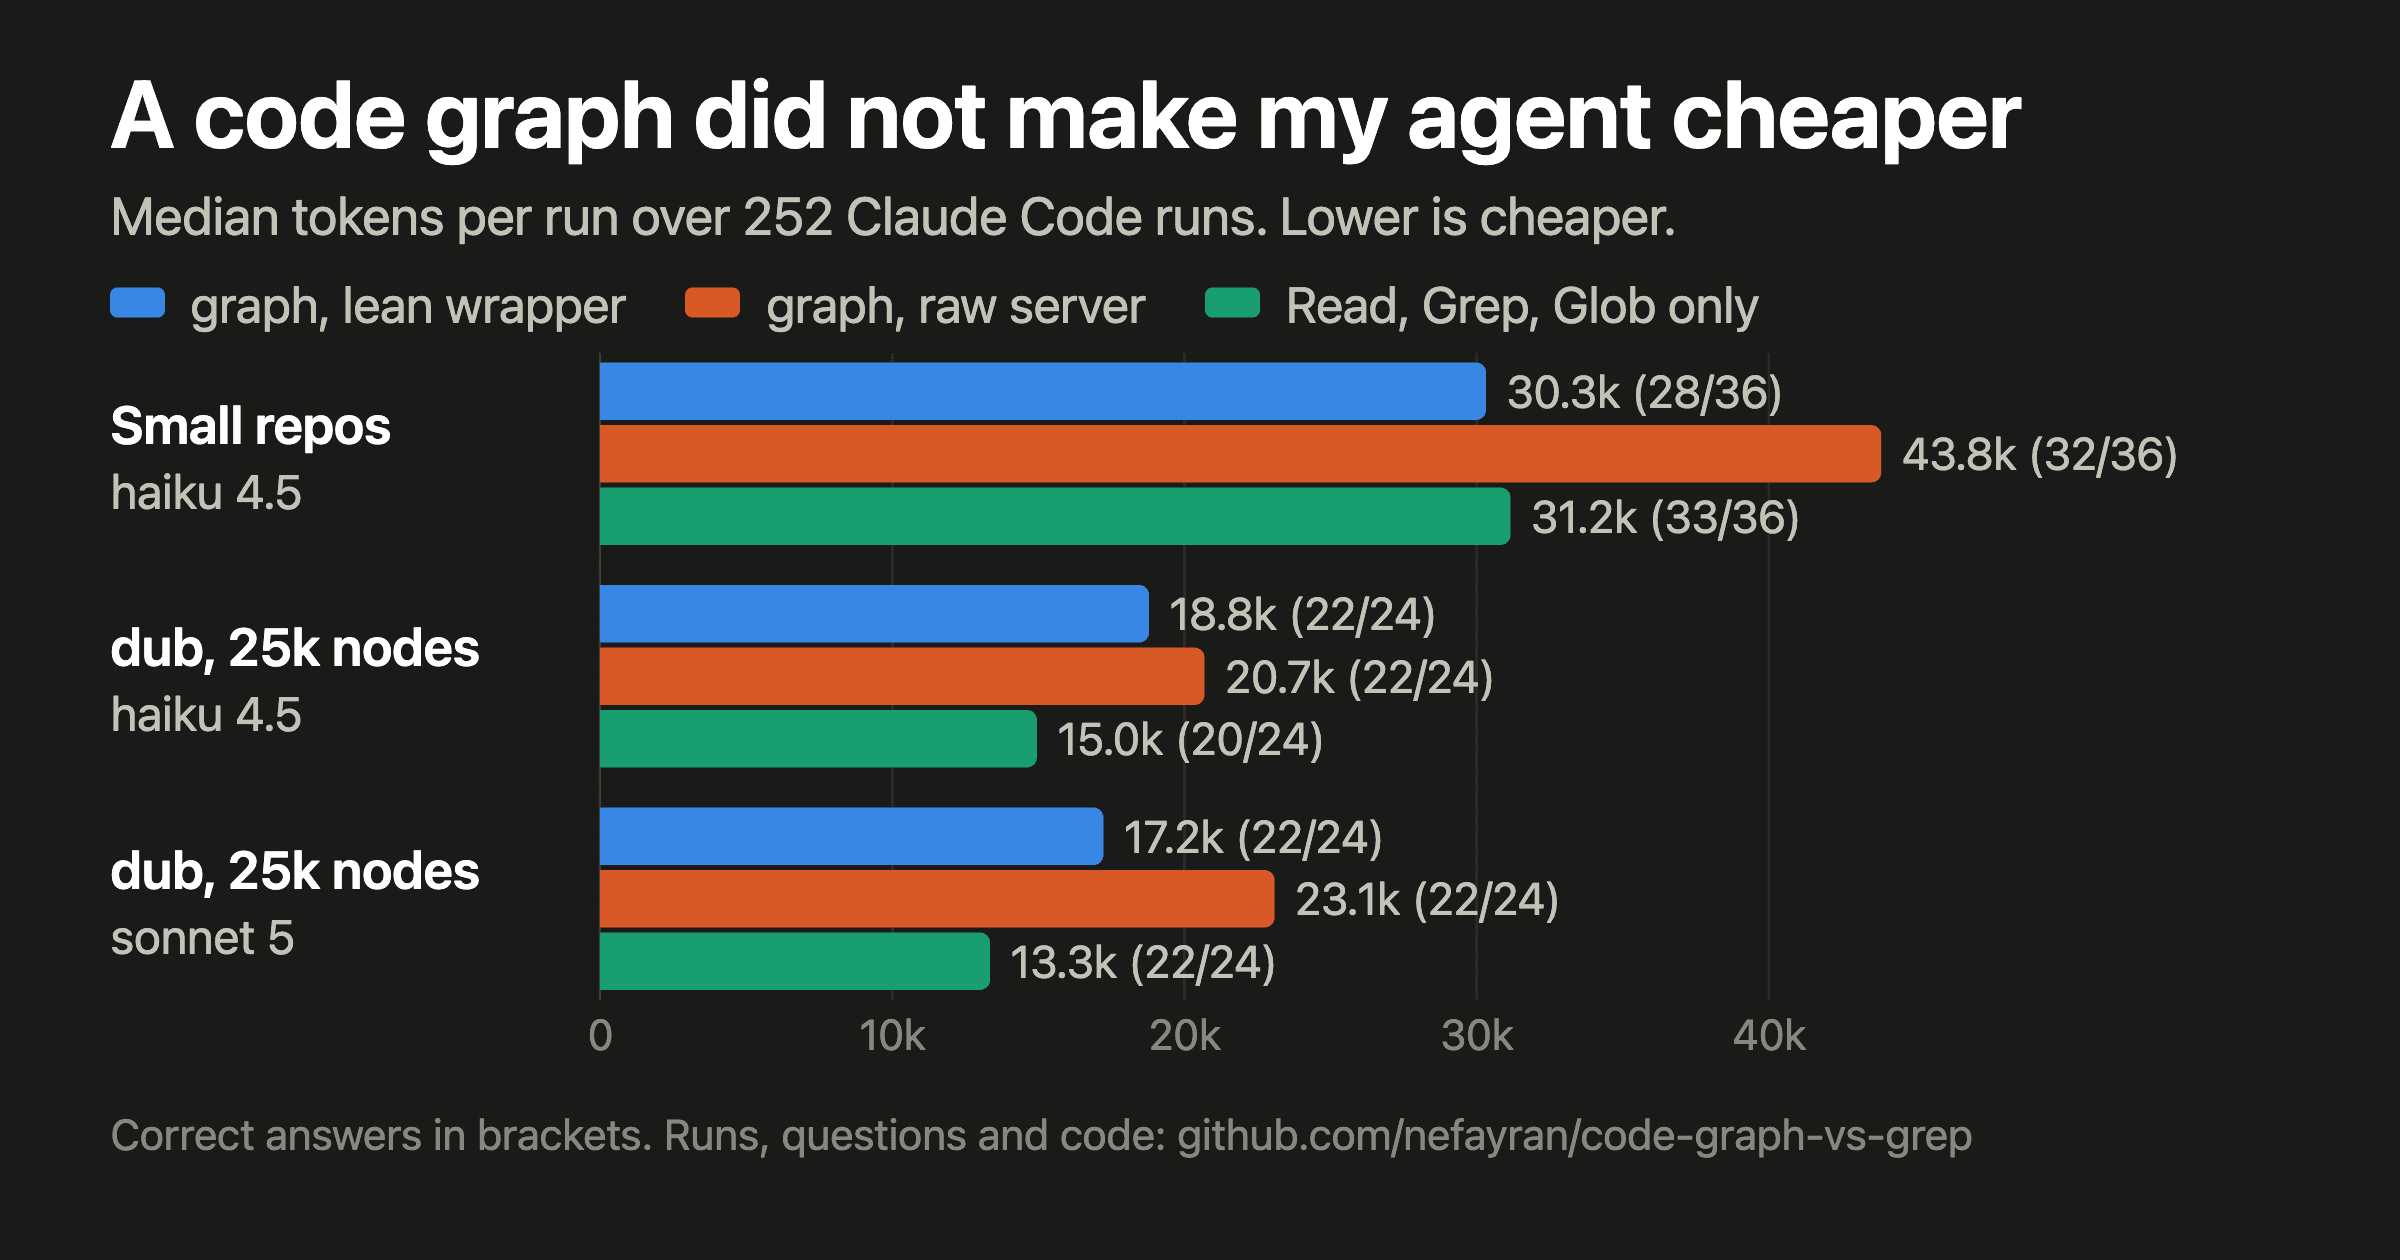
Graf kode tidak membuat agen coding saya lebih hemat
252 run Claude Code headless di repositori publik, dari 1,6 ribu hingga 25 ribu node graf, dengan haiku 4.5 dan sonnet 5. Dalam hal token, graf tidak pernah mengalahkan Read dan Grep, wrapper ramping selalu mengalahkan server graf mentah, dan dengan pengaturan bawaan agen hampir tidak memanggil graf.
Baca catatannya →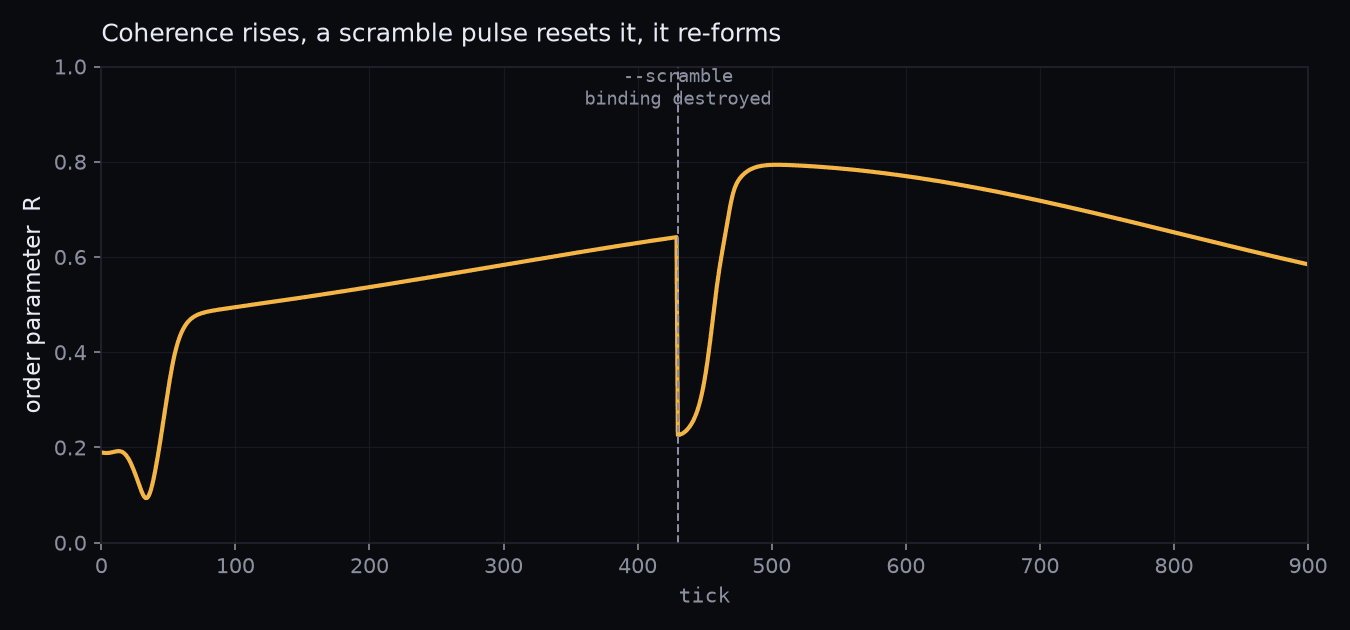
Osilator, Embedding, dan Kontrol yang Memergoki Kami Berbohong
Eksperimen 002 mengganti node bahasa dengan neuron-konsep yang menyala sefase dan terhubung lewat kemiripan embedding. Kontrol yang mengacak fase tetap menghasilkan bacaan yang runtut, jadi maknanya datang dari model yang membaca medan, bukan dari jaringannya.
Baca catatannya →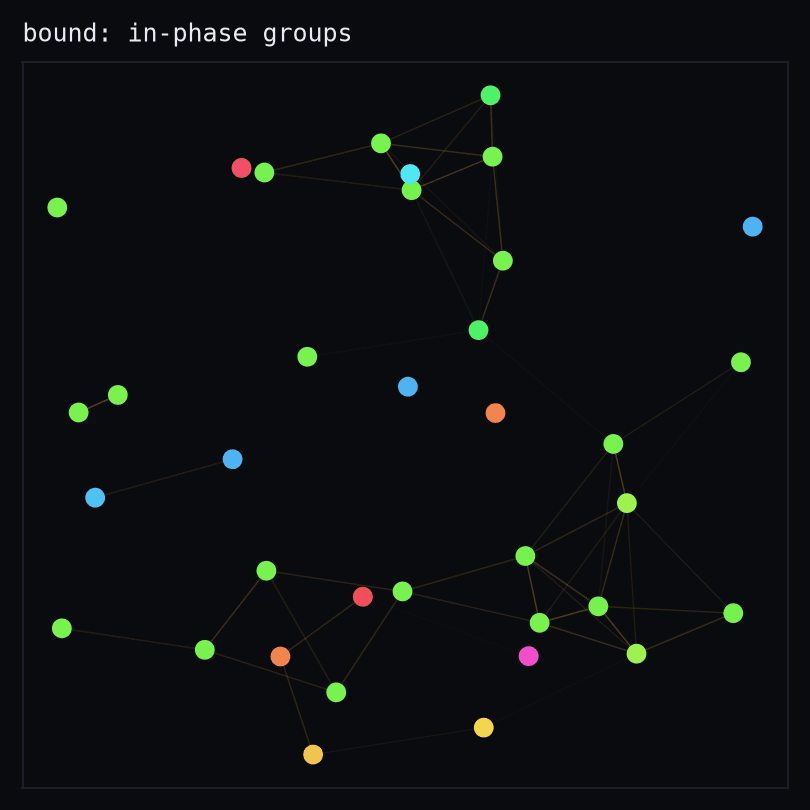
Kami Merangkai Model Bahasa Menjadi Satu Pikiran. Ia Runtuh Menjadi Satu Kalimat.
Delapan salinan dari satu model bahasa dipasang melingkar tanpa peran dan diminta melanjutkan pikiran satu sama lain. Mereka berkumpul pada satu kalimat dan terus mengulanginya: mode collapse. Sebuah hasil negatif.
Baca catatannya →