Pada 4 Oktober, sebuah run Pixal3D di Mac saya masuk ke tahap teksturnya, dan dalam sepuluh detik prosesnya membesar dari 27 menjadi 44 GB. Memori yang tersedia turun ke 6% dan swap bertambah 12 GB, sehingga penjaga yang saya pakai untuk menjalankan pekerjaan berat menghentikannya. Mac ini punya 48 GB. Sebelum saya punya penjaga itu, dua run Pixal3D, salah satunya berjalan berdampingan dengan pekerjaan berat lain, berakhir dengan Mac yang reboot.
Pixal3D mengubah satu gambar menjadi mesh 3D bertekstur, dan Pixal3D-mac adalah port-nya untuk Apple Silicon. Pipeline 1024_cascade menjalankan tujuh model secara berurutan: satu model flow dan satu decoder untuk struktur kasar, dua model flow untuk bentuk pada 512 dan 1024, satu decoder bentuk, serta satu model flow dan satu decoder untuk tekstur. Di sekitar model-model itu bekerja empat ekstraktor fitur gambar, satu penghapus latar belakang, dan satu estimator kamera. Setiap tahap membutuhkan satu atau dua dari ketujuh model itu, dan port tersebut menyimpan semuanya di memori dari detik pertama sampai detik terakhir.
Mengapa memorinya tidak kembali
Di Apple Silicon, CPU dan GPU berbagi satu pool memori. Mode low-VRAM milik Pixal3D, yang aktif secara bawaan, menyimpan model yang menganggur di CPU dan menyalin model yang aktif ke GPU. Di PC dengan kartu grafis terpisah, hal itu menghemat memori video. Di Mac, salinan CPU dan salinan GPU berada di RAM yang sama, sehingga mode itu membuat setiap model tetap berada di memori dan menambahkan salinan kedua dari model yang aktif. Keempat ekstraktor fitur itu juga memuat backbone DINOv3 yang sama, sebanyak empat kali.
Memuat tahap demi tahap
stageload adalah library kecil yang saya tulis untuk ini. Library ini mengganti dictionary model milik pipeline dengan dictionary yang memuat sebuah model saat pertama kali sebuah tahap memintanya, dan yang melepaskan setiap model yang tidak tercantum dalam daftar tahap berikutnya. Melepaskan berarti memindahkan setiap tensor modul itu ke perangkat meta milik PyTorch. Hal itu membebaskan storage-nya bahkan ketika kode lain masih memegang referensi ke modul tersebut, dan memanggil modul itu sesudahnya memunculkan error yang menyebutkan nama modul itu dan tahap yang melepaskannya, alih-alih gagal di suatu tempat di dalam PyTorch.
run() milik port itu sendiri dijalankan tanpa perubahan. stageload membungkus empat method milik pipeline untuk mengetahui di mana setiap tahap dimulai: penghapusan latar belakang, pengondisian gambar yang pertama, pengondisian setiap pass bentuk dan tekstur, dan decoding akhir. Keempat ekstraktor fitur dibangun agar berbagi satu backbone.
Satu bagian dari cara ini tidak memunculkan error ketika ada yang salah. Pixal3D menetapkan seed sekali di awal run, lalu mengambil derau setiap tahap dari generator bilangan acak CPU. Membangun sebuah model menjalankan inisialisasi acaknya, yang mengambil dari generator yang sama itu. Karena itu, model yang dibangun secara lazy di tengah run akan mengubah derau setiap tahap sesudahnya, dan dengan begitu juga mesh-nya. stageload menyimpan status generator-generator itu sebelum setiap pemuatan dan memulihkannya setelah itu: generator CPU, MPS, dan CUDA milik torch, random milik Python, dan generator global milik NumPy. Pada pipeline pengganti yang menetapkan seed dan mengambil derau dengan cara yang sama seperti port itu, sebuah tes memeriksa bahwa run staged dan run eager menghasilkan latent yang sama bit demi bit, dan sebuah kontrol yang mematikan pemulihan itu melihat keduanya menyimpang satu sama lain.
Bukan hanya untuk Pixal3D
Inti stageload tidak tahu apa-apa tentang Pixal3D. Dari sebuah pipeline, ia hanya butuh tiga hal: fungsi yang membangun setiap model secara terpisah, daftar model yang dipakai setiap tahap, dan satu panggilan di tempat setiap tahap dimulai. Di kode milik sendiri, panggilan itu cukup satu baris: models.enter("decode"). Di kode orang lain, seperti port ini, on_call memasangnya pada metode yang memang sudah berjalan di titik itu, sehingga pipeline-nya sendiri tetap apa adanya. Pipeline text-to-image punya bentuk yang sama dengan Pixal3D: encoder teks, denoiser, dan decoder gambar berjalan berurutan. Pengukur memori dan penjaga bisa dipakai untuk program apa pun di Mac. Sejauh ini, Pixal3D adalah satu-satunya pipeline yang saya ukur; README menunjukkan intinya pada pipeline kecil dengan dua model, dan contoh itu dijalankan sebagai tes.
Apa yang diubahnya
Di M5 Pro dengan 48 GB ini, saya menjalankan gambar contoh milik port itu melalui 1024_cascade dengan seed 7 dan tekstur 2048 piksel, dua run per mode, masing-masing dalam prosesnya sendiri, lewat penjaga. “Eager” adalah cara pemuatan milik port itu sendiri, dan “staged” adalah stageload. Di mesin ini, run eager tidak bisa melewati tahap tekstur dalam batas-batas penjaga, jadi kedua run eager berhenti di awal tahap itu. Angka tekstur untuk eager berasal dari run pada 4 Oktober yang masuk ke tahap tersebut.
| tahap | eager, footprint puncak | staged, footprint puncak |
|---|---|---|
| setup | 20,4 GB | 2,9 GB |
| camera | 23,2 GB | 6,7 GB |
| structure | 22,2 GB | 10,9 GB |
| shape_512 | 26,6 GB | 11,4 sampai 11,5 GB |
| shape_1024 | 30,5 GB | 13,1 GB |
| texture | dihentikan penjaga pada 44,2 GB | 30,1 GB |
| decode | tidak tercapai | 17,9 sampai 18,4 GB |
| export | tidak tercapai | 69,6 sampai 70,2 GB |
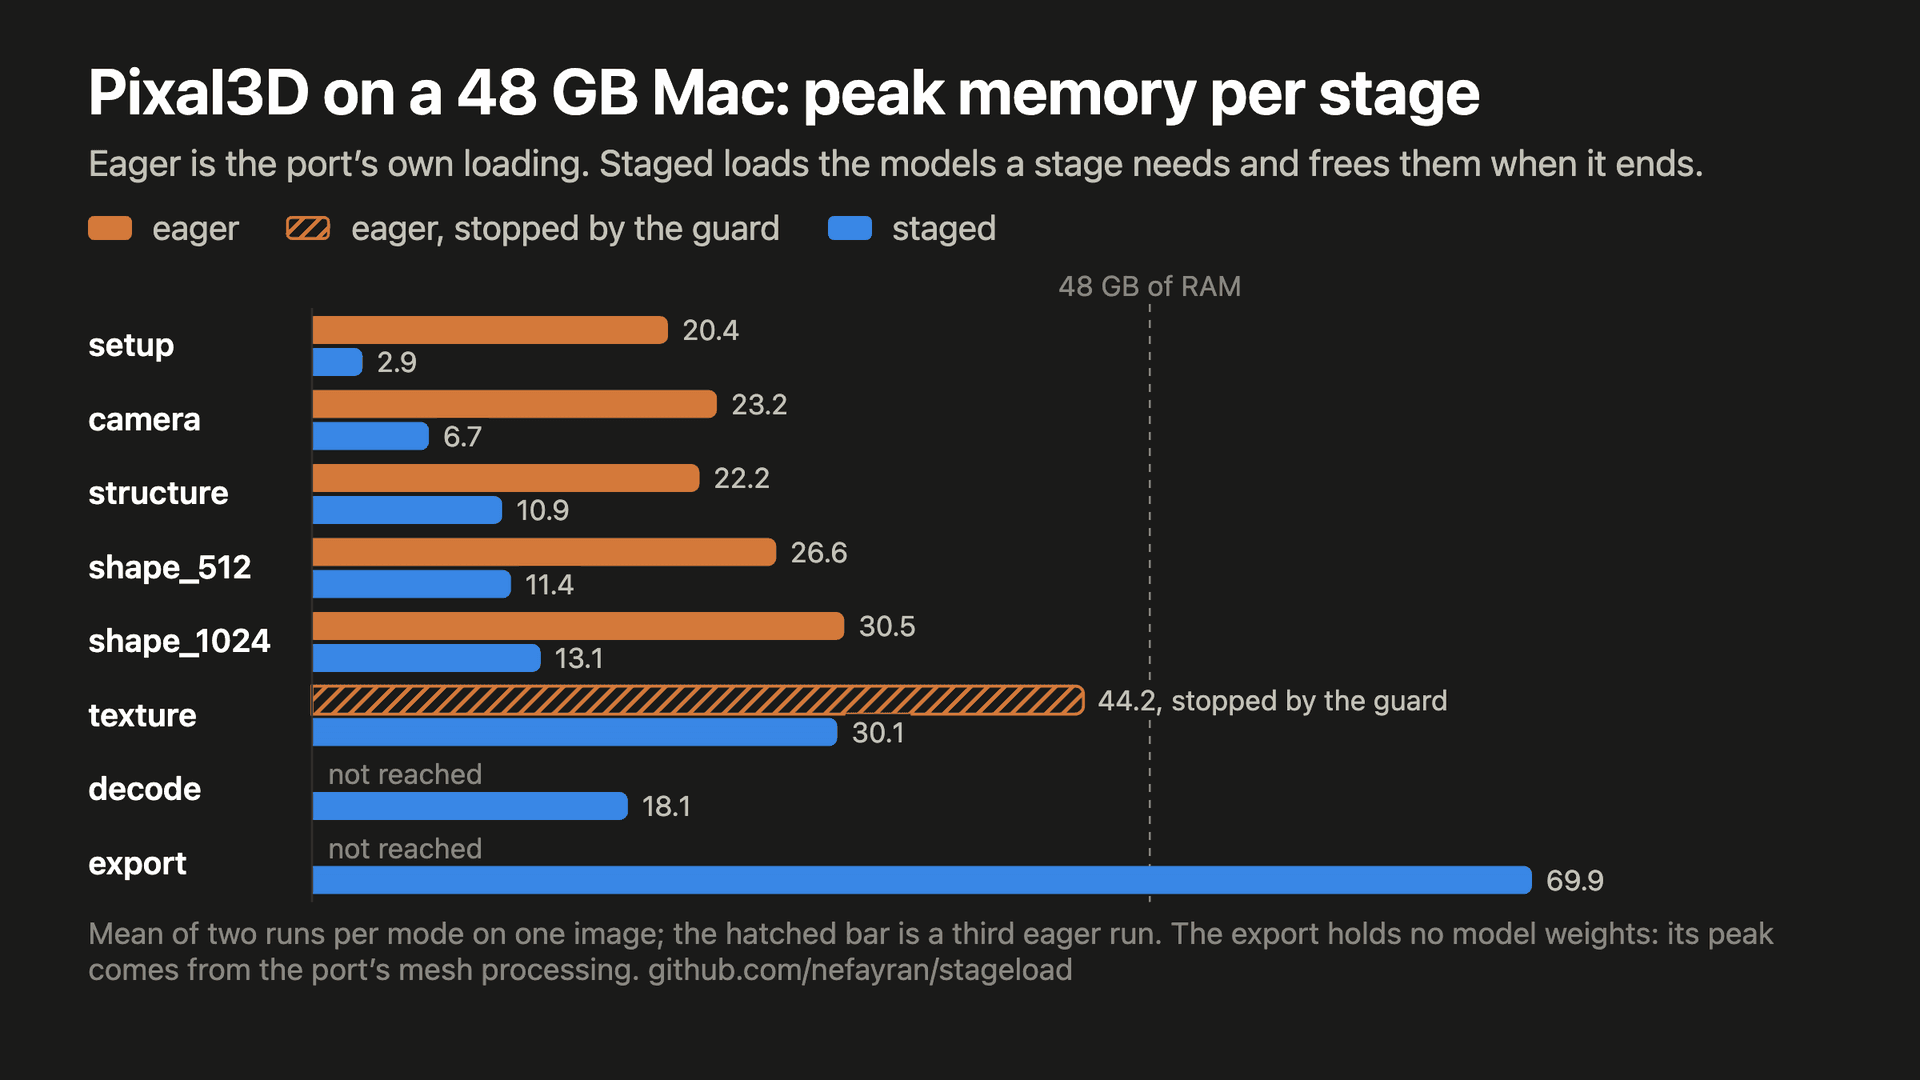
Di setiap tahap yang dijalankan kedua mode, staged memakai 11,3 sampai 17,5 GB lebih sedikit. Kedelapan pemuatan, yaitu ketujuh model ditambah decoder bentuk sekali lagi untuk decoding, membaca 13,2 GB dalam 24 detik dari sekitar sepuluh menit per run.
Sebagian besar dari 30 GB di tahap tekstur adalah memori kerja: model teksturnya sendiri berukuran 2,6 GB. Saat decoding dimulai, stageload melepaskannya bersama ekstraktor fitur dan mengosongkan cache alokator MPS, dan dalam dua detik footprint turun menjadi 4,5 GB di satu run dan 8,0 GB di run yang lain.
Angka staged tertinggi, sekitar 70 GB, muncul saat ekspor, setelah semua bobot model dilepaskan. Itu adalah pemrosesan mesh milik port tersebut (remeshing, UV unwrapping, baking), yang tidak disentuh stageload. Footprint adalah angka yang ditampilkan Activity Monitor, dan angka itu ikut menghitung memori yang sudah dikompresi macOS, sehingga bisa lebih besar daripada RAM 48 GB.
Yang tidak bisa saya tunjukkan
Yang pertama adalah apakah pemuatan staged mengubah hasilnya. Setiap run menyimpan hash dan salinan keluaran setiap sampler. Latent pertama, yaitu struktur kasar, sama bit demi bit di keempat run. Mulai dari tahap bentuk 512, port itu tidak mengulang hasilnya sendiri di MPS, bahkan dengan seed yang sama: kedua run eager berbeda hingga 1,77 pada latent bentuk, dan sebuah run staged berbeda dari run eager sebesar 1,24 sampai 1,86. Jadi perbandingan ini mengatakan bahwa perubahan apa pun akibat pemuatan staged tidak lebih besar daripada variasi milik port itu sendiri, yang diukur pada satu-satunya pasangan run eager tersebut. Latent tekstur dan mesh akhir sama sekali tidak dibandingkan, karena di sini run eager tidak pernah mencapainya.
Membangun di CPU tidak membantu. stageload membangun setiap model langsung di GPU, dan itu mengubah satu tensor yang tidak dicakup checkpoint: frekuensi rotary dari sparse attention, yang dihitung saat model dibangun, berbeda hingga 6e-8. Untuk melihat apakah itu yang menjelaskan perbedaannya, saya menjalankan satu pass staged yang membangun setiap model di CPU lalu memindahkannya ke GPU, seperti yang dilakukan port itu. Latent-nya berbeda dari run eager sebesar 1,84 dan 1,12, dalam orde yang sama dengan setiap pasangan lainnya. Pemuatan memakan 82 detik, bukan 24 detik, dan tiga tahap memuncak 2,6 sampai 3,8 GB lebih tinggi, sementara dua tahap hasilnya lebih rendah. Saya kembali membangun di GPU.
Ringkasan saya sendiri punya bug yang menggelembungkan satu angka. Ringkasan itu mengambil puncak setiap tahap sejak saat tahap itu tercatat dimulai, tetapi melepaskan model-model tahap sebelumnya memakan waktu hingga 1,7 detik. Satu sampel memori di celah itu membuat puncak decode pada run yang dibangun di CPU tercatat 29,5 GB; jika dihitung dari selesainya pelepasan, angkanya 16,7. Sebuah code review menemukannya. Sekarang jendela sebuah tahap dimulai ketika pelepasan yang dipicu oleh awal tahap itu sudah selesai.
Penjaga
Run-run ini dijalankan lewat bagian kedua dari stageload, stageload guard, karena pekerjaan berat lain juga berjalan di Mac ini. Penjaga ini menjalankan satu perintah hanya jika memori yang tersedia cukup dan sudah beberapa waktu tidak terlihat satu pun proses yang cocok dengan daftar pekerjaan berat. Selama perintah itu berjalan, penjaga menghentikan seluruh grup proses milik perintah itu jika swap bertambah melewati anggaran atau memori yang tersedia bertahan di bawah 10%. Penjaga ini tidak butuh root, dan satu-satunya proses yang pernah dihentikannya adalah proses yang ia mulai sendiri.
Masa tunggu sampai keadaan sepi itu berasal dari sebuah kegagalan. Serangkaian pekerjaan video menyisakan jeda pendek di antaranya, sebuah run dimulai di salah satu jeda itu, dan pekerjaan video berikutnya mendorong swap melewati anggaran dalam 20 detik. Dalam benchmark ini, setiap run baru dimulai setelah tiga menit tanpa satu pun pekerjaan berat yang terlihat.
Pada gambar lain
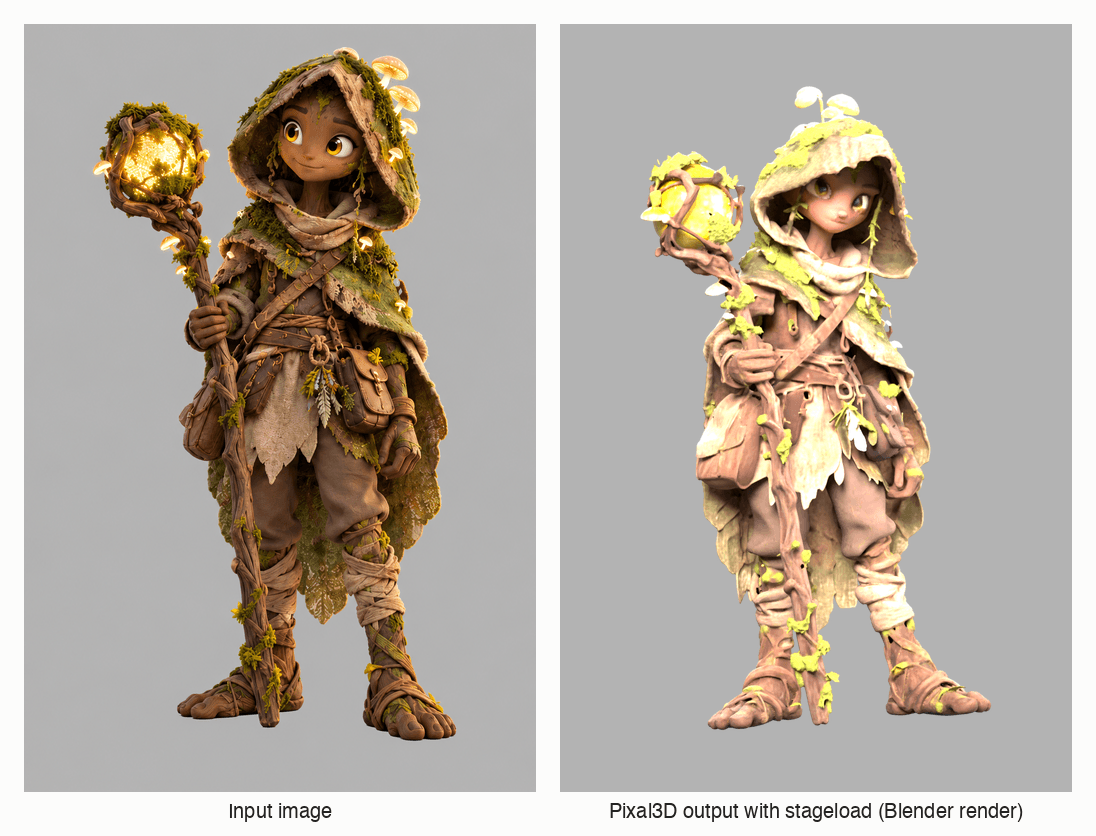
Run staged yang sama pada sebuah karakter dari game yang sedang saya buat memakan 416 detik dan memuat 13,2 GB yang sama dalam 37 detik. Tahap teksturnya memuncak di 30,1 GB, sama seperti pada gambar contoh. Berikut input dan mesh yang dihasilkannya, dirender di Blender:
Kode, jejak setiap run, dan skrip yang menggambar grafik-grafik ini ada di repositori. Adaptor Pixal3D diuji pada satu commit Pixal3D-mac.