Benchmark saya sebelumnya mengatakan bahwa graf kode tidak membuat agen coding saya lebih hemat. Skalanya terlalu kecil untuk menyimpulkan lebih dari itu: 24 pertanyaan, tidak ada yang lebih besar dari 25 ribu node graf, tanpa Opus. Jadi saya menjalankannya lagi pada ukuran yang memungkinkan jawabannya berubah, dan menuliskan rencananya lebih dulu. Hipotesis, repositori, anggaran, dan analisisnya ada di PLAN-v2.md, yang di-commit sebelum satu run pun dijalankan.
Versi singkatnya: graf menguntungkan ketika, tanpa graf, model akan terus mencari. Haiku di kubernetes dan vscode adalah kasus seperti itu. Di sana sonnet sedikit berhemat dan opus tidak sama sekali, dan di repositori kecil biaya sonnet dengan graf lebih tinggi daripada dengan grep biasa.
Susunan
Agennya adalah GitHub Copilot CLI 1.0.90, dijalankan headless, satu pertanyaan per sesi, dengan dua varian:
- grep: tool view, grep, dan glob milik Copilot, tanpa yang lain;
- graf: tiga tool yang sama, ditambah cbm-lean (wrapper tipis saya di sekeliling codebase-memory-mcp 0.9.0) dan aturan perutean di awal prompt: graf untuk pemanggil, fungsi yang dipanggil, dan rantai panggilan, grep untuk string yang persis.
Empat repositori publik, masing-masing dipatok pada satu commit:
| repositori | bahasa | node graf |
|---|---|---|
| full-stack-fastapi-template | Python, TypeScript | 1.601 |
| dub | TypeScript | 25.023 |
| kubernetes | Go | 146.421 |
| vscode | TypeScript | 218.883 |
Setiap repositori punya 16 pertanyaan. Delapan bersifat struktural: siapa yang memanggil sebuah fungsi, apa yang
dipanggilnya, jalur panggilan dari sebuah perintah CLI atau handler HTTP sampai ke fungsi tertentu, dan fungsi mana saja
yang rusak kalau sebuah signature berubah. Delapan lainnya bersifat persis: sebuah nilai konfigurasi, di mana sebuah
variabel lingkungan dibaca, baris tempat sebuah error dilempar, baris tempat sebuah tipe didefinisikan. Setiap kunci
jawaban saya periksa secara manual pada commit yang dipatok, dan sebuah entri hanya dihitung jika cocok sebagai kata
utuh, jadi init_db tidak lolos sebagai init.
Haiku 4.5 menjawab seluruh 64 pertanyaan tiga kali di setiap varian, dan sonnet 5 dua kali. Di Copilot, Opus 5.5 memakan 15 premium request per prompt, jadi Opus menjawab dua belas pertanyaan struktural dari kubernetes dan vscode, masing-masing sekali. Totalnya 664 run dan sekitar 744 premium request.
Biaya diukur dalam tokenEquiv, seperti di catatan pertama: input yang tidak di-cache, ditambah 1,25 × penulisan cache, ditambah 0,1 × pembacaan cache, dijumlahkan atas semua panggilan model dalam sebuah run.
Hasil
Biaya graf sebagai rasio terhadap biaya grep: untuk setiap pertanyaan, median varian graf atas semua pengulangan dibagi median varian grep, lalu median atas semua pertanyaan, dengan interval bootstrap 95%. Di bawah 1, graf lebih murah.
| model | ukuran repositori | struktural | persis |
|---|---|---|---|
| haiku 4.5 | kecil (1,6 ribu node) | 0,88 (0,65–1,29) | 0,92 (0,72–1,15) |
| haiku 4.5 | sedang (25 ribu) | 0,61 (0,11–1,50) | 0,96 (0,75–1,37) |
| haiku 4.5 | besar (146 ribu, 219 ribu) | 0,29 (0,11–0,70) | 1,01 (0,94–1,28) |
| sonnet 5 | kecil | 1,51 (1,45–1,70) | 1,42 (1,20–1,71) |
| sonnet 5 | sedang | 0,94 (0,57–2,00) | 1,14 (1,05–1,30) |
| sonnet 5 | besar | 0,74 (0,62–0,92) | 1,13 (1,01–1,29) |
| opus 5.5 | besar | 0,97 (0,72–1,10) | – |
Jawaban benar pada pertanyaan struktural, graf berbanding grep:
| model | kecil | sedang | besar |
|---|---|---|---|
| haiku 4.5 | 13/24 berbanding 19/24 | 20/24 berbanding 22/24 | 38/47 berbanding 33/48 |
| sonnet 5 | 13/16 berbanding 15/16 | 16/16 berbanding 16/16 | 32/32 berbanding 28/32 |
| opus 5.5 | – | – | 12/12 berbanding 12/12 |
Biaya dan akurasi sekaligus, dalam bentuk tokenEquiv per jawaban benar pada pertanyaan struktural:
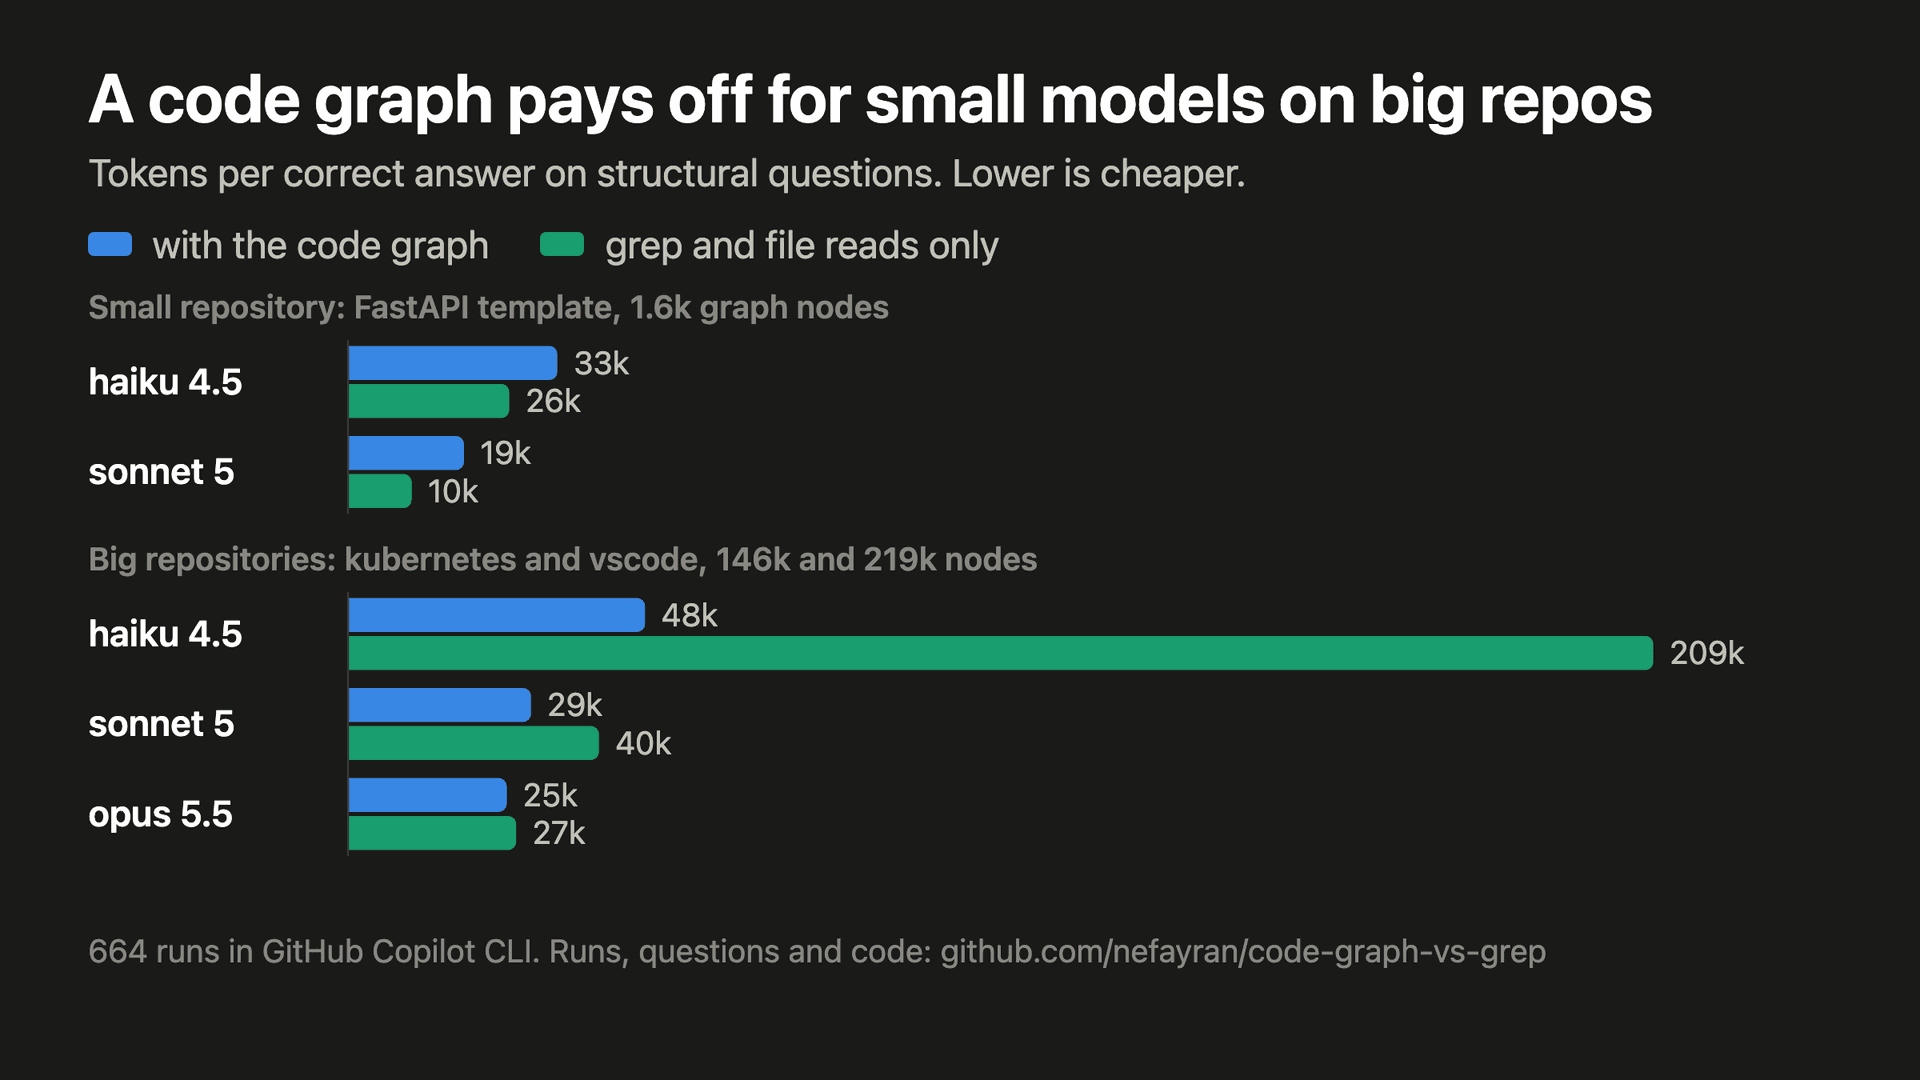
Yang bertahan:
- Di kubernetes dan vscode, pada pertanyaan struktural haiku dengan graf menghabiskan 0,29 dari biayanya dengan grep, dan lebih murah pada 15 dari 16 pertanyaan. Haiku juga lebih sering benar, sehingga per jawaban benar selisihnya 47 ribu berbanding 209 ribu tokenEquiv. Ini satu-satunya hasil yang lolos koreksi Holm atas 13 uji (p = 0,006).
- Sonnet pada pertanyaan yang sama: 0,74, lebih murah pada 12 dari 16, dan 32 dari 32 benar berbanding 28 dari 32. Opus: 0,97, lebih murah pada 7 dari 12, dan semua jawabannya benar di kedua varian.
- Di repositori kecil graf tidak pernah menguntungkan. Biaya haiku kurang lebih sama, dan haiku lebih sering salah menjawab pertanyaan struktural. Biaya sonnet 42 sampai 51% lebih tinggi.
- Pada pertanyaan yang persis, graf tidak membuat perbedaan yang terukur untuk haiku, dan sonnet membayar 13 sampai 42% lebih mahal karenanya.
- Skema tool graf dan aturan perutean menambahkan beban tetap 1,56 ribu token prompt ke setiap panggilan model untuk haiku dan 2,07 ribu untuk sonnet dan opus, di setiap ukuran repositori.
Mengapa model kecil paling diuntungkan
Hitung panggilan modelnya. Dengan grep, haiku butuh median 22 panggilan per jawaban struktural di kubernetes dan 20 di vscode, dan satu pertanyaan analisis dampak butuh 114. Dengan graf, haiku butuh 5 dan 4. Setiap panggilan mengirim ulang seluruh percakapan, jadi pencarian yang panjang jauh lebih mahal daripada yang terlihat dari jumlah panggilannya: jawaban grep haiku yang paling mahal mencapai 471 ribu tokenEquiv.
Dengan grep, pencarian sonnet lebih pendek: 8 panggilan berbanding 4 dengan graf. Opus butuh 4 atau 5 panggilan di kedua varian, jadi tidak ada yang bisa dipangkas graf, dan beban tetapnya menelan penghematan yang sedikit itu.
Dugaan saya, yang tidak saya uji secara langsung: graf menggantikan giliran pencarian, jadi graf menguntungkan ketika, tanpa graf, model akan mengambil banyak giliran, yaitu model yang lebih lemah di repositori yang lebih besar. Model yang kuat sudah mencari dengan efisien memakai grep, dan di repositori kecil tidak ada yang butuh banyak giliran.
Copilot menagih premium request per prompt, berapa pun jumlah panggilannya, jadi di dalam Copilot graf tidak menghemat uang. Yang dihemat adalah waktu: jawaban struktural haiku di repositori besar butuh median 71 detik dengan graf dan 157 detik dengan grep. Di repositori kecil, varian graf lebih lambat.
Di mana setiap varian keliru
- Field bernama
lines. Ditanya di baris manaHorizontalControllerdidefinisikan, varian graf menjawab horizontal.go:43 di kelima run, baik haiku maupun sonnet. Struct itu dimulai di baris 93 dan panjangnya 43 baris. Snippet yang dikembalikan codebase-memory-mcp memuat"start_line": 93,"end_line": 135, dan"lines": 43, dan model membaca yang terakhir sebagai nomor baris. Hal yang sama terjadi lagi padaLemonSqueezyClient(client.ts:129 untuk kelas di baris 59 yang panjangnya 129 baris), dan haiku melakukan hal serupa padaCursorsController. Catatan pertama saya menyalahkan "nomor baris dari graf" atas client.ts:129 itu; dari sinilah asalnya. Sonnet dengan grep menjawab ketiganya dengan benar. Sekarang cbm-lean meneruskan field itu dengan namaline_count. - Lubang di graf, dipercaya mentah-mentah. codebase-memory-mcp 0.9.0 tidak mencatat edge panggilan untuk panggilan
langsung ke fungsi yang diimpor dengan
from x import y. Ditanya apa yang dipanggilrecover_password, varian graf menjawab "hanya get_user_by_email" di kelima run, baik haiku maupun sonnet, langsung dari graf dan tanpa satu grep pun. Fungsi itu juga memanggilgenerate_password_reset_token,generate_reset_password_email, dansend_email, dan varian grep selalu menemukan keempatnya. - Tanda hubung yang hilang. Tool grep milik Copilot hanya menampilkan nomor baris kalau menerima
"-n": true, dan tool view-nya mengembalikan file tanpa nomor baris. Sonnet mengirim-npada 508 dari 571 panggilan grep-nya, dan opus pada seluruh 53 panggilannya. Haiku mengirimn, tanpa tanda hubung, sebanyak 920 kali dan-nsebanyak 22 kali dari 1.949 panggilan. Tool itu mengabaikan key yang tidak dikenal, jadi haiku tidak mendapat nomor baris, menghitung sendiri baris di file yang dibukanya lewat view, dan meleset beberapa baris: untuk error yang dilempar di baris 112, haiku menjawab 105, 107, 108, dan 113. Dari 79 jawaban salah haiku untuk pertanyaan yang persis, semua kecuali satu adalah nomor baris yang salah. - Pencarian panjang yang tetap gagal. Pada rantai panggilan dari
kubeadm token createsampaiencodeTokenSecretData, haiku dengan grep butuh 18 sampai 22 panggilan dan salah menentukan jalurnya di ketiga run. Dengan graf pun haiku salah. Sonnet benar di kedua varian. - Di varian grep, haiku tiga kali mencoba memanggil bash. Copilot menolak karena tool itu tidak ada di sana, jadi tidak ada run yang memakai tool di luar variannya.
Yang berubah sejak catatan pertama
Catatan pertama menyarankan untuk tidak mengharapkan penghematan token dari graf dengan model Claude di repositori sampai 25 ribu node. Pada ukuran itu, saran tersebut masih berlaku. Yang luput dari catatan itu adalah apa yang terjadi di atas ukuran tersebut: di kubernetes dan vscode model yang lebih kecil diuntungkan, dan makin kecil modelnya, makin besar untungnya.
Yang akan saya katakan kepada tim yang menghubungkan graf ke agen
- Ukur dulu di repositori terbesar Anda dengan model termurah Anda. Di situlah graf layak dipakai.
- Dengan model yang kuat di repositori kecil atau sedang, jangan pasang graf. Anda membayar skemanya di setiap panggilan dan tidak mendapat apa pun sebagai gantinya.
- Tetap arahkan pertanyaan yang persis ke grep. Di pertanyaan seperti itu graf tidak pernah menang.
- Jangan biarkan model menerima mentah-mentah nomor baris atau "ini daftar lengkapnya" dari keluaran graf. Buang atau
ganti nama field seperti
linessebelum sampai ke model.
Batasan
- Satu harness agen (Copilot CLI) dan satu graf (codebase-memory-mcp 0.9.0 di balik wrapper saya). Claude Code, graf lain, atau versi yang lebih baru bisa memberi angka yang berbeda.
- Delapan pertanyaan per sel di repositori kecil dan sedang. Dengan 13 uji di bawah koreksi Holm, sel berisi delapan pertanyaan tidak bisa mencapai signifikansi bahkan kalau graf memenangkan setiap pertanyaan, jadi hanya hasil haiku di repositori besar yang signifikan.
- Opus menjawab dua belas pertanyaan, masing-masing sekali.
- tokenEquiv tidak memasukkan token output. Kalau dihitung, selisih haiku di repositori besar akan makin lebar: jawaban grep-nya di sana menghasilkan median 7,0 ribu token output berbanding 0,9 ribu dengan graf.
- Satu run haiku gagal sebelum Copilot membuka sesi dan tidak diikutsertakan. Tiga run sonnet gagal mengambil daftar model Copilot sebelum ada panggilan model apa pun dan dijalankan ulang. Keduanya tercatat di rencana.
Reproduksi
Semuanya ada di code-graph-vs-grep: rencana yang ditulis sebelum run dijalankan, pertanyaan beserta bukti untuk setiap kunci jawaban, driver, seluruh 664 run beserta jawabannya, dan analisisnya.
node bench/run-copilot.mjs --model claude-haiku-4.5 --reps 3 --out results/v2/claude-haiku-4.5.json
python3 bench/stats-v2.py results/v2/*.json