Catatan pertama tentang stageload hanya mengukur satu pipeline, Pixal3D. Pipeline text-to-image punya bentuk yang sama: encoder teks, denoiser, dan decoder gambar berjalan berurutan. Karena itu, pada 6 Oktober saya mengukur satu, Qwen-Image-2.1 di diffusers, di Mac 48 GB yang sama. Encoder teksnya memakan 16,3 GB, transformer-nya 13,3 GB, dan VAE-nya 1,3 GB. Setiap run membuat satu gambar 1024 × 1024 dalam 20 langkah, masing-masing dalam prosesnya sendiri di bawah penjaga memori.
Eager adalah from_pretrained(...).to("mps") yang biasa. Pada staged, dua model besar pipeline diganti dengan pengganti. Pengganti itu menjawab .config dari checkpoint, sehingga pipeline bisa membaca konfigurasi sebelum denoising dimulai, dan memuat model aslinya untuk penggunaan lain apa pun. Tiga hook menandai awal setiap tahap di encode_prompt, prepare_latents, dan _unpack_latents. Kode pipeline tidak diubah.
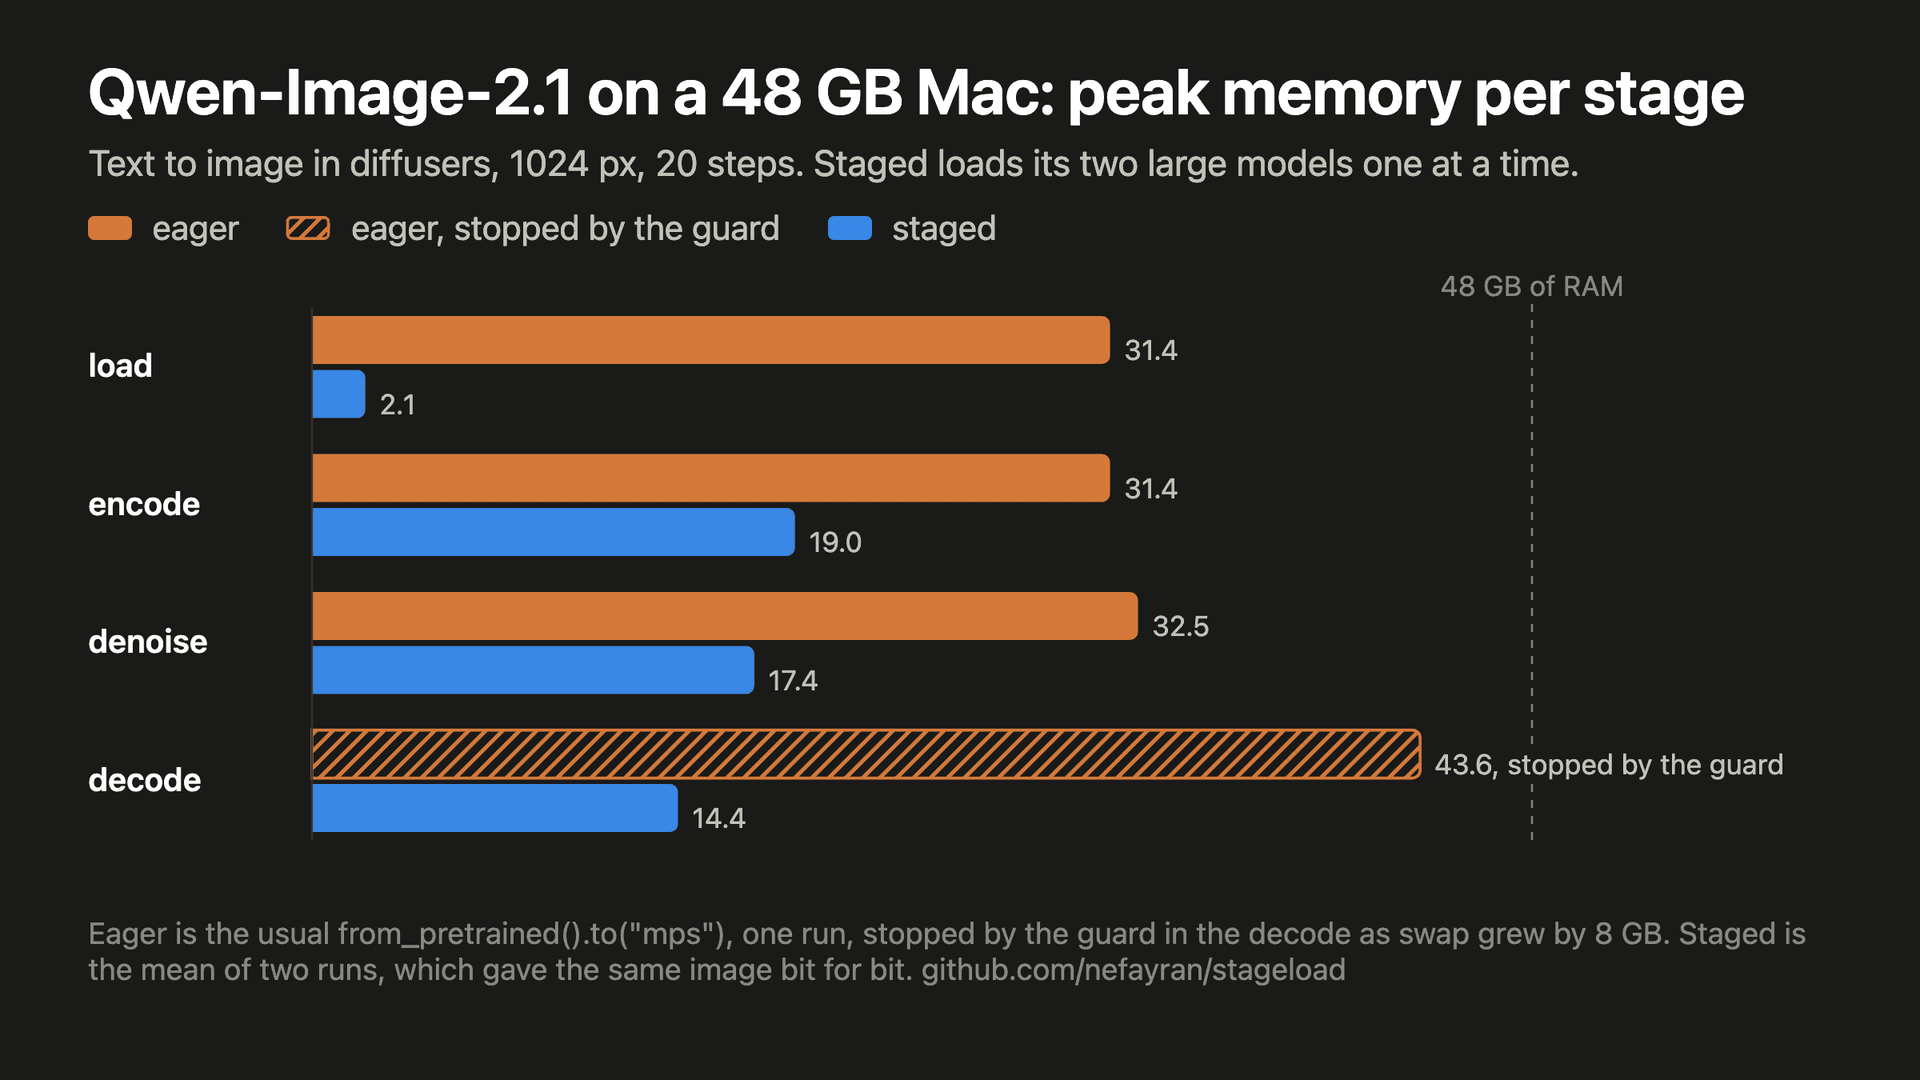
Selama encoding dan denoising, eager bertahan di 31 sampai 33 GB. Decode VAE butuh sekitar 11 GB lagi di atas bobot model, dan itu membawanya ke 43,6 GB; swap naik 8 GB dan penjaga menghentikannya sebelum gambar ditulis. Staged melepas transformer sebelum decode. Puncaknya 19,0 GB saat encoding dan 14,4 GB saat decode, dan swap tidak bertambah di kedua run-nya.
Staged menghabiskan 13 detik untuk memuat kedua model. Denoising memakan 109 detik pada run pertamanya, 79 detik pada run kedua, dan 77,5 detik pada eager; jejak run pertama tidak menunjukkan mengapa run itu lebih lambat.
Yang tidak bisa saya tunjukkan
Dua run staged menghasilkan gambar yang sama bit demi bit. Eager tidak menghasilkan gambar di Mac ini, jadi run-run ini tidak menunjukkan bahwa pemuatan staged memberi gambar yang sama dengan eager. Satu run eager yang lebih awal bahkan tidak lolos tahap pemuatan: run itu mulai satu menit setelah sebuah pekerjaan video selesai, dan swap naik 10 GB hanya dalam 18 detik.
Kodenya ada di bench/qwen_image.py, dan jejak serta ringkasannya ada di repositori.