Linux पर किसी जॉब की मेमोरी ulimit -v, systemd-run -p MemoryMax= या cgroup से सीमित की जा सकती है, और बहुत बड़ा हो जाने वाला जॉब पूरी मशीन को गिराने के बजाय खुद विफल हो जाता है। macOS में न systemd है, न cgroups, और ulimit मना कर देता है। यह macOS 26.5.2 है:
$ /bin/bash -c 'ulimit -v 1048576'
/bin/bash: line 0: ulimit: virtual memory: cannot modify limit: Invalid argument
$ /bin/bash -c 'ulimit -m 1048576'
/bin/bash: line 0: ulimit: max memory size: cannot modify limit: Invalid argument
Python में resource.setrlimit(resource.RLIMIT_DATA, ...) ValueError देता है, और जिस शेल में ulimit -m विफल हुआ था, उसी में एक स्क्रिप्ट ने इसके बाद भी 3 GiB आवंटित करके उसे छुआ। इसके बजाय macOS मेमोरी को कंप्रेस करता है और उसे स्वैप में लिखता है। जो मॉडल फ़िट नहीं होता, वह विफल नहीं होता: वह धीमा हो जाता है, और उसके साथ Mac पर बाकी सब भी।
इसलिए पूछने लायक सवाल बदल जाते हैं: जॉब शुरू होने से पहले जगह है या नहीं, और चलते समय स्वैप बढ़ रहा है या नहीं?
जॉब चलते समय स्वैप देखें
sysctl vm.swapusage             # compare "used" before and after a run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
प्रोसेस का footprint, यानी वह संख्या जो Activity Monitor दिखाता है, उन पेजों को नहीं गिनता जो पहले से स्वैप में हैं। मेरे 48 GB वाले M5 Pro पर diffusers के model CPU offload के साथ Qwen-Image-2.1 के एक रन में footprint कभी 18.5 GB से ऊपर नहीं गया, जबकि स्वैप 9.6 GB बढ़ा। सिर्फ़ footprint का चार्ट इस रन को फ़िट मान लेता।
स्वैप से पहले जॉब रोकें
stageload, एक छोटी लाइब्रेरी जो मैंने मॉडलों को एक-एक स्टेज में लोड करने के लिए लिखी, इसके लिए एक गार्ड के साथ आती है (pip install stageload):
stageload guard --wait-free 40 --swap-budget 8G -- python generate.pyयह तब तक इंतज़ार करता है जब तक kern.memorystatus_level कम से कम 40 % न हो जाए, फिर कमांड शुरू करता है। अगर स्वैप शुरुआत में इस्तेमाल हो रही मात्रा से 8 GB से ज़्यादा बढ़ जाए, या खाली मेमोरी लगातार दो सैंपल तक 10 % से नीचे रहे, तो यह कमांड के प्रोसेस ग्रुप को SIGTERM भेजता है और पाँच सेकंड बाद जो बचा हो उसे SIGKILL। इसे root नहीं चाहिए, और यह सिर्फ़ कमांड और उसके प्रोसेस ग्रुप को ही रोकता है। एग्ज़िट कोड 3 का मतलब है कि गार्ड ने कमांड रोकी, और 4 का कि उसे शुरू करने की जगह कभी नहीं मिली; बाकी मामलों में आपको कमांड का अपना एग्ज़िट कोड मिलता है।
eager वाला Qwen-Image रन ऐसे ही खत्म हुआ: वह सभी 20 स्टेप पूरे कर गया, VAE डिकोड ने footprint को 43.6 GB तक पहुँचाया, स्वैप 8 GB बढ़ा, और Mac के अटकने से पहले गार्ड ने उसे रोक दिया।
एक साथ दो भारी जॉब
हर गार्ड अकेले फ़ैसला करता है। एक ही पल में जगह पाने वाले दो गार्ड दोनों अपने जॉब शुरू कर देते हैं, जबकि हर जॉब ऐसे Mac के हिसाब से बना था जिस पर और कुछ नहीं चल रहा। 5 अक्टूबर को मेरा एक रन किसी दूसरी स्क्रिप्ट के दो वीडियो जॉब्स के बीच के अंतराल में शुरू हुआ, और अगले वीडियो जॉब ने 20 सेकंड के भीतर स्वैप को उसकी सीमा से पार कर दिया।
stageload run जॉब्स को पूरी मशीन के लिए एक कतार में लगाता है। यह गार्ड वाले ही फ़्लैग लेता है। यहाँ दो टर्मिनलों से शुरू किए गए दो जॉब 3 और 2 GiB रखते हैं:
stageload run --who images -- python3 alloc.py 3 10    # holds 3 GiB for 10 s
stageload run --who upscale -- python3 alloc.py 2 4    # holds 2 GiB for 4 s
$ stageload queue
ram 0 running images pid 32488 since 2026-10-12T14:08:56+00:00 python3 alloc.py 3 10
ram 1 waiting upscale pid 32499 since 2026-10-12T14:08:58+00:00 python3 alloc.py 2 4पहला जॉब खत्म होने पर दूसरा शुरू होता है, और फिर हमेशा की तरह गार्ड की जाँचें चलती हैं:
14:08:58Z queue: waiting in ram (1 ahead: images)
14:09:08Z queue: start in ram after 10 s, swap 6.0 GB, stop above 14.0 GB or under 10% available twice
$ stageload queue --history 2
done ram exit 0 images waited 0 s, ran 10 s, peak 3.0 GB python3 alloc.py 3 10
done ram exit 0 upscale waited 10 s, ran 4 s, peak 2.0 GB python3 alloc.py 2 4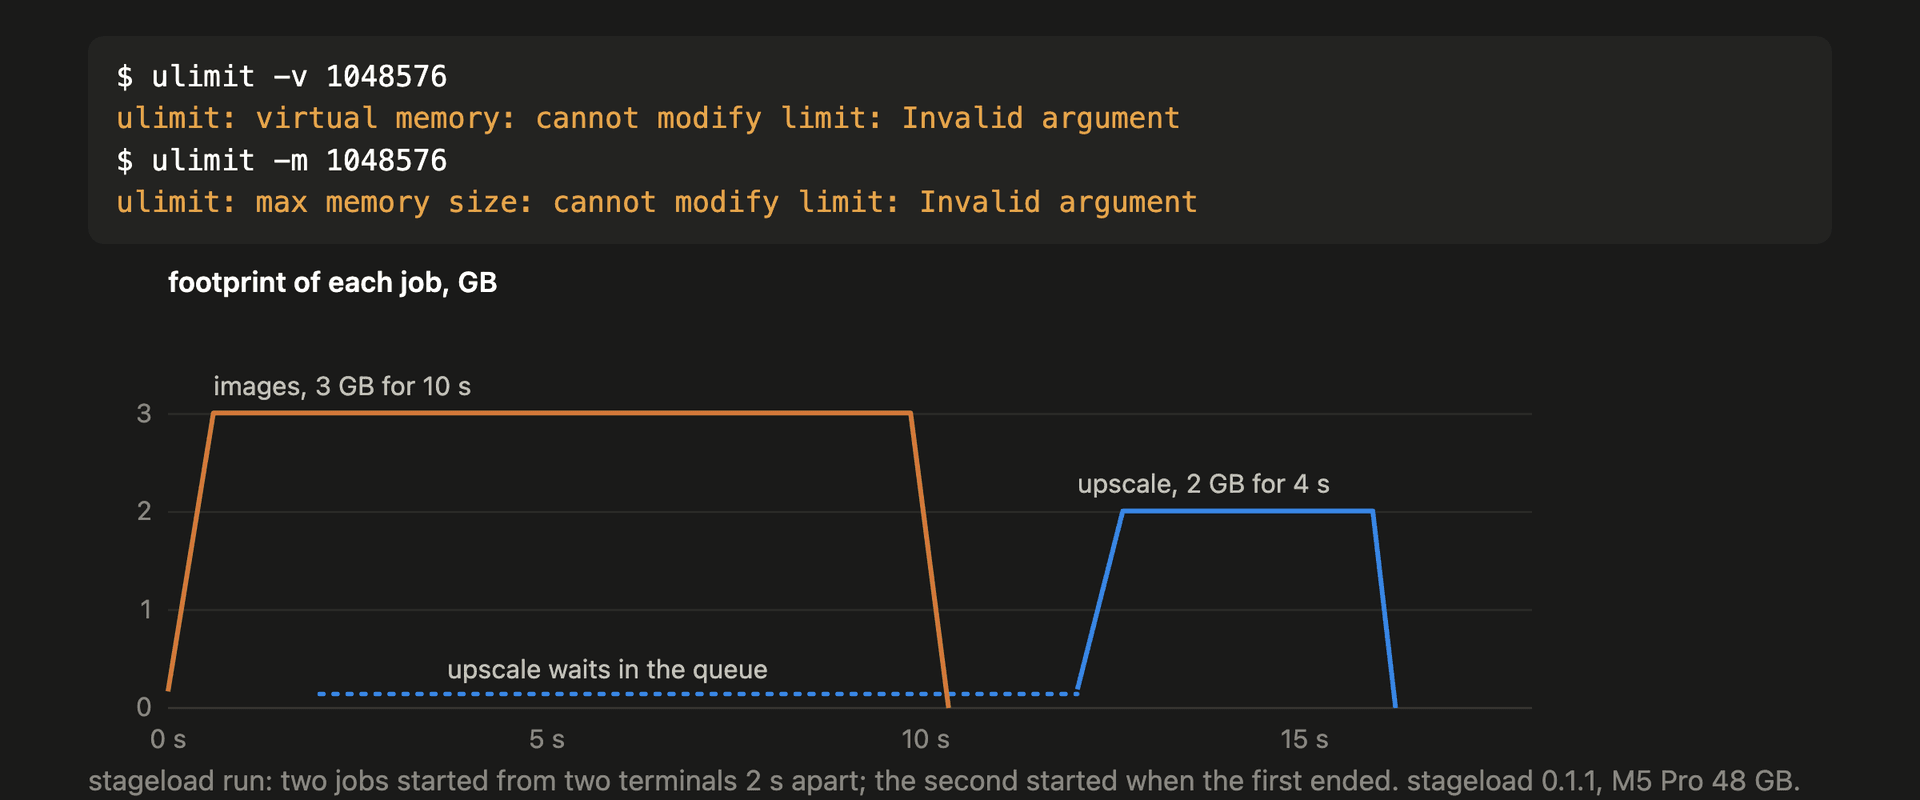
साझा Mac पर जो बातें काम की निकलीं:
- जॉब एक लेन में जुड़ते हैं, डिफ़ॉल्ट रूप से
ram। लेनें एक-दूसरे का इंतज़ार नहीं करतीं, इसलिए जो जॉब किसी रिमोट API कोटा पर रुकता है, वह अपनी अलग लेन में जा सकता है (--lane api --wait-free 0) और मेमोरी वाले जॉब्स को नहीं रोकता। - मालिकों के बीच बारी बराबर चलती है। जिस मालिक ने सबसे लंबे समय से कोई जॉब शुरू नहीं किया, वह अगला होता है, इसलिए बीस जॉब कतार में लगाने वाली स्क्रिप्ट भी लेन घेरने के बजाय बाकियों के साथ बारी लेती है। मालिक
--ownerहै, या--whoका पहले डैश से पहले वाला हिस्सा। - हर रन कमांड और उसके नीचे की हर प्रोसेस का मेमोरी ट्रेस लिखता है, और
~/.stageload/history.jsonlमें एक लाइन जोड़ता है: इंतज़ार, चलने का समय, सबसे ऊँचा footprint और स्वैप। - कतार के बाहर शुरू किए गए इंजन
~/.stageload/busy.txtमें जाते हैं, हर लाइन में एक पैटर्न।ramलेन का हर रन तब तक इंतज़ार करता है जब तक उनमें से कोई भी 20 सेकंड तक न दिखे।
सीमाएँ
- गार्ड और मीटर macOS के काउंटर (
libproc,sysctl) पढ़ते हैं, इसलिए वे सिर्फ़ Mac पर चलते हैं। - गार्ड जॉब को रोकता है; उसे छोटा नहीं करता। मॉडल की तरफ़, हर स्टेज में एक मॉडल लोड करने से ही उसी Mac पर Qwen-Image-2.1 का footprint 43.6 GB से 19.0 GB पर आया: 48 GB वाले Mac पर Qwen-Image-2.1 को बिना स्वैप के कैसे चलाएँ।
- पूरी मशीन के लिए सुरक्षा जाल चाहिए तो macos-oom-guard root के रूप में चलता है और कर्नेल पैनिक से पहले सबसे बड़ी प्रोसेस को खत्म कर देता है। दोनों साथ चल सकते हैं।