stageload के दूसरे नोट में 48 GB वाले Mac पर Qwen-Image-2.1 को दो तरह से चलाया गया था। eager को मेमोरी गार्ड ने VAE डिकोड में रोक दिया, और staged पूरा चला। diffusers में एक तीसरा तरीका पहले से मौजूद है, enable_model_cpu_offload, जो हर मॉडल को CPU पर रखता है और उसे सिर्फ़ चलने के दौरान GPU पर ले जाता है। 8 अक्टूबर को मैंने इसे एक बार चलाया, उसी प्रॉम्प्ट, साइज़, स्टेप्स, सीड और गार्ड की सीमाओं के साथ जो 6 अक्टूबर के रन में थीं।
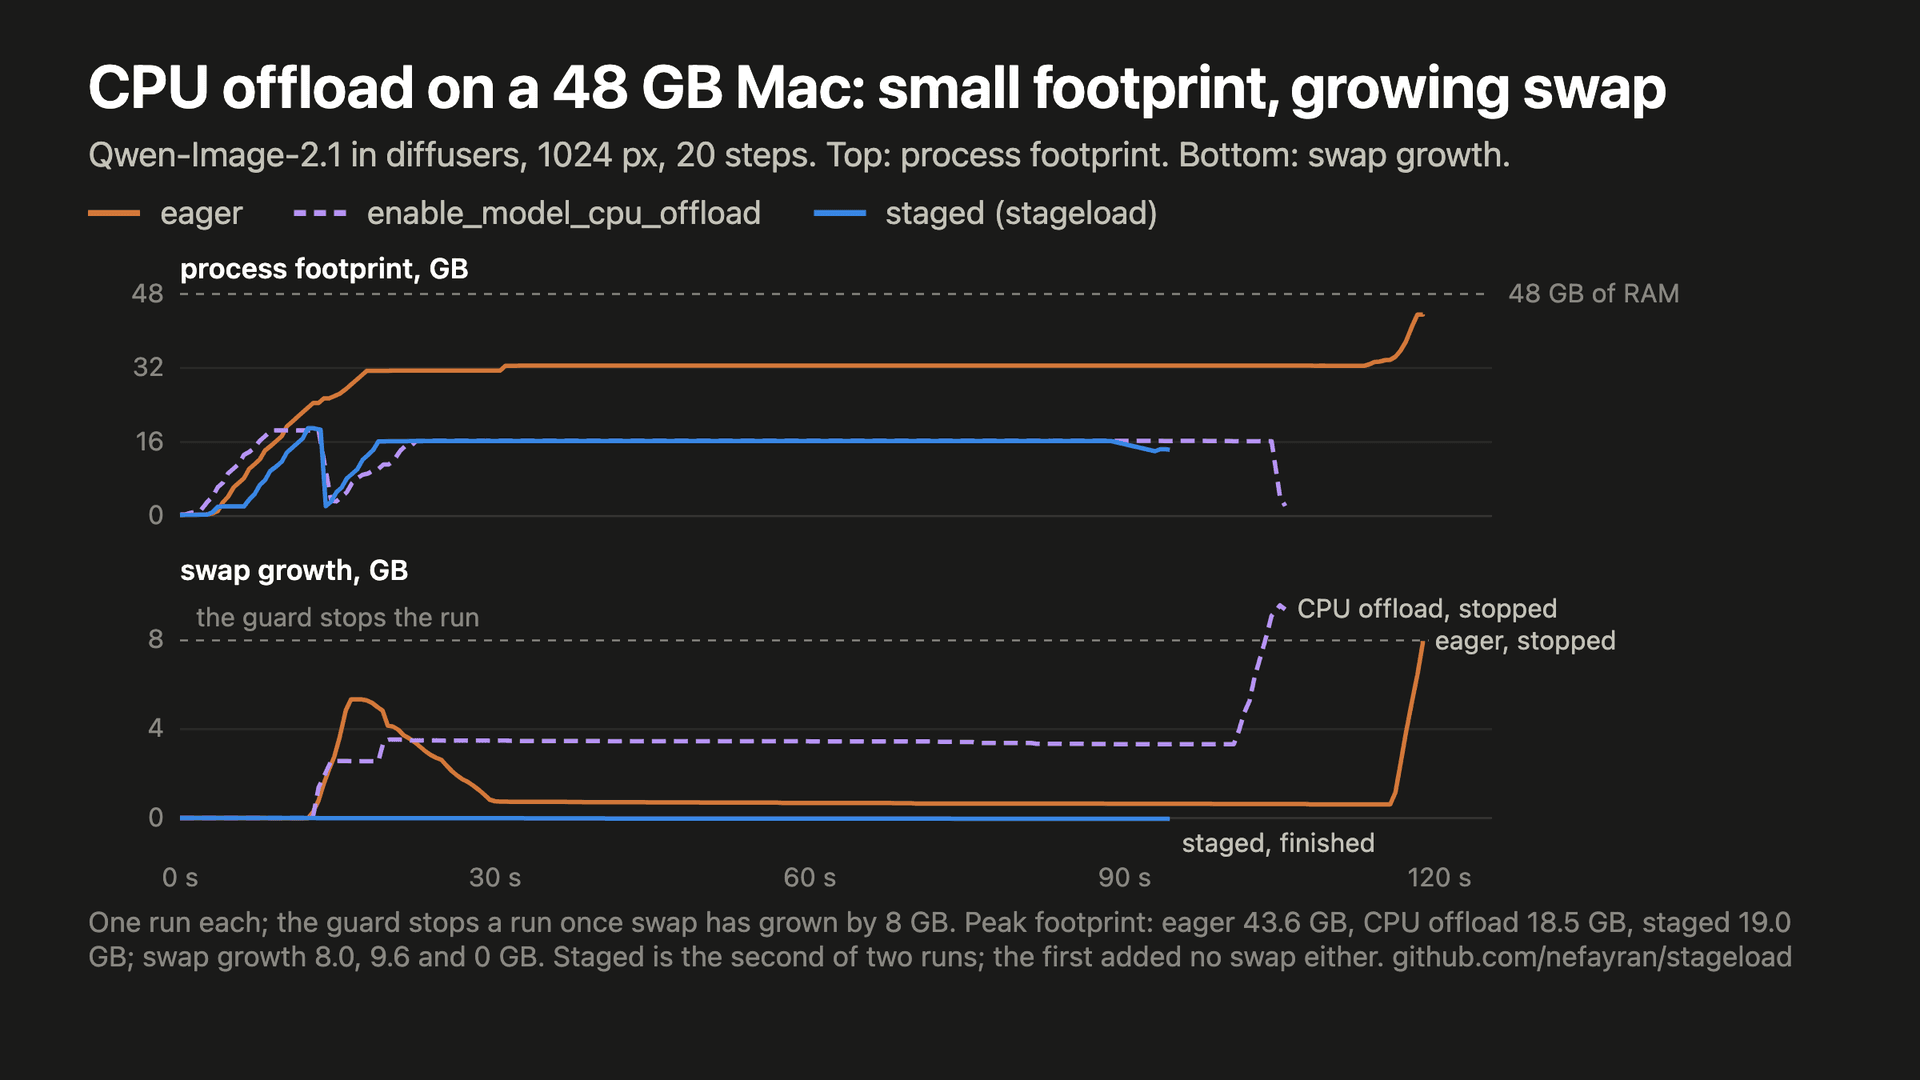
प्रोसेस footprint के हिसाब से offload staged जैसा दिखा: उसका शिखर 18.5 GB रहा, staged का 19.0 GB। फ़र्क स्वैप में दिखता है। एनकोडिंग में 8 सेकंड लगे और स्वैप नहीं बढ़ा। 87 सेकंड के डीनॉइज़िंग में स्वैप 3.5 GB बढ़ा और उपलब्ध मेमोरी 27 % तक गिर गई। VAE डिकोड ने स्वैप की बढ़त को 9.6 GB और उपलब्ध मेमोरी को 22 % तक पहुँचा दिया, और शुरू होने के 105 सेकंड बाद, इमेज लिखे जाने से पहले, गार्ड ने रन रोक दिया। staged ने अपने दोनों रन में स्वैप नहीं बढ़ाया, और वे 94 और 124 सेकंड में पूरे हुए।
footprint यह नहीं दिखा सकता, क्योंकि वह उन पेजों को नहीं गिनता जो पहले से स्वैप में हैं। Mac पर CPU और GPU एक ही मेमोरी साझा करते हैं, इसलिए "CPU पर" रखा मॉडल भी उसी RAM में रहता है जिसमें चल रहा मॉडल। सिर्फ़ footprint से आँकें तो offload staged के बगल में आता है। स्वैप से आँकें तो वह eager के बगल में आता है, जिसे गार्ड ने उसी जगह 8 GB नए स्वैप के बाद रोका था।
जो मैं नहीं दिखा सका
यह एक ही रन है। दूसरा रन मशीन को फिर से स्वैप में धकेलता, उस नतीजे के लिए जो गार्ड पहले ही तय कर चुका था। मैंने यह नहीं मापा कि कौन-से पेज स्वैप में गए, और ज़्यादा मेमोरी वाले Mac पर offload नहीं आज़माया।
स्क्रिप्ट bench/qwen_image_offload.py में है, और ट्रेस रिपॉज़िटरी में। stageload pip install stageload से इंस्टॉल होता है।