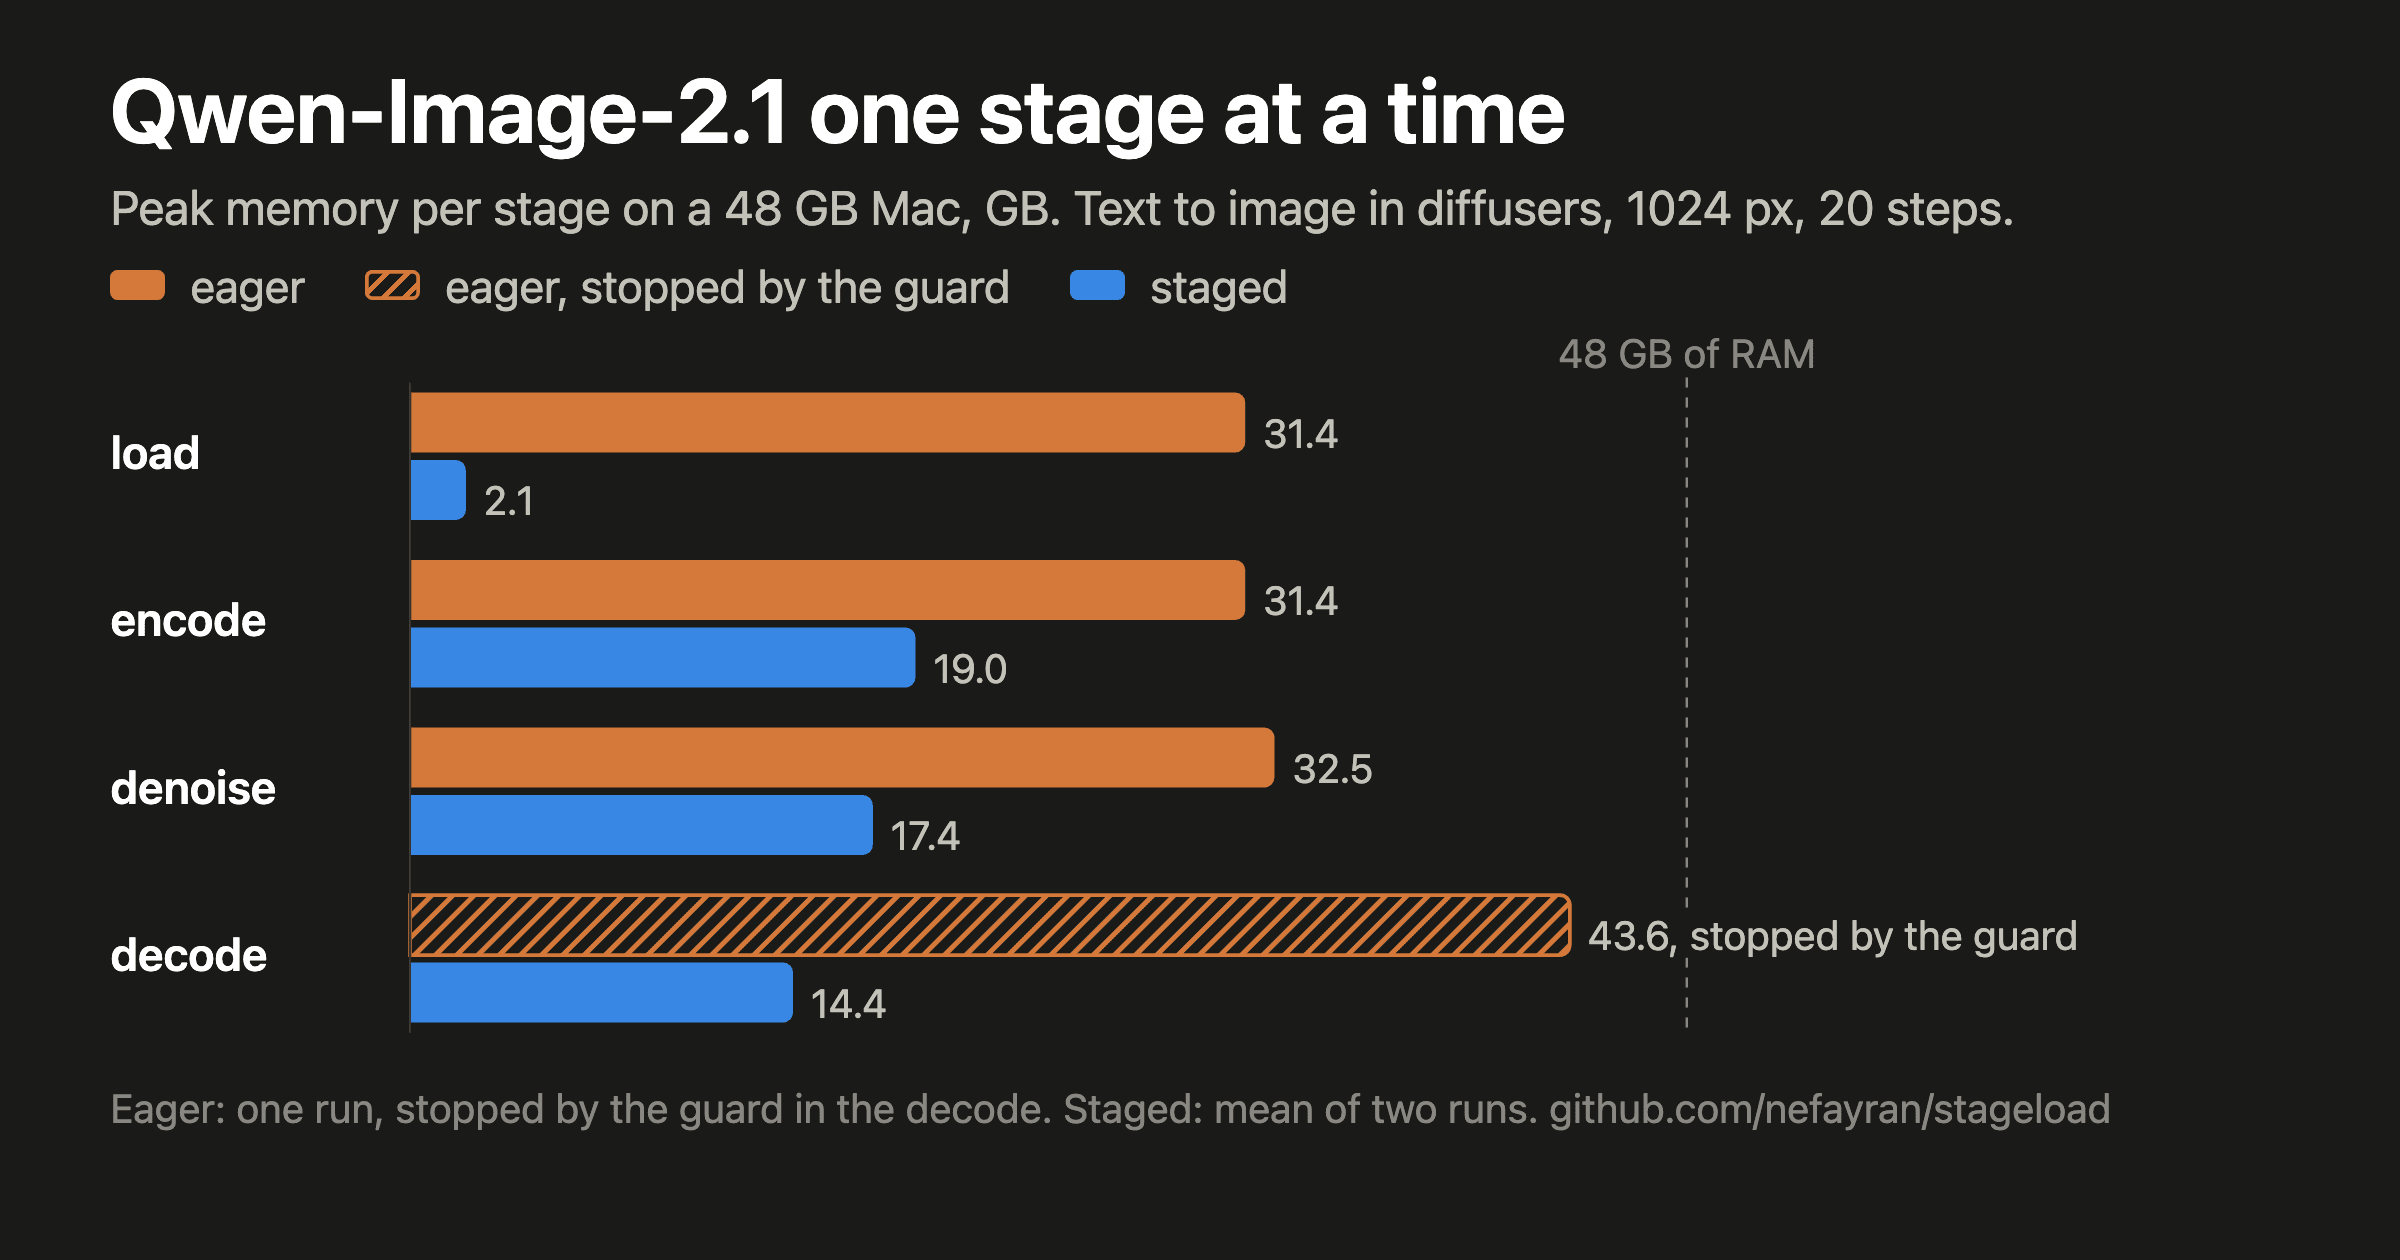
Qwen-Image-2.1 एक स्टेज के बाद एक: stageload की दूसरी पाइपलाइन
48 GB वाले Mac पर stageload से diffusers की एक text-to-image पाइपलाइन लोड की: eager VAE डिकोड में 43.6 GB तक पहुँचा और मेमोरी गार्ड ने उसे रोक दिया, जबकि staged पाइपलाइन का कोड बदले बिना 19.0 GB या उससे कम पर रहा।
नोट पढ़ें →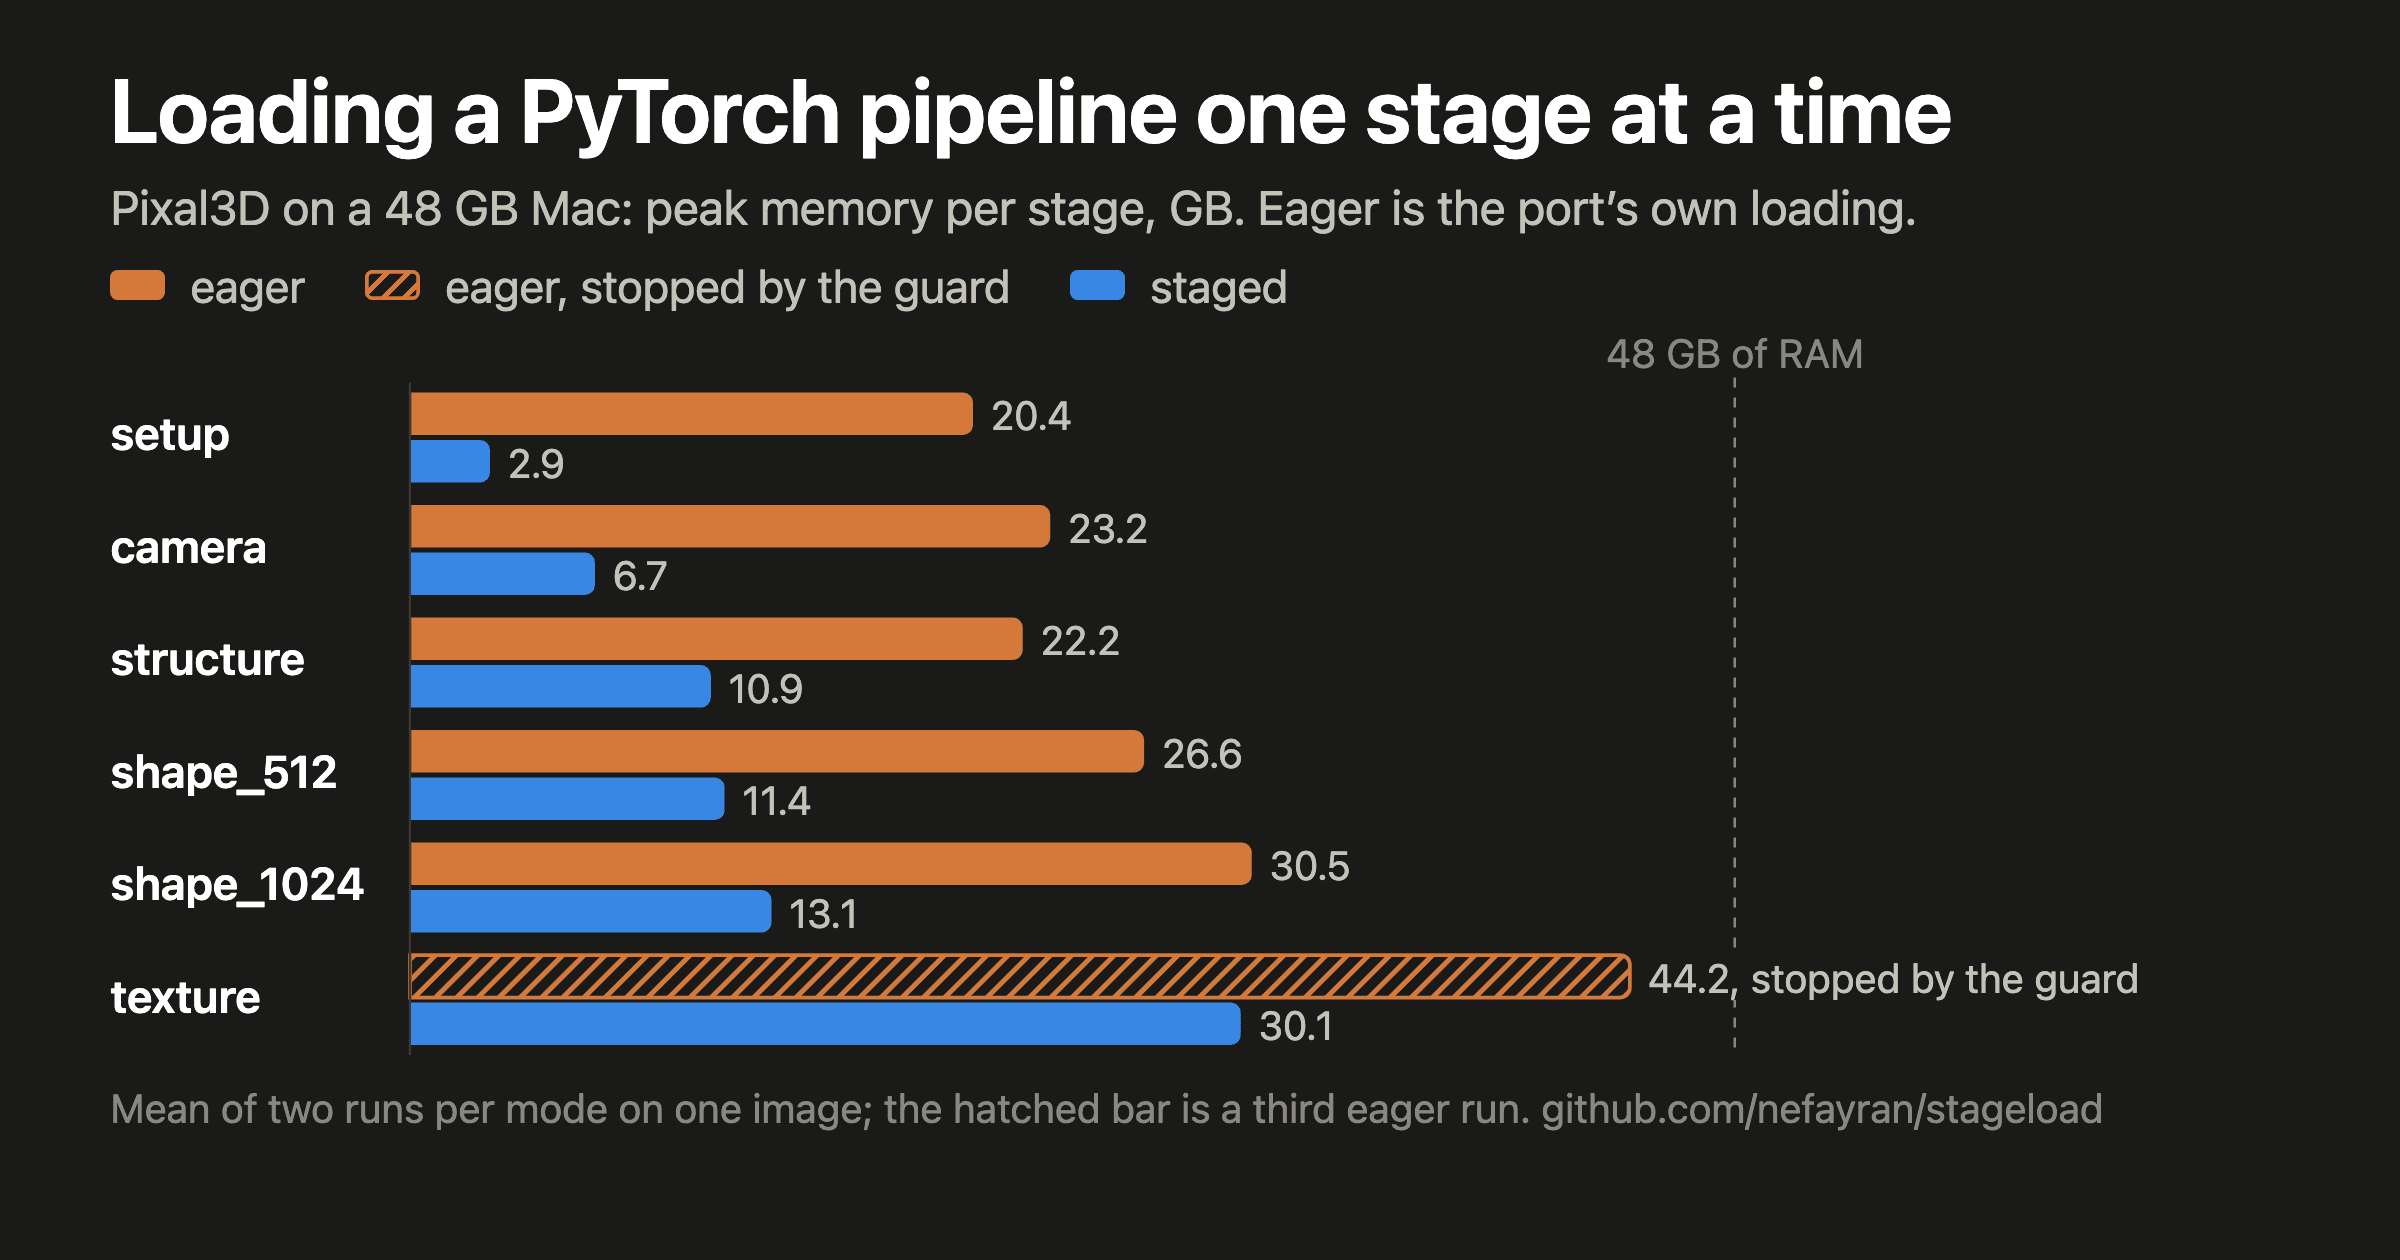
PyTorch पाइपलाइन को एक-एक स्टेज करके लोड करना: 48 GB वाले Mac पर Pixal3D
stageload किसी भी ऐसी PyTorch पाइपलाइन के लिए है जो अपने मॉडल बारी-बारी से चलाती है: स्टेज शुरू होने पर वह उस स्टेज के मॉडल लोड करता है और स्टेज खत्म होने पर उन्हें रिलीज़ कर देता है। 48 GB वाले Mac पर Pixal3D-mac में इसने उन सभी स्टेज में पीक 11 से 17 GB तक घटाया जहाँ तक दोनों वर्ज़न पहुँचे, जबकि पोर्ट की अपनी लोडिंग ने मशीन को स्वैप में धकेल दिया, जब तक गार्ड ने उसे रोका नहीं।
नोट पढ़ें →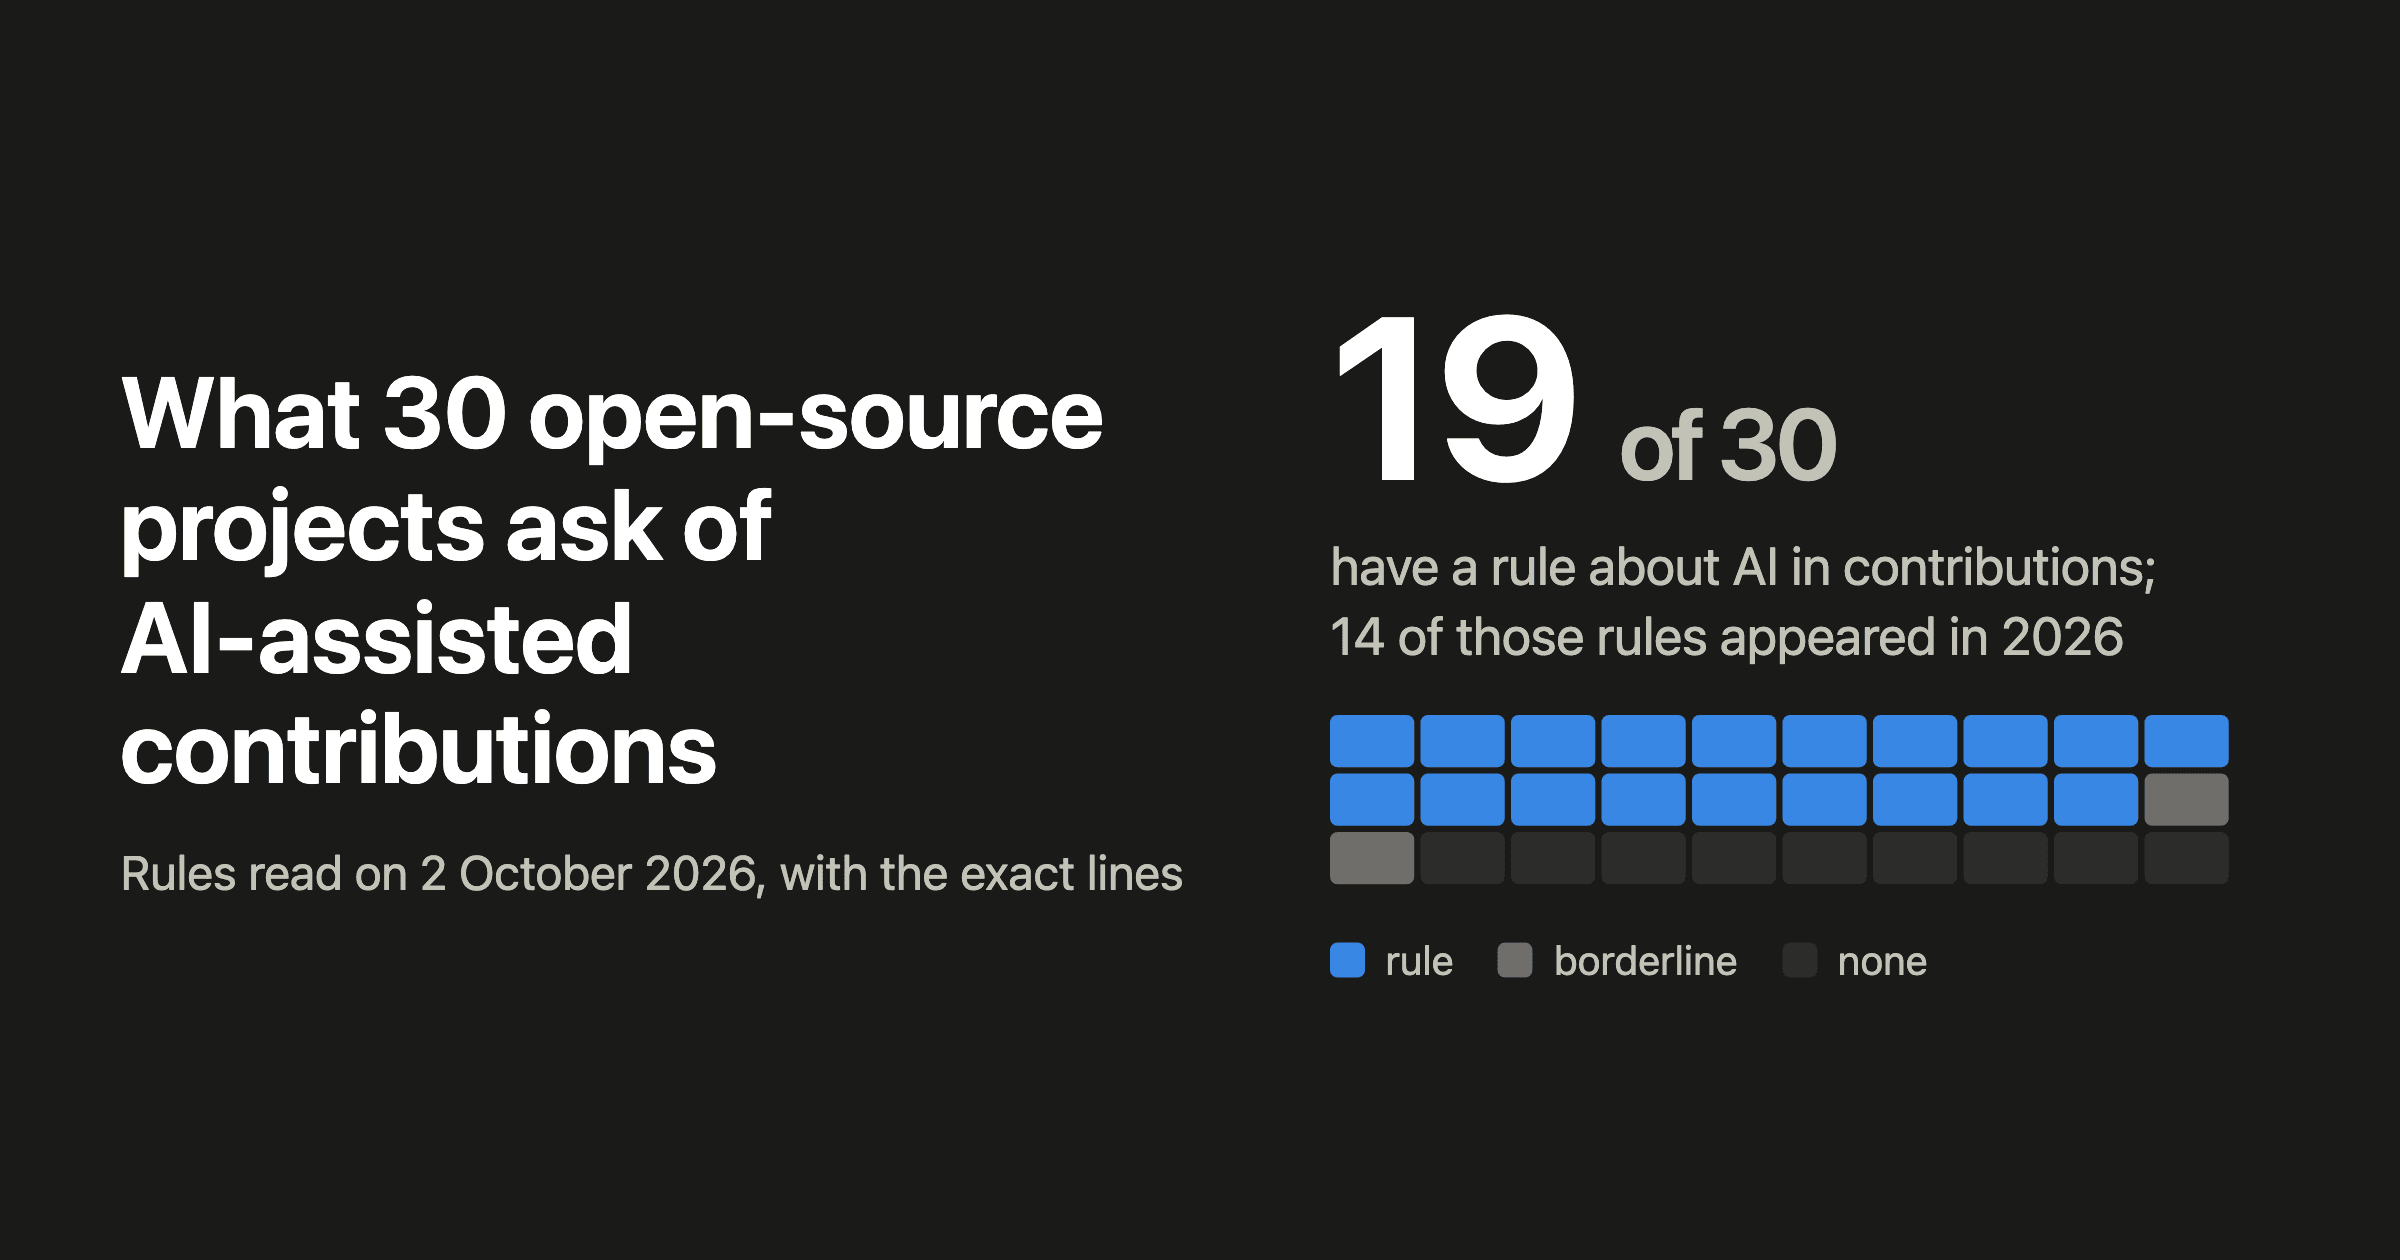
30 ओपन-सोर्स प्रोजेक्ट AI की मदद से किए गए योगदान से क्या माँगते हैं
2 अक्टूबर 2026 को मैंने 30 ओपन-सोर्स रिपॉज़िटरी के योगदान के नियम पढ़े। 19 में AI के बारे में नियम है, और इनमें से 14 नियम 2026 में आए। पंद्रह कहते हैं कि आप बताएँ कि आपने AI का इस्तेमाल किया, दस चाहते हैं कि टेक्स्ट कोई इंसान लिखे, और कोडिंग एजेंट डिफ़ॉल्ट रूप से जो कमिट ट्रेलर जोड़ते हैं, उसे कुछ प्रोजेक्ट ज़रूरी मानते हैं और कुछ उस पर पाबंदी लगाते हैं। फिर यह कि उस हफ़्ते मैंने एजेंट की मदद से जो काम बारह प्रोजेक्ट को भेजा, उसका क्या हुआ।
नोट पढ़ें →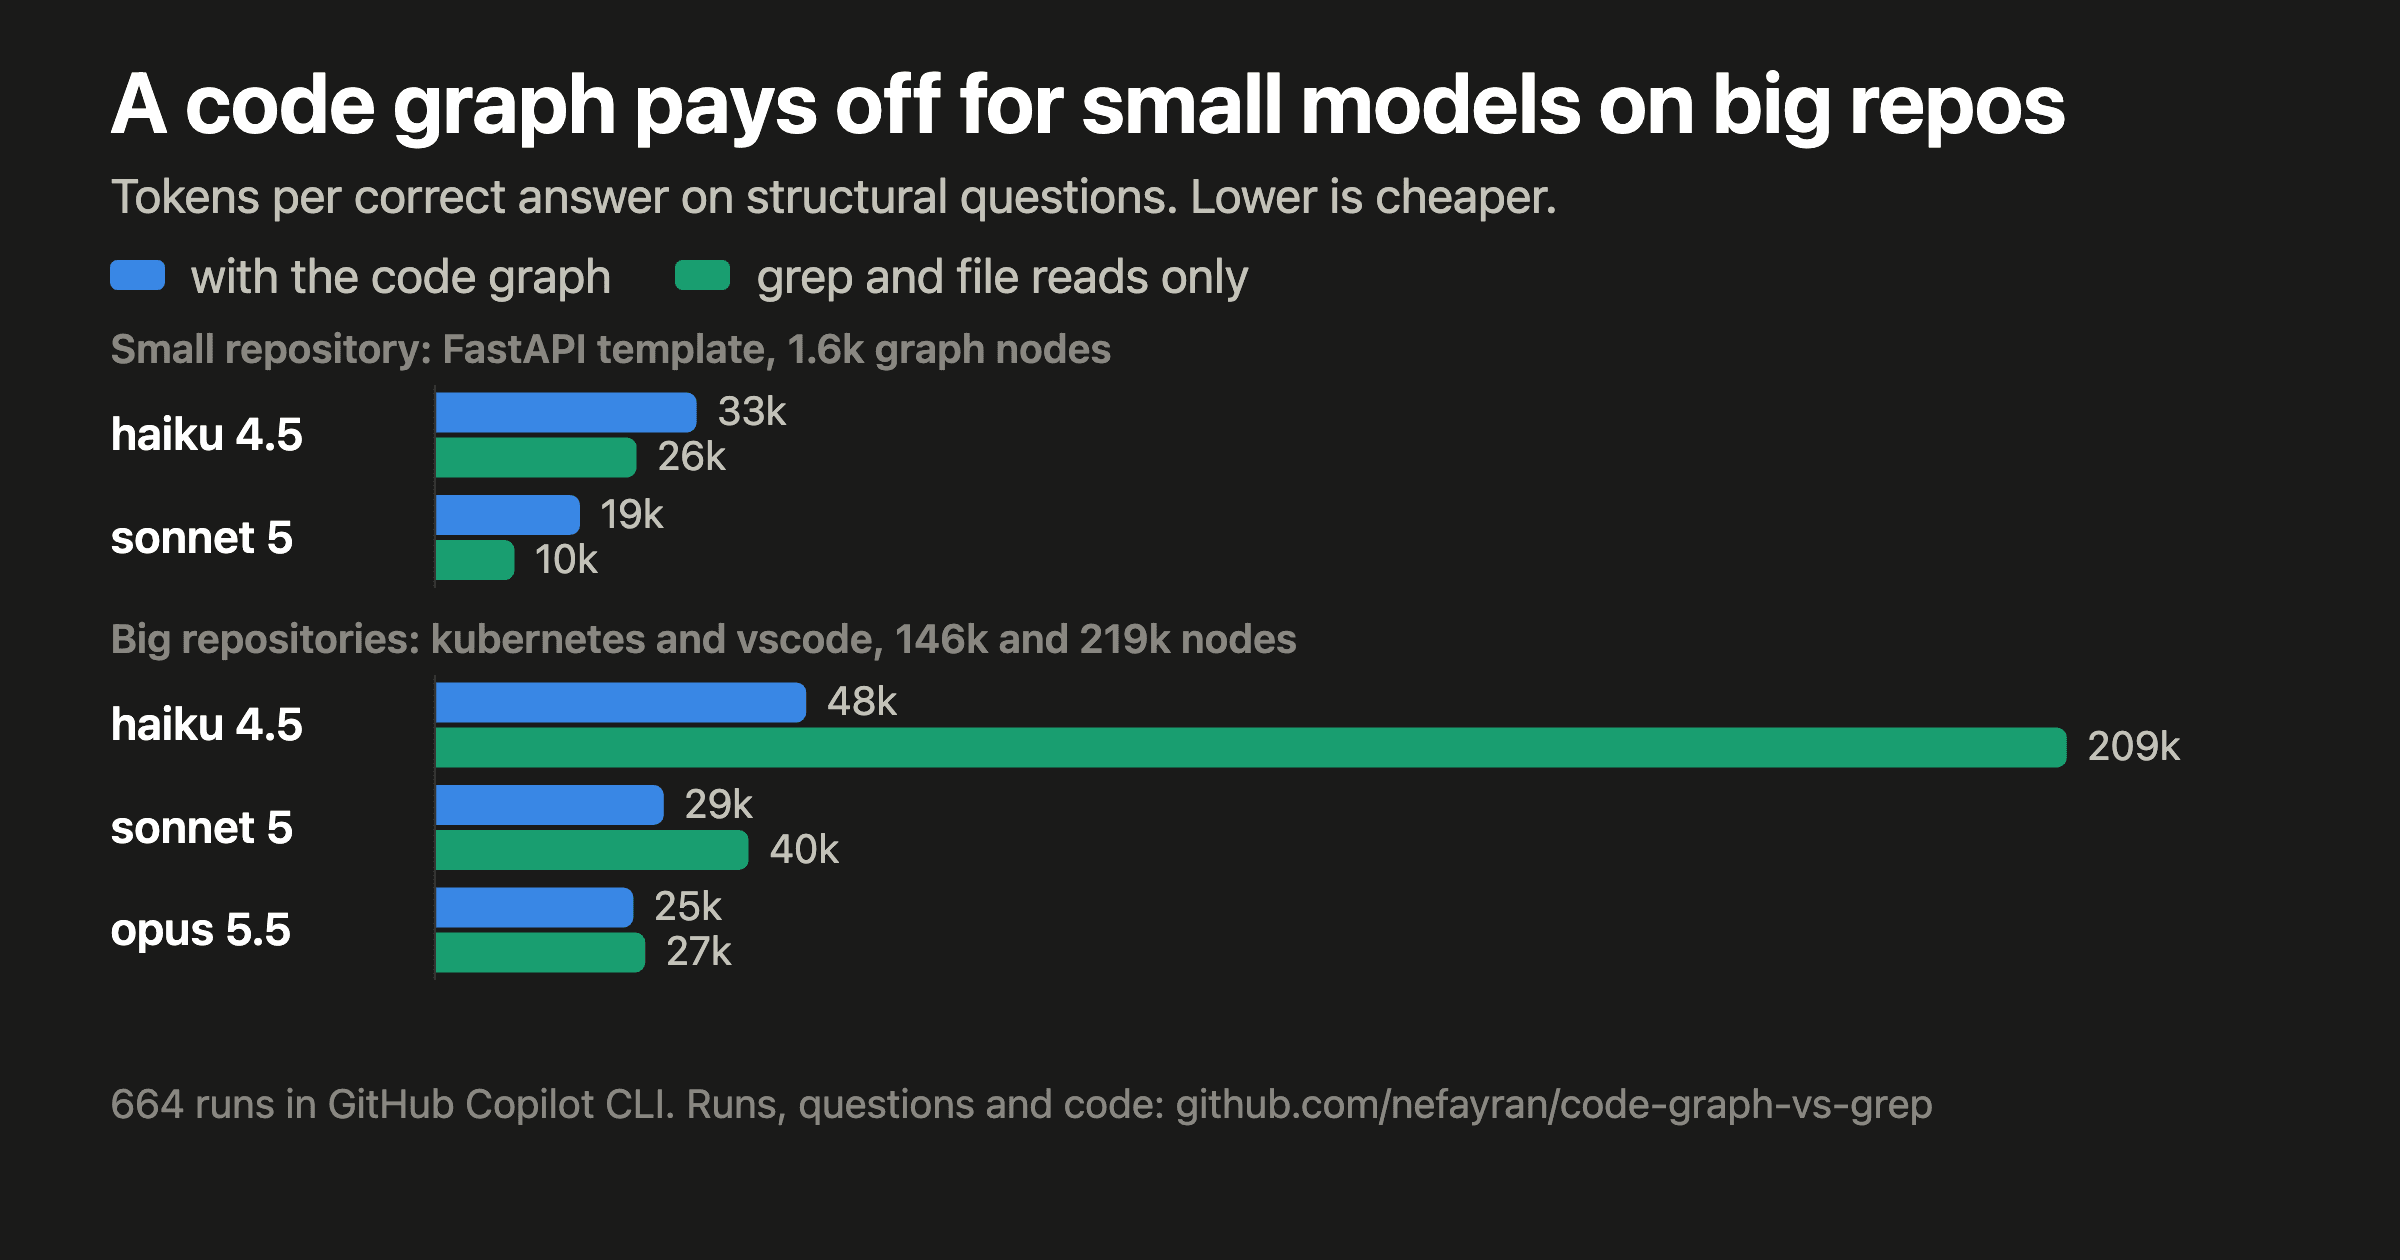
कोड ग्राफ़ कहाँ फ़ायदेमंद है: बड़ी रिपॉज़िटरी, छोटे मॉडल
चार सार्वजनिक रिपॉज़िटरी पर GitHub Copilot CLI के 664 हेडलेस रन, 1.6k से 219k ग्राफ़ नोड तक, haiku 4.5, sonnet 5 और opus 5.5 के साथ। kubernetes और vscode पर कोड ग्राफ़ ने संरचना वाले सवालों पर haiku की लागत घटाकर grep की लागत की 0.29 गुना कर दी। Sonnet ने लगभग एक चौथाई बचाया, opus ने कुछ नहीं, और छोटी रिपॉज़िटरी पर ग्राफ़ की वजह से sonnet को 40 से 50% ज़्यादा ख़र्च करना पड़ा।
नोट पढ़ें →
500 गुना तेज़ी जिसने कुछ भी नहीं गिना: WebGPU सिमुलेशन की छह चुप विफलताएँ
एक WebGPU पार्टिकल सिमुलेशन में छह बग ने कोई एरर नहीं दिया और भरोसेमंद लगने वाले नंबर लौटाए। हर एक कैसा दिखता था और क्या बदला गया।
नोट पढ़ें →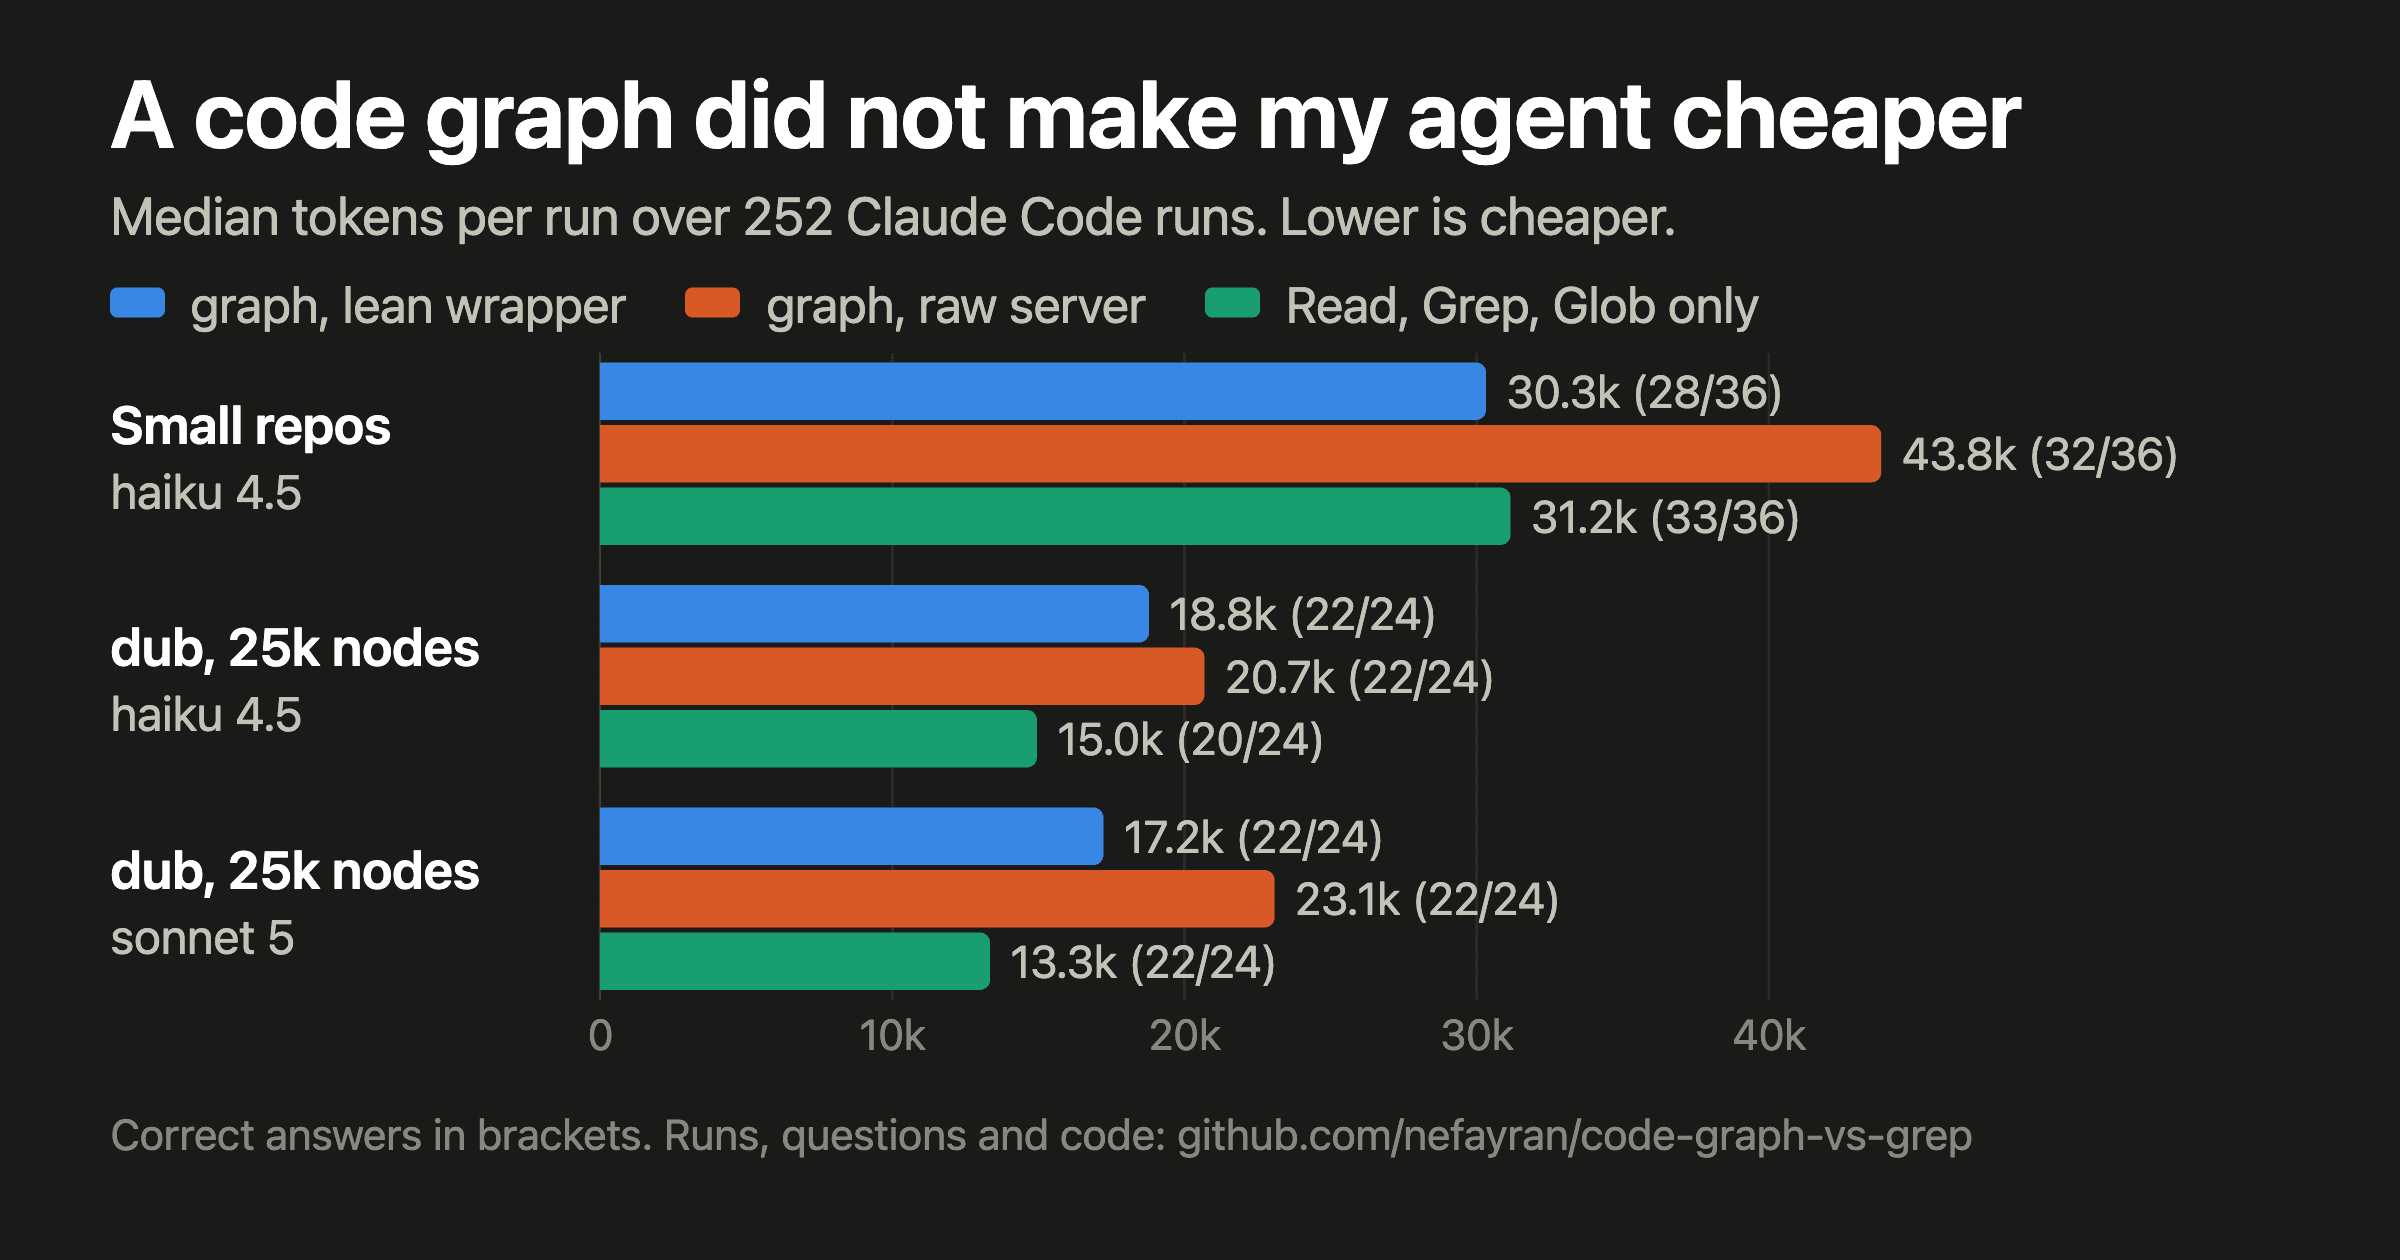
कोड ग्राफ़ से मेरा कोडिंग एजेंट सस्ता नहीं हुआ
सार्वजनिक रिपॉज़िटरी पर Claude Code के 252 हेडलेस रन, 1.6k से 25k ग्राफ़ नोड तक, haiku 4.5 और sonnet 5 के साथ। टोकन के मामले में ग्राफ़ कभी भी Read और Grep से आगे नहीं निकला, एक हल्का रैपर हमेशा कच्चे ग्राफ़ सर्वर से आगे रहा, और डिफ़ॉल्ट सेटिंग में एजेंट ने ग्राफ़ को मुश्किल से ही बुलाया।
नोट पढ़ें →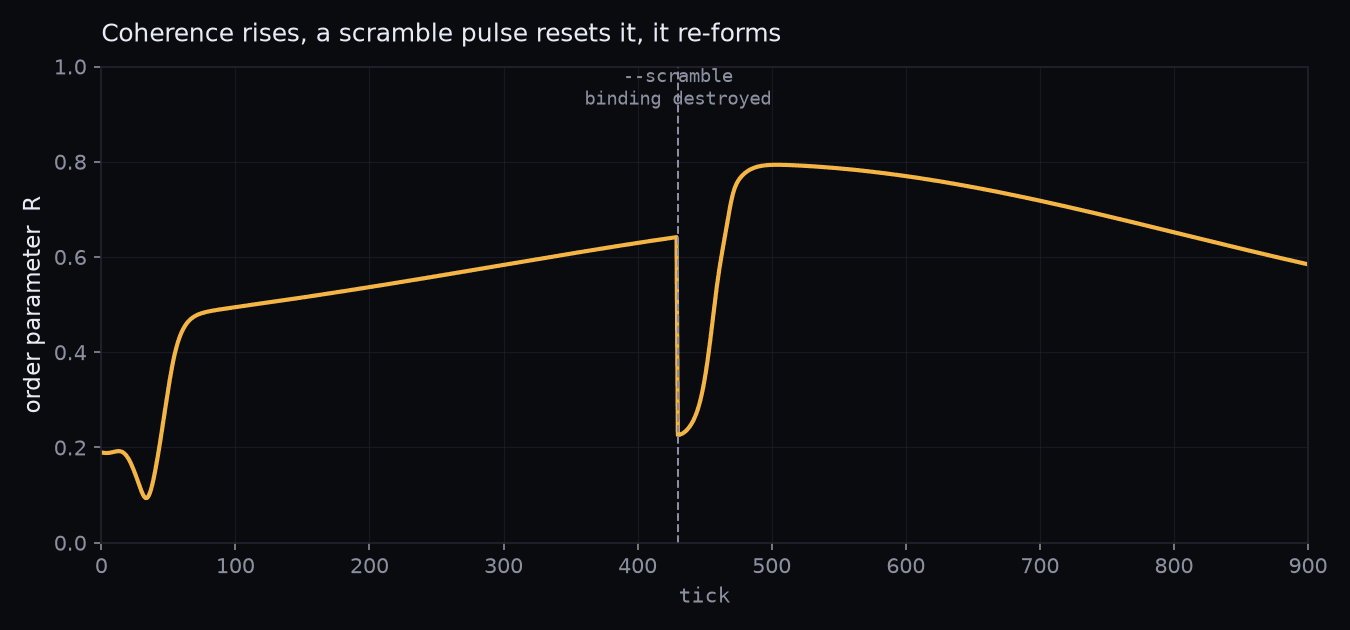
ऑसिलेटर, एम्बेडिंग और वह नियंत्रण जिसने हमारा झूठ पकड़ा
प्रयोग 002 में भाषा नोड्स की जगह कॉन्सेप्ट-न्यूरॉन आए, जो एक ही फ़ेज़ में फ़ायर करते हैं और एम्बेडिंग की समानता से जुड़े होते हैं। फ़ेज़ बिखेर देने वाले नियंत्रण में भी सुसंगत व्याख्या मिली, यानी अर्थ नेटवर्क से नहीं, फ़ील्ड पढ़ने वाले मॉडल से आ रहा था।
नोट पढ़ें →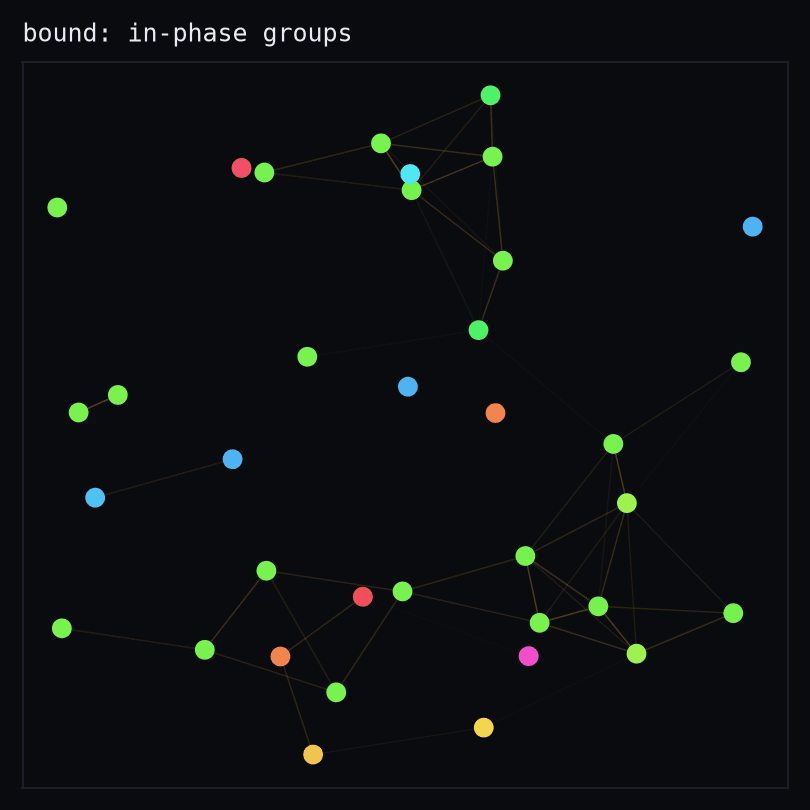
हमने भाषा मॉडलों को जोड़कर एक मन बनाया। वह एक वाक्य में सिमट गया।
एक ही भाषा मॉडल की आठ प्रतियों को बिना भूमिकाओं के एक घेरे में रखा गया और उनसे एक-दूसरे का विचार आगे बढ़ाने को कहा गया। वे एक ही वाक्य पर आ गईं और उसे दोहराती रहीं: मोड कोलैप्स। एक नकारात्मक परिणाम।
नोट पढ़ें →