4 अक्टूबर को मेरे Mac पर एक Pixal3D रन अपने टेक्सचर स्टेज में पहुँचा, और दस सेकंड के भीतर प्रोसेस 27 से बढ़कर 44 GB हो गया। उपलब्ध मेमोरी घटकर 6% रह गई और स्वैप 12 GB बढ़ गया, इसलिए जिस गार्ड के तहत मैं भारी जॉब चलाता हूँ, उसने रन को रोक दिया। Mac में 48 GB है। जब मेरे पास यह गार्ड नहीं था, तब दो Pixal3D रन, जिनमें से एक दूसरे भारी काम के साथ-साथ चल रहा था, Mac के रीबूट होने के साथ ख़त्म हुए।
Pixal3D एक इमेज को टेक्सचर वाले 3D मेश में बदलता है, और Pixal3D-mac Apple Silicon के लिए उसका पोर्ट है। 1024_cascade पाइपलाइन सात मॉडल बारी-बारी से चलाती है: मोटे ढाँचे के लिए एक फ़्लो मॉडल और एक डिकोडर, 512 और 1024 पर शेप के लिए दो फ़्लो मॉडल, एक शेप डिकोडर, और टेक्सचर के लिए एक फ़्लो मॉडल और एक डिकोडर। इनके इर्द-गिर्द चार इमेज फ़ीचर एक्सट्रैक्टर, एक बैकग्राउंड रिमूवर और एक कैमरा एस्टिमेटर काम करते हैं। हर स्टेज को इन सात में से एक या दो मॉडल चाहिए, और पोर्ट इन सभी को पहले सेकंड से आख़िरी सेकंड तक मेमोरी में रखता है।
मेमोरी वापस क्यों नहीं आती
Apple Silicon पर CPU और GPU मेमोरी का एक ही पूल साझा करते हैं। Pixal3D का low-VRAM मोड, जो डिफ़ॉल्ट रूप से चालू रहता है, निष्क्रिय मॉडलों को CPU पर रखता है और सक्रिय मॉडल को GPU पर कॉपी करता है। अलग ग्राफ़िक्स कार्ड वाले PC पर इससे वीडियो मेमोरी बचती है। Mac पर CPU वाली कॉपी और GPU वाली कॉपी एक ही RAM में रहती हैं, इसलिए यह मोड हर मॉडल को मेमोरी में बनाए रखता है और सक्रिय मॉडल की एक दूसरी कॉपी जोड़ देता है। साथ ही, चारों फ़ीचर एक्सट्रैक्टर एक ही DINOv3 बैकबोन लोड करते हैं, चार बार।
एक-एक स्टेज करके लोड करना
stageload एक छोटी लाइब्रेरी है जो मैंने इसी काम के लिए लिखी। यह पाइपलाइन की मॉडलों वाली डिक्शनरी को एक ऐसी डिक्शनरी से बदल देती है जो किसी मॉडल को तब लोड करती है जब कोई स्टेज पहली बार उसे माँगता है, और जो हर उस मॉडल को रिलीज़ कर देती है जो अगले स्टेज की सूची में नहीं है। रिलीज़ करने पर मॉड्यूल का हर टेंसर PyTorch के meta डिवाइस पर चला जाता है। इससे स्टोरेज तब भी ख़ाली हो जाता है जब कोई दूसरा कोड अब भी मॉड्यूल का रेफ़रेंस रखे हुए हो, और उसके बाद मॉड्यूल को कॉल करने पर PyTorch के अंदर कहीं फ़ेल होने के बजाय एक एरर raise होता है, जो उस मॉड्यूल का और उसे रिलीज़ करने वाले स्टेज का नाम बताता है।
पोर्ट का अपना run() बिना बदलाव के चलता है। हर स्टेज कहाँ शुरू होता है, यह जानने के लिए stageload पाइपलाइन के चार मेथड रैप करती है: बैकग्राउंड हटाना, इमेज की पहली कंडीशनिंग, हर शेप और टेक्सचर पास की कंडीशनिंग, और आख़िरी डिकोडिंग। चारों फ़ीचर एक्सट्रैक्टर इस तरह बनाए जाते हैं कि वे एक ही बैकबोन साझा करें।
इसका एक हिस्सा ऐसा है जो गड़बड़ होने पर कोई एरर नहीं देता। Pixal3D रन की शुरुआत में एक बार सीड करता है और फिर हर स्टेज का शोर CPU के रैंडम जेनरेटर से लेता है। मॉडल बनाते समय उसका रैंडम इनिशियलाइज़ेशन चलता है, जो उसी जेनरेटर से नंबर लेता है। इसलिए रन के बीच में lazy तरीक़े से बनाया गया मॉडल अपने बाद के हर स्टेज का शोर बदल देगा, और उसके साथ मेश भी। stageload हर लोड से पहले जेनरेटरों की स्थिति सहेज लेती है और बाद में उसे रीस्टोर करती है: torch के CPU, MPS और CUDA जेनरेटर, Python का random और NumPy का ग्लोबल जेनरेटर। एक डमी पाइपलाइन पर, जो पोर्ट की तरह ही सीड करती है और शोर लेती है, एक टेस्ट जाँचता है कि staged और eager रन बिट दर बिट एक जैसे लेटेंट देते हैं, और रीस्टोर बंद करने वाला एक कंट्रोल उन्हें एक-दूसरे से अलग होते देखता है।
सिर्फ़ Pixal3D के लिए नहीं
stageload का कोर Pixal3D के बारे में कुछ नहीं जानता। उसे किसी पाइपलाइन से तीन चीज़ें चाहिए: एक फ़ंक्शन जो हर मॉडल को अलग से बनाए, हर स्टेज में इस्तेमाल होने वाले मॉडलों की सूची, और हर स्टेज की शुरुआत पर एक कॉल। अपने कोड में यह कॉल एक लाइन है: models.enter("decode")। किसी और के कोड में, जैसे इस पोर्ट में, on_call इसे उस मेथड से जोड़ देता है जो उस जगह पहले से चलता है, इसलिए पाइपलाइन जैसी है वैसी ही रहती है। text-to-image पाइपलाइन का ढाँचा भी Pixal3D जैसा है: टेक्स्ट एनकोडर, डीनॉइज़र और इमेज डिकोडर एक के बाद एक चलते हैं। मेमोरी मीटर और गार्ड Mac पर किसी भी प्रोग्राम के लिए काम करते हैं। अब तक मैंने सिर्फ़ Pixal3D को मापा है; README में कोर को दो मॉडलों वाली एक छोटी पाइपलाइन पर दिखाया गया है, और वह उदाहरण एक टेस्ट के रूप में चलता है।
इससे क्या बदला
48 GB वाले इस M5 Pro पर मैंने पोर्ट की उदाहरण वाली इमेज को सीड 7 और 2048-पिक्सल टेक्सचर के साथ 1024_cascade से चलाया, हर मोड के दो रन, हर रन अपने अलग प्रोसेस में और गार्ड के तहत। “eager” का मतलब है पोर्ट की अपनी लोडिंग, और “staged” का मतलब है stageload। इस मशीन पर eager रन गार्ड की सीमाओं के भीतर टेक्सचर स्टेज पार नहीं कर पाते, इसलिए दोनों eager रन वहीं रुकते हैं जहाँ यह स्टेज शुरू होता है। eager के लिए टेक्सचर का नंबर 4 अक्टूबर के उस रन से आता है जो टेक्सचर स्टेज में पहुँचा था।
| स्टेज | eager, पीक फ़ुटप्रिंट | staged, पीक फ़ुटप्रिंट |
|---|---|---|
| setup | 20.4 GB | 2.9 GB |
| camera | 23.2 GB | 6.7 GB |
| structure | 22.2 GB | 10.9 GB |
| shape_512 | 26.6 GB | 11.4 से 11.5 GB |
| shape_1024 | 30.5 GB | 13.1 GB |
| texture | 44.2 GB पर गार्ड ने रोका | 30.1 GB |
| decode | नहीं पहुँचा | 17.9 से 18.4 GB |
| export | नहीं पहुँचा | 69.6 से 70.2 GB |
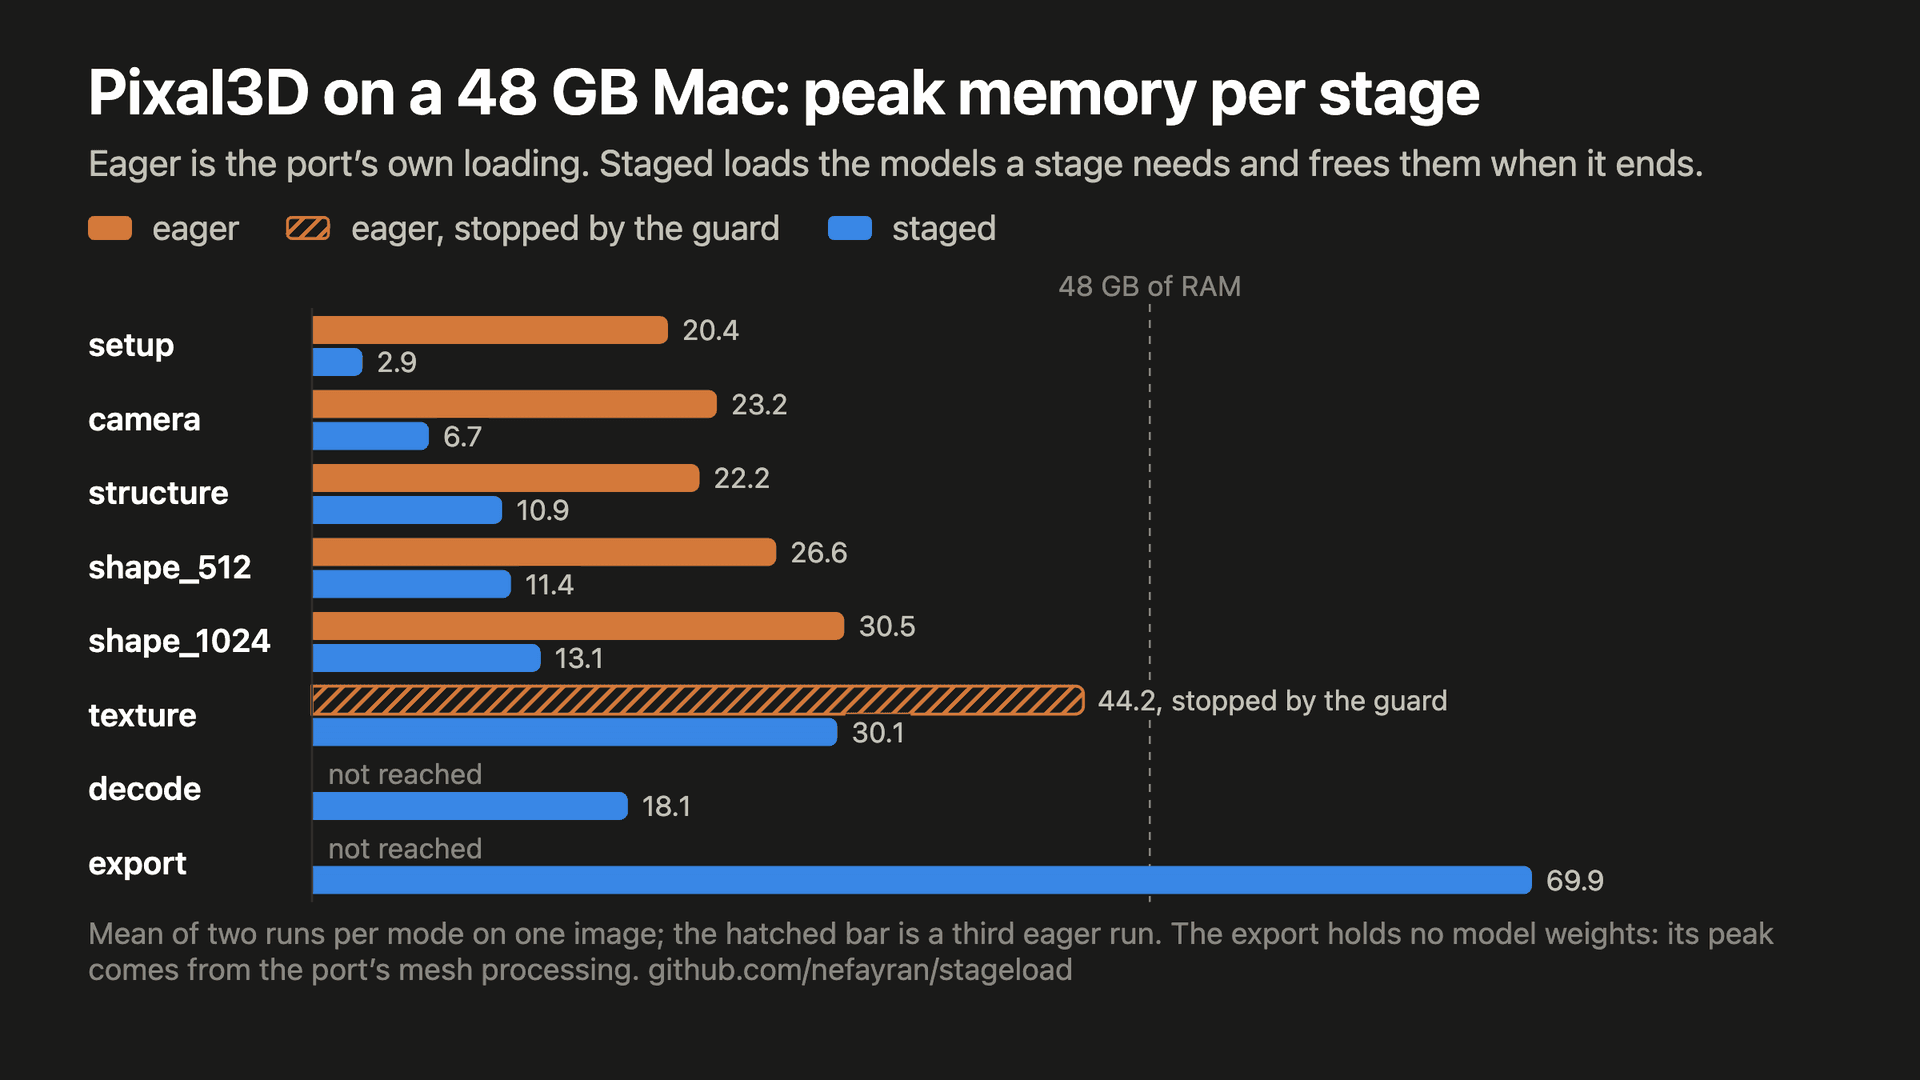
जो स्टेज दोनों मोड में चले, उन सभी में staged ने 11.3 से 17.5 GB कम मेमोरी घेरी। आठ लोड (सात मॉडल, और डिकोडिंग के लिए दूसरी बार शेप डिकोडर) ने 13.2 GB पढ़ा, और इसमें हर रन के लगभग दस मिनट में से 24 सेकंड लगे।
टेक्सचर स्टेज के 30 GB में से ज़्यादातर वर्किंग मेमोरी है: टेक्सचर मॉडल ख़ुद 2.6 GB का है। डिकोडिंग शुरू होने पर stageload ने उसे फ़ीचर एक्सट्रैक्टरों के साथ रिलीज़ किया और MPS एलोकेटर का कैश ख़ाली किया, और दो सेकंड के भीतर फ़ुटप्रिंट घटकर एक रन में 4.5 GB और दूसरे में 8.0 GB रह गया।
staged का सबसे ऊँचा नंबर, लगभग 70 GB, एक्सपोर्ट में आता है, जब मॉडलों के सारे वेट रिलीज़ हो चुके होते हैं। यह पोर्ट की मेश प्रोसेसिंग है (रीमेशिंग, UV अनरैपिंग, बेकिंग), जिसे stageload नहीं छूती। फ़ुटप्रिंट वह नंबर है जो Activity Monitor दिखाता है, और उसमें वह मेमोरी भी गिनी जाती है जिसे macOS ने कंप्रेस किया है, इसलिए यह RAM के 48 GB से ज़्यादा हो सकता है।
मैं क्या नहीं दिखा सका
पहली बात यह है कि staged लोडिंग नतीजे को बदलती है या नहीं। हर रन ने हर सैंपलर के आउटपुट का एक हैश और एक कॉपी सहेजी। पहला लेटेंट, यानी मोटा ढाँचा, चारों रन में बिट दर बिट एक जैसा है। 512 वाले शेप स्टेज से आगे, एक ही सीड होने पर भी पोर्ट MPS पर ख़ुद को नहीं दोहराता: दोनों eager रन शेप लेटेंट में 1.77 तक अलग हैं, और एक staged रन किसी eager रन से 1.24 से 1.86 तक अलग है। तो तुलना यह कहती है कि staged लोडिंग से आया कोई भी बदलाव पोर्ट के अपने उतार-चढ़ाव से बड़ा नहीं है, जिसे eager रन की उसी एक जोड़ी पर मापा गया। टेक्सचर लेटेंट और अंतिम मेश की तुलना बिल्कुल नहीं की गई, क्योंकि यहाँ eager रन उन तक कभी नहीं पहुँचते।
CPU पर बनाने से मदद नहीं मिली। stageload हर मॉडल को सीधे GPU पर बनाती है, और इससे एक ऐसा टेंसर बदल जाता है जो चेकपॉइंट में शामिल नहीं है: स्पार्स अटेंशन की रोटरी फ़्रीक्वेंसी, जो मॉडल बनते समय गिनी जाती हैं, 6e-8 तक अलग निकलती हैं। यह देखने के लिए कि क्या यही इन फ़र्क़ों की वजह है, मैंने एक staged पास चलाया जिसने हर मॉडल को CPU पर बनाया और फिर GPU पर ले गया, जैसा पोर्ट करता है। उसके लेटेंट eager रन से 1.84 और 1.12 अलग निकले, जो बाक़ी हर जोड़ी के फ़र्क़ के स्तर का ही है। लोडिंग में 24 सेकंड की जगह 82 सेकंड लगे, और तीन स्टेज का पीक 2.6 से 3.8 GB ऊँचा रहा, जबकि दो का कम निकला। मैं फिर से GPU पर बनाने पर लौट आया।
मेरे अपने सारांश में एक बग था जिसने एक नंबर को बढ़ा-चढ़ा दिया। वह हर स्टेज का पीक उस पल से लेता था जब स्टेज को शुरू हुआ दर्ज किया गया, लेकिन पिछले स्टेज के मॉडल रिलीज़ करने में 1.7 सेकंड तक लगते हैं। उस अंतराल के एक मेमोरी सैंपल ने CPU पर मॉडल बनाने वाले रन का डिकोड पीक 29.5 GB बता दिया; रिलीज़ ख़त्म होने के बाद से गिनें तो यह 16.7 है। एक कोड रिव्यू ने इसे पकड़ा। अब किसी स्टेज की विंडो तब शुरू होती है जब उसकी शुरुआत से ट्रिगर हुई रिलीज़ पूरी हो चुकी होती हैं।
गार्ड
ये रन stageload के एक दूसरे हिस्से, stageload guard, के ज़रिए चलाए गए, क्योंकि इस Mac पर दूसरे भारी जॉब भी चलते हैं। यह एक कमांड तभी शुरू करता है जब काफ़ी मेमोरी उपलब्ध हो और कुछ देर से भारी जॉब की सूची से मेल खाने वाला कोई प्रोसेस नज़र न आया हो। कमांड चलने के दौरान, अगर स्वैप एक बजट से आगे बढ़ जाए या उपलब्ध मेमोरी 10% से नीचे बनी रहे, तो यह कमांड का पूरा प्रोसेस ग्रुप रोक देता है। इसे root की ज़रूरत नहीं होती, और यह कभी भी सिर्फ़ उन्हीं प्रोसेस को रोकता है जिन्हें इसने ख़ुद शुरू किया था।
शांति का इंतज़ार एक विफलता से निकला। वीडियो जॉब की एक चेन उनके बीच छोटे अंतराल छोड़ती है, उनमें से एक अंतराल में एक रन शुरू हुआ, और अगले वीडियो जॉब ने 20 सेकंड के भीतर स्वैप को बजट के पार पहुँचा दिया। बेंचमार्क में हर रन तभी शुरू हुआ जब तीन मिनट तक कोई भारी जॉब नज़र नहीं आया।
दूसरी इमेज पर
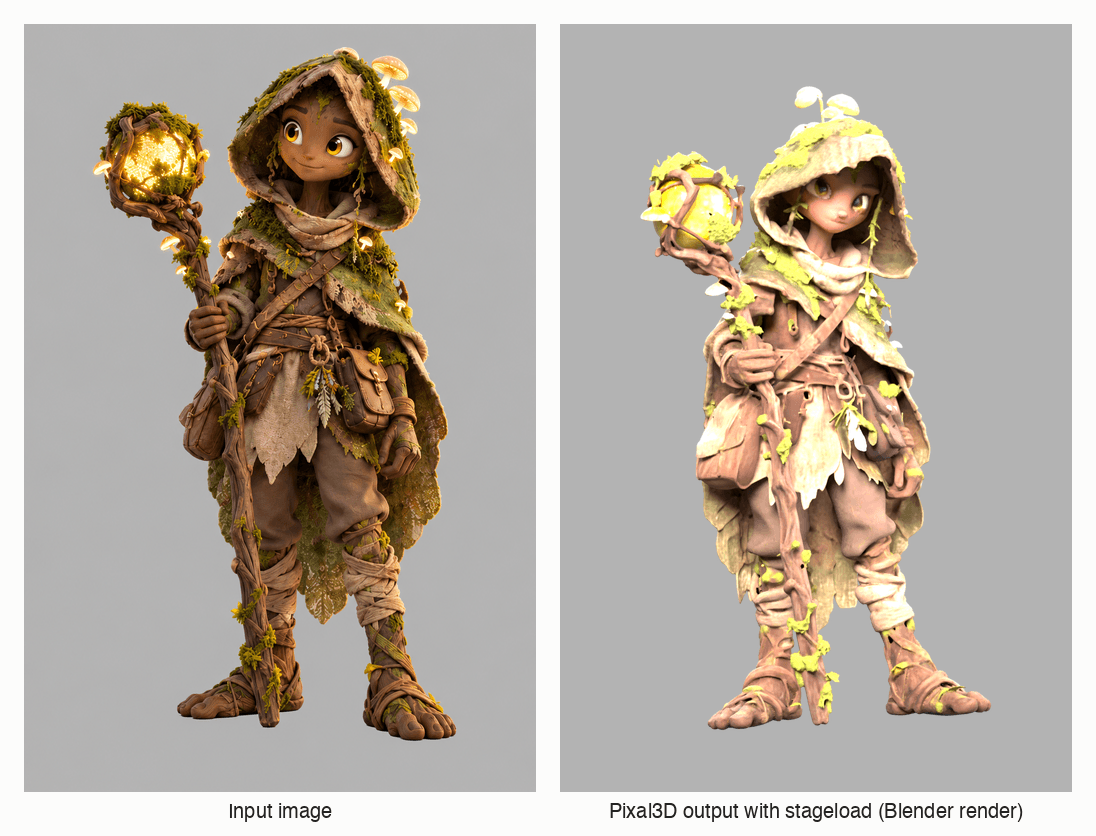
जो गेम मैं बना रहा हूँ, उसके एक किरदार पर वही staged रन 416 सेकंड चला और उसने वही 13.2 GB 37 सेकंड में लोड किए। इसके टेक्सचर स्टेज का पीक 30.1 GB रहा, जैसा उदाहरण वाली इमेज पर था। ये रहे इनपुट और रन से बना मेश, Blender में रेंडर किया हुआ:
कोड, हर रन के ट्रेस और ये चार्ट बनाने वाली स्क्रिप्ट रिपॉज़िटरी में हैं। Pixal3D का एडेप्टर Pixal3D-mac के एक कमिट पर टेस्ट किया गया है।