मेरे पिछले बेंचमार्क ने बताया था कि कोड ग्राफ़ से मेरा कोडिंग एजेंट सस्ता नहीं हुआ। इससे ज़्यादा कुछ कहने के लिए वह बहुत छोटा था: 24 सवाल, 25k ग्राफ़ नोड से बड़ा कुछ नहीं, कोई Opus नहीं। इसलिए मैंने उसे ऐसे पैमाने पर दोबारा चलाया जहाँ जवाब बदल सकता था, और योजना पहले ही लिख ली। परिकल्पनाएँ, रिपॉज़िटरी, बजट और विश्लेषण PLAN-v2.md में हैं, जिसे किसी भी रन से पहले कमिट किया गया था।
संक्षेप में: ग्राफ़ तब फ़ायदा देता है जब उसके बिना मॉडल खोजता ही रहता। kubernetes और vscode पर haiku ठीक यही मामला है। वहाँ sonnet थोड़ा बचाता है और opus कुछ नहीं, और छोटी रिपॉज़िटरी पर ग्राफ़ sonnet के लिए सादे grep से महँगा पड़ता है।
सेटअप
एजेंट GitHub Copilot CLI 1.0.90 है, जिसे हर सत्र में एक सवाल के साथ हेडलेस चलाया गया, और विकल्प दो हैं:
- grep: Copilot के view, grep और glob टूल, और कुछ नहीं;
- ग्राफ़: वही तीन टूल, साथ में cbm-lean (codebase-memory-mcp 0.9.0 के चारों ओर मेरा पतला रैपर) और प्रॉम्प्ट की शुरुआत में एक रूटिंग नियम: कॉल करने वाले और बुलाए जाने वाले फ़ंक्शन तथा कॉल चेन के लिए ग्राफ़, सटीक स्ट्रिंग के लिए grep।
चार सार्वजनिक रिपॉज़िटरी, हर एक किसी कमिट पर पिन की गई:
| रिपॉज़िटरी | भाषा | ग्राफ़ नोड |
|---|---|---|
| full-stack-fastapi-template | Python, TypeScript | 1,601 |
| dub | TypeScript | 25,023 |
| kubernetes | Go | 146,421 |
| vscode | TypeScript | 218,883 |
हर रिपॉज़िटरी में 16 सवाल हैं। आठ संरचना वाले हैं: किसी फ़ंक्शन को कौन बुलाता है, वह क्या बुलाता है, किसी CLI कमांड
या HTTP हैंडलर से किसी नामित फ़ंक्शन तक का कॉल पाथ, और किसी सिग्नेचर के बदलने पर कौन-से फ़ंक्शन टूटते हैं। आठ सटीक
हैं: कोई कॉन्फ़िग मान, कोई एनवायरनमेंट वेरिएबल कहाँ पढ़ा जाता है, वह लाइन जिस पर कोई एरर raise होता है, वह लाइन जिस
पर कोई टाइप परिभाषित है। हर उत्तर कुंजी मैंने पिन किए गए कमिट पर हाथ से जाँची, और कुंजी की कोई प्रविष्टि तभी गिनी
जाती है जब वह पूरे शब्द के रूप में मिले, इसलिए init_db को init नहीं माना जाता।
Haiku 4.5 ने हर विकल्प में सभी 64 सवालों के जवाब तीन बार दिए, और sonnet 5 ने दो बार। Copilot में Opus 5.5 के एक प्रॉम्प्ट की क़ीमत 15 प्रीमियम रिक्वेस्ट है, इसलिए उसने kubernetes और vscode के बारह संरचना वाले सवालों के जवाब एक बार दिए। यानी कुल 664 रन और लगभग 744 प्रीमियम रिक्वेस्ट।
लागत पहले नोट की तरह tokenEquiv है: बिना कैश वाला इनपुट, जमा 1.25 × कैश राइट, जमा 0.1 × कैश रीड, एक रन की सभी मॉडल कॉल पर जोड़कर।
नतीजे
grep की लागत के अनुपात में ग्राफ़ की लागत: हर सवाल के लिए दोहरावों पर ग्राफ़ वाले विकल्प की मध्यिका को grep वाले विकल्प की मध्यिका से भाग दिया गया, फिर सवालों पर मध्यिका ली गई, 95% बूटस्ट्रैप अंतराल के साथ। 1 से कम होने पर ग्राफ़ सस्ता है।
| मॉडल | रिपॉज़िटरी का आकार | संरचना वाले सवाल | सटीक सवाल |
|---|---|---|---|
| haiku 4.5 | छोटी (1.6k नोड) | 0.88 (0.65–1.29) | 0.92 (0.72–1.15) |
| haiku 4.5 | मध्यम (25k) | 0.61 (0.11–1.50) | 0.96 (0.75–1.37) |
| haiku 4.5 | बड़ी (146k, 219k) | 0.29 (0.11–0.70) | 1.01 (0.94–1.28) |
| sonnet 5 | छोटी | 1.51 (1.45–1.70) | 1.42 (1.20–1.71) |
| sonnet 5 | मध्यम | 0.94 (0.57–2.00) | 1.14 (1.05–1.30) |
| sonnet 5 | बड़ी | 0.74 (0.62–0.92) | 1.13 (1.01–1.29) |
| opus 5.5 | बड़ी | 0.97 (0.72–1.10) | – |
संरचना वाले सवालों पर सही जवाब, ग्राफ़ बनाम grep:
| मॉडल | छोटी | मध्यम | बड़ी |
|---|---|---|---|
| haiku 4.5 | 13/24 बनाम 19/24 | 20/24 बनाम 22/24 | 38/47 बनाम 33/48 |
| sonnet 5 | 13/16 बनाम 15/16 | 16/16 बनाम 16/16 | 32/32 बनाम 28/32 |
| opus 5.5 | – | – | 12/12 बनाम 12/12 |
लागत और सटीकता एक साथ, संरचना वाले सवालों पर प्रति सही जवाब tokenEquiv के रूप में:
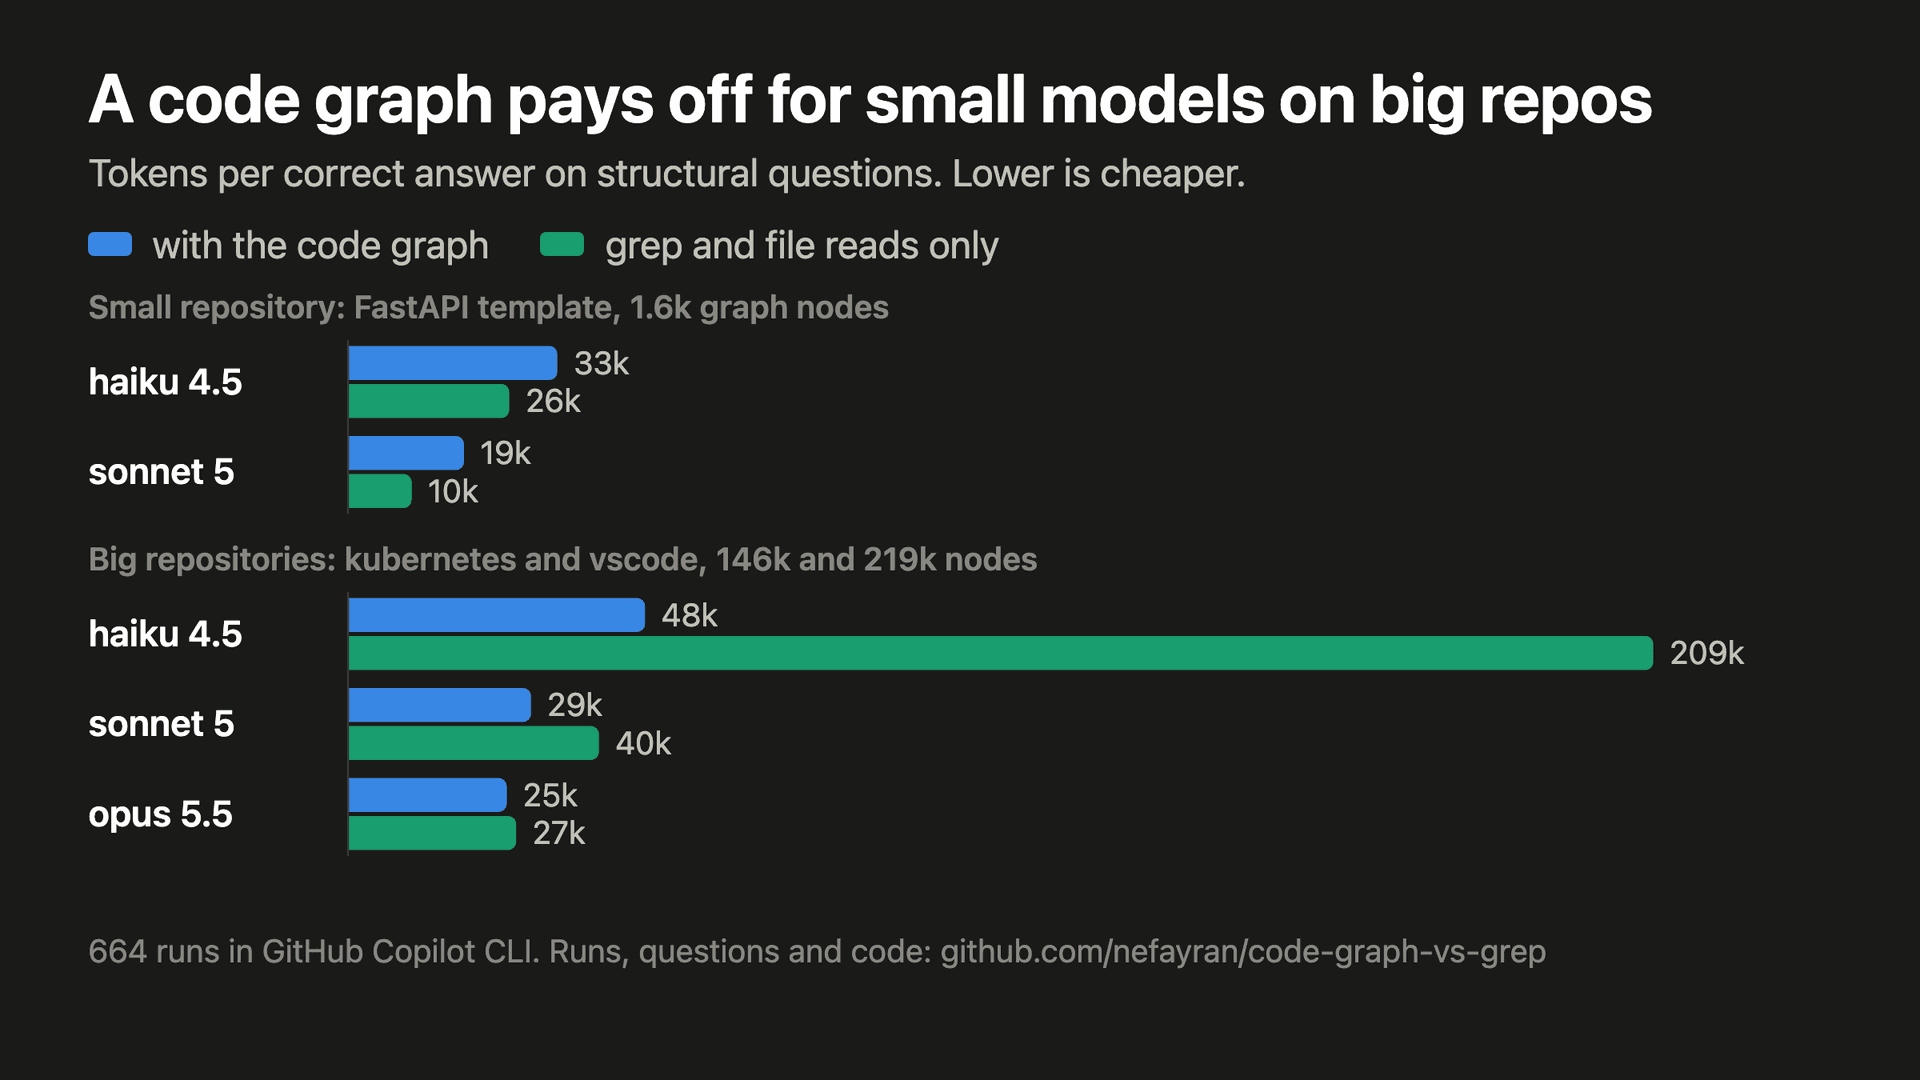
टिकने वाले नतीजे:
- kubernetes और vscode पर संरचना वाले सवालों में ग्राफ़ के साथ haiku का ख़र्च grep के साथ हुए ख़र्च का 0.29 गुना था, और 16 में से 15 सवालों पर वह सस्ता रहा। वह ज़्यादा बार सही भी था, इसलिए प्रति सही जवाब फ़ासला 47k बनाम 209k tokenEquiv का है। 13 टेस्ट पर Holm सुधार के बाद भी टिकने वाला यही अकेला नतीजा है (p = 0.006)।
- उन्हीं सवालों पर sonnet का अनुपात 0.74 रहा, वह 16 में से 12 पर सस्ता था, और 32 में से 32 जवाब सही थे, बनाम 32 में से 28। Opus का अनुपात 0.97 रहा, वह 12 में से 7 पर सस्ता था, और दोनों विकल्पों में हर जवाब सही था।
- छोटी रिपॉज़िटरी पर ग्राफ़ से कभी फ़ायदा नहीं हुआ। Haiku ने लगभग उतना ही ख़र्च किया और संरचना वाले सवालों के जवाब ज़्यादा बार ग़लत दिए। Sonnet ने 42 से 51% ज़्यादा ख़र्च किया।
- सटीक सवालों पर ग्राफ़ से haiku के लिए कोई मापने लायक़ फ़र्क़ नहीं पड़ा, और sonnet ने इसके लिए 13 से 42% ज़्यादा चुकाया।
- ग्राफ़ के टूल स्कीमा और रूटिंग नियम हर मॉडल कॉल में तय संख्या में प्रॉम्प्ट टोकन जोड़ते हैं: haiku के लिए 1.56k और sonnet व opus के लिए 2.07k, रिपॉज़िटरी का आकार चाहे जो हो।
छोटे मॉडल को सबसे ज़्यादा फ़ायदा क्यों होता है
मॉडल कॉल गिनें। grep के साथ संरचना वाले एक जवाब पर haiku की कॉल की मध्यिका kubernetes पर 22 और vscode पर 20 थी, और असर वाले एक सवाल में 114 कॉल लगीं। ग्राफ़ के साथ यह मध्यिका 5 और 4 थी। हर कॉल पूरी बातचीत दोबारा भेजती है, इसलिए लंबी खोज अपनी कॉल की गिनती से जितनी लगती है, उससे कहीं ज़्यादा महँगी पड़ती है: haiku का सबसे महँगा grep जवाब 471k tokenEquiv तक पहुँचा।
grep के साथ sonnet की खोजें छोटी थीं: 8 कॉल, बनाम ग्राफ़ के साथ 4। Opus ने दोनों विकल्पों में 4 या 5 कॉल लीं, इसलिए ग्राफ़ के पास घटाने को कुछ था ही नहीं, और जो थोड़ा-बहुत उसने बचाया, उसे उसका तय ओवरहेड खा गया।
मेरा अनुमान, जिसे मैंने सीधे नहीं परखा: ग्राफ़ खोज के टर्न की जगह लेता है, इसलिए वह तब फ़ायदा देता है जब उसके बिना मॉडल को ऐसे बहुत-से टर्न लेने पड़ते, यानी बड़ी रिपॉज़िटरी पर कमज़ोर मॉडल। मज़बूत मॉडल grep के साथ पहले से ही कुशलता से खोजता है, और छोटी रिपॉज़िटरी पर किसी को बहुत-से टर्न की ज़रूरत नहीं पड़ती।
Copilot प्रीमियम रिक्वेस्ट का बिल प्रति प्रॉम्प्ट बनाता है, कॉल चाहे कितनी भी हों, इसलिए Copilot के अंदर ग्राफ़ से पैसे नहीं बचते। समय बचता है: बड़ी रिपॉज़िटरी पर haiku के संरचना वाले जवाबों में लगे समय की मध्यिका ग्राफ़ के साथ 71 सेकंड और grep के साथ 157 सेकंड रही। छोटी रिपॉज़िटरी पर ग्राफ़ वाला विकल्प धीमा था।
हर विकल्प कहाँ ग़लत हुआ
linesनाम का एक फ़ील्ड। यह पूछे जाने पर किHorizontalControllerकिस लाइन पर परिभाषित है, ग्राफ़ वाले विकल्प ने पाँचों रन में horizontal.go:43 बताया, haiku और sonnet दोनों ने। स्ट्रक्ट लाइन 93 से शुरू होता है और 43 लाइन लंबा है। codebase-memory-mcp जो स्निपेट लौटाता है, उसमें"start_line": 93,"end_line": 135और"lines": 43होते हैं, और मॉडलों ने आख़िरी वाले को लाइन नंबर समझ लिया।LemonSqueezyClientके साथ यही फिर हुआ (लाइन 59 पर परिभाषित और 129 लाइन लंबी एक क्लास के लिए client.ts:129), और haiku नेCursorsControllerके साथ भी यही किया। मेरे पहले नोट में उस client.ts:129 का दोष "ग्राफ़ से मिले लाइन नंबरों" पर डाला गया था; वह असल में यहीं से आया था। grep वाले sonnet ने तीनों सही बताए। cbm-lean अब यह फ़ील्डline_countनाम से आगे भेजता है।- ग्राफ़ के छेद, जिन पर भरोसा कर लिया गया।
from x import yसे इम्पोर्ट किए गए फ़ंक्शन को जब सीधे नाम से बुलाया जाता है, तो codebase-memory-mcp 0.9.0 उसके लिए कोई कॉल एज दर्ज नहीं करता। यह पूछे जाने पर किrecover_passwordक्या बुलाता है, ग्राफ़ वाले विकल्प ने पाँचों रन में "सिर्फ़ get_user_by_email" जवाब दिया, haiku और sonnet दोनों ने, सीधे ग्राफ़ से और एक भी grep किए बिना। यह फ़ंक्शनgenerate_password_reset_token,generate_reset_password_emailऔरsend_emailको भी बुलाता है, और grep वाले विकल्प ने हर बार चारों ढूँढ लिए। - एक छूटा हुआ डैश। Copilot का grep टूल लाइन नंबर तभी दिखाता है जब उसे
"-n": trueमिले, और उसका view टूल फ़ाइल को बिना लाइन नंबरों के लौटाता है। Sonnet ने अपनी 571 grep कॉल में से 508 में-nपास किया और opus ने सभी 53 में। Haiku ने 1,949 कॉल में से 920 बारnपास किया, बिना डैश के, और 22 बार-n। टूल अनजान कुंजी को अनदेखा कर देता है, इसलिए haiku को नंबर नहीं मिले, उसने देखी गई फ़ाइल में लाइनें गिनीं और थोड़े अंतर से चूक गया: लाइन 112 पर raise होने वाले एक एरर के लिए उसने 105, 107, 108 और 113 बताया। सटीक सवालों पर haiku के 79 ग़लत जवाबों में से एक को छोड़कर सभी में लाइन नंबर ग़लत है। - लंबी खोजें, जो फिर भी नाकाम रहती हैं।
kubeadm token createसेencodeTokenSecretDataतक की कॉल चेन पर grep वाले haiku ने 18 से 22 कॉल लीं और तीनों बार पाथ ग़लत बताया। ग्राफ़ के साथ भी वह ग़लत था। Sonnet दोनों विकल्पों में सही था। - grep वाले विकल्प में haiku ने तीन बार bash बुलाने की कोशिश की। Copilot ने मना कर दिया, क्योंकि वहाँ वह टूल है ही नहीं, इसलिए किसी भी रन ने अपने विकल्प से बाहर का टूल इस्तेमाल नहीं किया।
पहले नोट के बाद क्या बदला
पहले नोट ने कहा था कि 25k नोड तक की रिपॉज़िटरी पर Claude मॉडल के साथ ग्राफ़ से टोकन बचत की उम्मीद न करें। उन आकारों पर यह अब भी सही है। उनसे ऊपर क्या होता है, यह उस नोट में छूट गया था: kubernetes और vscode पर छोटे मॉडल फ़ायदे में रहते हैं, और मॉडल जितना छोटा, फ़ायदा उतना ज़्यादा।
ग्राफ़ को एजेंट से जोड़ रही टीम से मैं क्या कहूँगा
- पहले अपनी सबसे बड़ी रिपॉज़िटरी पर अपने सबसे सस्ते मॉडल के साथ मापें। ग्राफ़ वहीं अपनी जगह कमाता है।
- छोटी या मध्यम रिपॉज़िटरी पर मज़बूत मॉडल के साथ ग्राफ़ को बाहर ही रखें। आप हर कॉल पर उसके स्कीमा की क़ीमत चुकाते हैं और बदले में कुछ नहीं मिलता।
- सटीक सवाल grep को ही भेजते रहें। उन पर ग्राफ़ कभी नहीं जीता।
- मॉडल को ग्राफ़ के आउटपुट से लाइन नंबर या "यही पूरी सूची है" जैसी बात भरोसे पर न लेने दें।
linesजैसे फ़ील्ड मॉडल तक पहुँचने से पहले हटा दें या उनका नाम बदल दें।
सीमाएँ
- एक एजेंट हार्नेस (Copilot CLI) और एक ग्राफ़ (मेरे रैपर के पीछे codebase-memory-mcp 0.9.0)। Claude Code, कोई दूसरा ग्राफ़ या नया वर्ज़न अलग आँकड़े दे सकते हैं।
- छोटी और मध्यम रिपॉज़िटरी पर हर सेल में आठ सवाल। Holm सुधार के तहत 13 टेस्ट होने पर आठ सवालों वाला सेल सांख्यिकीय सार्थकता तक नहीं पहुँच सकता, भले ही ग्राफ़ हर सवाल जीत ले, इसलिए सिर्फ़ बड़ी रिपॉज़िटरी पर haiku का नतीजा सार्थक है।
- Opus ने बारह सवालों के जवाब दिए, हर एक का एक बार।
- tokenEquiv में आउटपुट टोकन शामिल नहीं हैं। उन्हें गिनने पर बड़ी रिपॉज़िटरी पर haiku का फ़ासला और बढ़ जाता: वहाँ grep के साथ उसके जवाबों में आउटपुट टोकन की मध्यिका 7.0k थी, बनाम ग्राफ़ के साथ 0.9k।
- haiku का एक रन Copilot के सत्र खोलने से पहले ही विफल हो गया, और उसे गिनती से बाहर रखा गया है। sonnet के तीन रन किसी भी मॉडल कॉल से पहले Copilot की मॉडल सूची नहीं ला पाए, और उन्हें दोबारा चलाया गया। दोनों बातें योजना में दर्ज हैं।
दोहराएँ
सब कुछ code-graph-vs-grep में है: रन से पहले लिखी गई योजना, हर उत्तर कुंजी के सबूत के साथ सवाल, ड्राइवर, सभी 664 रन उनके जवाबों के साथ, और विश्लेषण।
node bench/run-copilot.mjs --model claude-haiku-4.5 --reps 3 --out results/v2/claude-haiku-4.5.json
python3 bench/stats-v2.py results/v2/*.json