Mac पर जब किसी PyTorch job की मेमोरी कम पड़ती है, तो error के आख़िर में एक सलाह होती है:
RuntimeError: MPS backend out of memory (MPS allocated: 18.50 GiB, other allocations: 448.00 KiB, max allowed: 18.72 GiB). Tried to allocate 512.00 MiB on shared pool. Use PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.0 to disable upper limit for memory allocations (may cause system failure).मैं जानना चाहता था कि इस सलाह पर चलने से क्या होता है, इसलिए मैंने अपने M5 Pro पर, जिसमें 48 GB है (macOS 26.5.2 और PyTorch 2.14.0), MPS मेमोरी को 512 MiB के क़दमों में भरा, हर सेटिंग के लिए एक बार, एक guard के साथ जो swap के 2 GB बढ़ते ही process रोक देता है। इससे दो बातें निकलीं। इस Mac पर डिफ़ॉल्ट सीमा RAM से ज़्यादा है, इसलिए जिस job की मेमोरी कम पड़ती है वह swap में फिसल जाता है और इस error तक पहुँचता ही नहीं। और सीमा घटाने के लिए एक नहीं, दो variables चाहिए।
“max allowed” कहाँ से आता है
max allowed सीमा है: PYTORCH_MPS_HIGH_WATERMARK_RATIO गुणा वह, जो torch.mps.recommended_max_memory() लौटाता है। मेरे Mac पर यह 37.44 GiB है, और 0.5 × 37.44 = 18.72 GiB, यानी ऊपर वाले error का नंबर। मेरे log में MPS allocated का मान torch.mps.current_allocated_memory() से मिलता था, यानी tensors की ली हुई मेमोरी। अपना आधार नंबर देखने के लिए:
import torch
print(torch.mps.recommended_max_memory() / 2**30, "GiB")
48 GB वाला Mac पहले swap में क्यों जाता है
PyTorch के documentation के मुताबिक़ high ratio का डिफ़ॉल्ट मान 1.7 है। मेरे Mac पर इससे सीमा लगभग 63.6 GiB हो जाती है, जो मशीन की मेमोरी से ज़्यादा है। हर सेटिंग का नतीजा यह रहा:
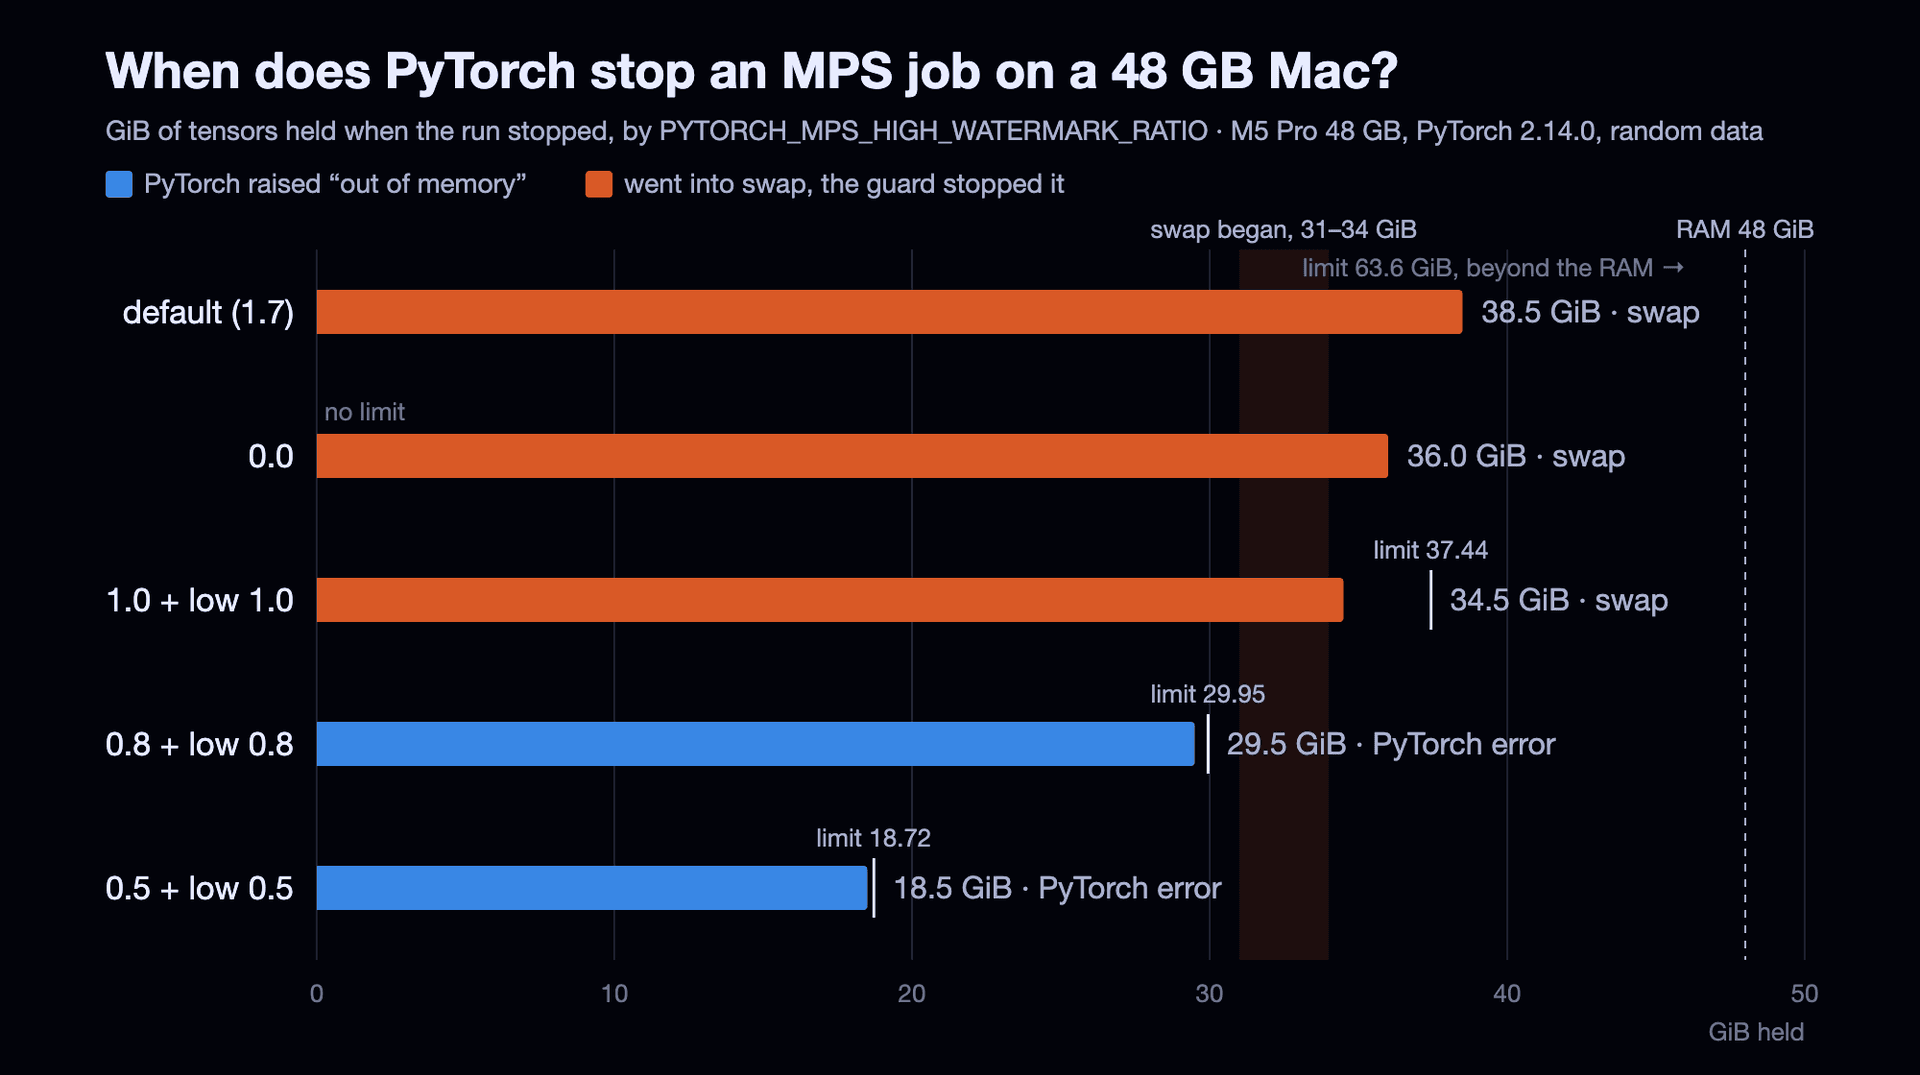
| सेटिंग | भरना किसने रोका | रखे गए tensors | run के दौरान swap |
|---|---|---|---|
| डिफ़ॉल्ट (1.7) | guard | 38.5 GiB | 6.1 → 12.0 GB |
| 0.0 | guard | 36.0 GiB | 5.1 → 9.8 GB |
| 1.0, low 1.0 | guard | 34.5 GiB | 4.6 → 8.7 GB |
| 0.8, low 0.8 | PyTorch, max allowed 29.95 GiB | 29.5 GiB | कोई बदलाव नहीं |
| 0.5, low 0.5 | PyTorch, max allowed 18.72 GiB | 18.5 GiB | कोई बदलाव नहीं |
डिफ़ॉल्ट, 0.0 और 1.0 के साथ, जैसे ही process 33.5 से 36.2 GB के पार गया, swap बढ़ने लगा, और PyTorch ने कभी error नहीं दिया: उसकी सीमा RAM के ख़त्म होने से भी आगे थी। तो error के अंदर की सलाह 0.0 ने यहाँ कोई दिखने वाला फ़र्क़ नहीं डाला। सीमा पहले से ही पहुँच से बाहर थी, और PyTorch में कुछ भी run को नहीं रोक रहा था।
सेट कैसे करें: दो variables
सिर्फ़ high ratio सेट करने पर पहली MPS call पर ही गड़बड़ होती है:
$ PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 python fill.py
RuntimeError: invalid low watermark ratio 1.4
Apple Silicon पर low ratio का डिफ़ॉल्ट 1.4 है और यह high से ज़्यादा नहीं हो सकता (सिवाय तब, जब high 0.0 हो, जिससे सीमा बंद हो जाती है)। दोनों सेट करें:
PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 PYTORCH_MPS_LOW_WATERMARK_RATIO=0.8 python run.pyPython से सेट करना हो, तो पहला tensor mps पर जाने से पहले करें। PyTorch इन्हें import torch के समय नहीं, बल्कि MPS शुरू होने पर पढ़ता है, और उसके बाद के बदलावों को अनदेखा करता है:
import os
os.environ["PYTORCH_MPS_HIGH_WATERMARK_RATIO"] = "0.8"
os.environ["PYTORCH_MPS_LOW_WATERMARK_RATIO"] = "0.8"
import torch
Documentation low ratio को soft limit कहता है और लिखता है कि “setting 0.0 disables adaptive commit and garbage collection”। मैंने इसे high के बराबर रखा और अलग से नहीं मापा।
मान कैसे चुनें
सीमा उस मेमोरी से नीचे रहनी चाहिए जो आपके Mac पर आपके रोज़ के apps खुले रहते हुए सच में ख़ाली है। मेरे Mac पर 1.0 (37.44 GiB) पहले ही ज़्यादा था, और 0.8 (29.95 GiB) ने बिना swap के साफ़ error दिया। साफ़ error के बाद आप batch size या resolution घटाकर दोबारा कोशिश कर सकते हैं; swap में फिसलता run पहले पूरे Mac को धीमा कर देता है।
जाँचते समय एक जाल
मेरे पहले run ने tensors को torch.ones से भरा था। डिफ़ॉल्ट सेटिंग के साथ वह मेरी रखी 46 GiB की सीमा तक बिना error और बिना किसी swap के पहुँच गया: macOS एक जैसे मानों वाले pages को लगभग शून्य तक compress कर देता है। Model weights इस तरह compress नहीं होते, इसलिए Mac पर मेमोरी की जाँच के लिए random data चाहिए।
जब model सच में नहीं समाता
साफ़ error सिर्फ़ इतना बताता है कि model नहीं समाता। कई models वाली pipeline में सिर्फ़ मौजूदा stage के models लोड करना किसी भी ratio से ज़्यादा काम करता है, इसीलिए मैंने stageload लिखा। भरने वाली script और ऊपर के हर run के traces उसकी repository में हैं, bench/results/2026-10-13-mps-watermark में।