Qwen-Image-2.1 diffusers में QwenImage21Pipeline से चलता है। bfloat16 में इसका टेक्स्ट एनकोडर 16.3 GB, transformer 13.3 GB और VAE 1.3 GB लेता है, इसलिए 48 GB वाले Mac पर लोड की हुई पाइपलाइन 31.4 GB तक पहुँची, और 1024 × 1024 की इमेज डिकोड करने पर वह 11 GB और ऊपर गई। यह गाइड दिखाती है कि उस Mac पर सामान्य तरीके का क्या हुआ, model CPU offload ने मदद क्यों नहीं की, और वह तरीका जो पूरा चला: दो बड़े मॉडलों में से एक समय में सिर्फ़ एक मेमोरी में।
रन 48 GB वाले Apple M5 Pro पर, torch 2.14.0 और main से लिए गए diffusers 0.41.0.dev0 के साथ हुए। QwenImage21Pipeline diffusers 0.41.0 रिलीज़ में भी है, पर उसके साथ मैंने रन नहीं किया। हर रन ने 20 स्टेप में, seed 7 के साथ, एक 1024 × 1024 इमेज बनाई, एक मेमोरी गार्ड के तहत जो स्वैप 8 GB बढ़ते ही रन रोक देता था।
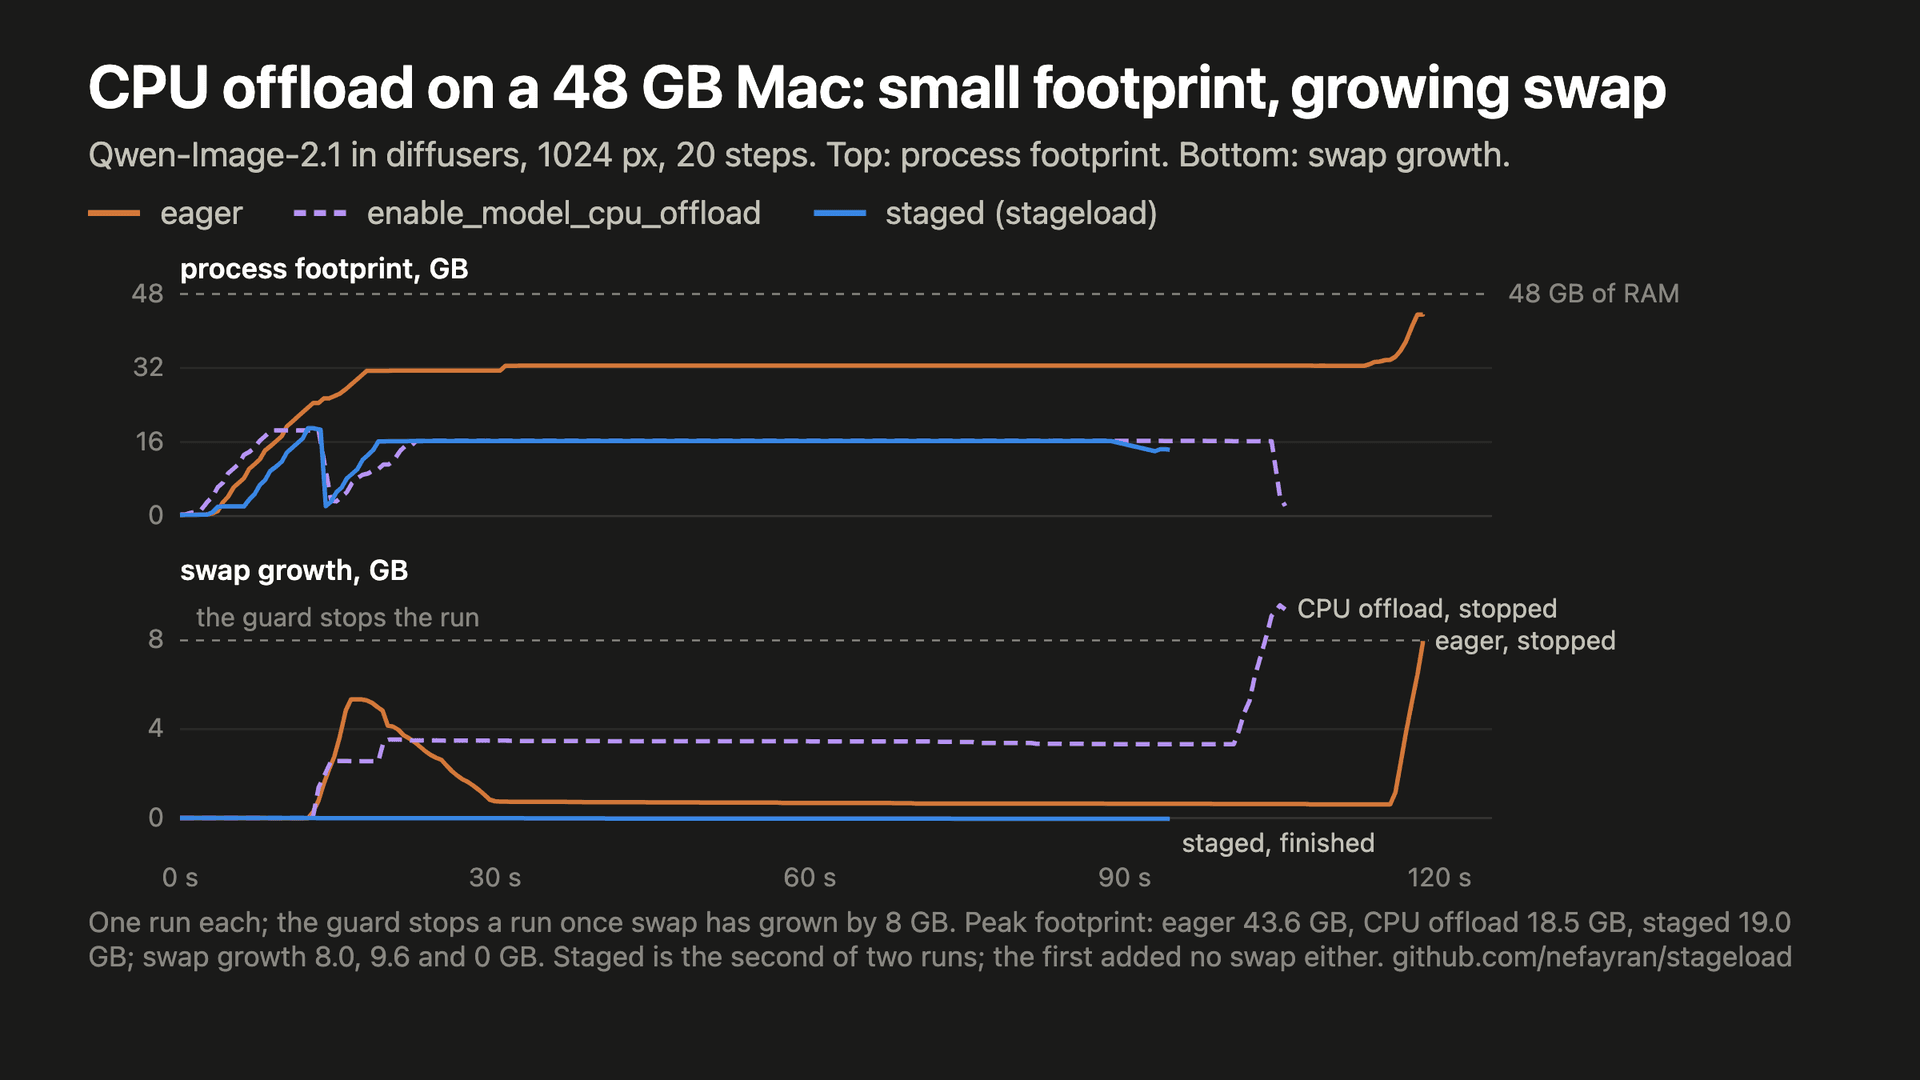
eager डिकोड में स्वैप में चला जाता है
सामान्य कोड तीनों मॉडल GPU पर लोड करता है और उन्हें वहीं रखता है:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("mps")
image = pipe(prompt=prompt, width=1024, height=1024, num_inference_steps=20).images[0]
इसने एनकोडिंग और डीनॉइज़िंग के सभी 20 स्टेप 31 से 33 GB पर पूरे किए। फिर VAE डिकोड ने footprint को 32.5 से 43.6 GB पर पहुँचा दिया और स्वैप 8 GB बढ़ गया, इसलिए गार्ड ने इमेज लिखे जाने से पहले रन रोक दिया। उससे पहले PyTorch ने मेमोरी खत्म होने की कोई एरर नहीं दी; उसकी जगह Mac स्वैप में चला गया।
Mac पर model CPU offload मदद क्यों नहीं करता
जो पाइपलाइन मेमोरी में नहीं समाती, उसके लिए diffusers में model CPU offload पहले से मौजूद है: हर मॉडल CPU पर इंतज़ार करता है और सिर्फ़ चलते समय GPU पर जाता है।
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.enable_model_cpu_offload(device="mps")
Mac पर CPU और GPU एक ही मेमोरी साझा करते हैं, इसलिए "CPU पर" इंतज़ार करने वाला मॉडल भी उसी RAM में रहता है। offload के इकलौते रन में प्रोसेस का footprint कभी 18.5 GB से ऊपर नहीं गया, जिससे लगता है कि सब समा गया। फिर भी स्वैप बढ़ा: डीनॉइज़िंग के दौरान 3.5 GB और VAE डिकोड में 9.6 GB तक, और गार्ड ने रन को वहीं रोका जहाँ उसने eager को रोका था। footprint, यानी वह संख्या जो Activity Monitor किसी प्रोसेस के लिए दिखाता है, उन पेजों को नहीं गिनता जो पहले ही स्वैप में जा चुके हैं, इसलिए उसमें यह नहीं दिखता।
हर स्टेज में एक मॉडल लोड करें
पाइपलाइन अपने मॉडल बारी-बारी से इस्तेमाल करती है: टेक्स्ट एनकोडर सिर्फ़ प्रॉम्प्ट एनकोड करने के लिए, transformer सिर्फ़ डीनॉइज़िंग लूप में, और VAE डिकोड में दोनों में से कोई नहीं। इसलिए दोनों बड़े मॉडलों का एक साथ मेमोरी में होना ज़रूरी नहीं। इसका हिसाब stageload रखता है: StagedModels किसी मॉडल को तब लोड करता है जब कोई स्टेज पहली बार उसे माँगती है, और तब रिलीज़ करता है जब पाइपलाइन ऐसी स्टेज में जाती है जिसकी सूची में वह नहीं है।
from stageload import StagedModels, on_call

STAGES = {"encode": ["text_encoder"], "denoise": ["transformer"], "decode": []}
models = StagedModels({"text_encoder": text_encoder, "transformer": transformer}, stages=STAGES)

on_call(pipe, "encode_prompt", before=lambda *a, **k: models.enter("encode"))
on_call(pipe, "prepare_latents", before=lambda *a, **k: models.enter("denoise"))
on_call(pipe, "_unpack_latents", before=lambda *a, **k: models.enter("decode"))
text_encoder और transformer ऐसे फ़ंक्शन हैं जो हर मॉडल को from_pretrained(..., subfolder=...) से लोड करके mps पर ले जाते हैं। पाइपलाइन खुद text_encoder=None, transformer=None और VAE के साथ बनती है, और VAE लोड ही रहता है। हर स्टेज पाइपलाइन के जिस मेथड से शुरू होती है, on_call उससे ठीक पहले models.enter(stage) चलाता है, इसलिए पाइपलाइन का कोड जैसा है वैसा रहता है। एक चीज़ और चाहिए: पाइपलाइन डीनॉइज़िंग शुरू होने से पहले transformer का config पढ़ती है, इसलिए pipe.text_encoder और pipe.transformer की जगह ऐसे स्टैंड-इन हैं जो .config का जवाब checkpoint से देते हैं और किसी भी और इस्तेमाल पर असली मॉडल लोड करते हैं। स्टैंड-इन और मेमोरी ट्रेस के साथ पूरी स्क्रिप्ट bench/qwen_image.py में है, और लाइब्रेरी pip install stageload से इंस्टॉल होती है।
दोनों staged रन पूरे हुए, 94 और 124 सेकंड में। footprint का शिखर एनकोडिंग में 19.0 GB, दोनों रन की डीनॉइज़िंग में 16.2 और 18.6 GB, और डिकोड में 14.4 GB रहा। किसी भी रन में स्वैप नहीं बढ़ा, और खाली मेमोरी कभी 51 % से नीचे नहीं गई। दोनों मॉडल लोड करने में हर रन में लगभग 13 सेकंड लगे, और डिकोड से पहले transformer को रिलीज़ करने में 4 से 5 सेकंड और। transformer के मेमोरी में आने से डिकोड शुरू होने तक गिनें, तो 20 स्टेप एक staged रन में 70 सेकंड, दूसरे में 99 सेकंड और eager में 77.5 सेकंड में हुए; ट्रेस से पता नहीं चलता कि दोनों staged रन अलग क्यों रहे। दोनों ने बिट-दर-बिट एक ही इमेज दी।
किसी रन को स्वैप के लिए जाँचें
footprint कुछ भी दिखाए, अगर रन के दौरान स्वैप नहीं बढ़ता तो रन मेमोरी में समा रहा है। दो कमांड यह दिखाती हैं:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
stageload का MemoryMeter हर 0.5 सेकंड पर footprint, स्वैप और खाली मेमोरी को JSONL ट्रेस में लिखता है, और stageload guard किसी कमांड को तब शुरू करता है जब उसके लिए जगह हो, और स्वैप बजट से ज़्यादा बढ़ते ही उसे रोक देता है:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.pyमैंने क्या नहीं मापा
- VAE टाइलिंग।
pipe.vae.enable_tiling()इमेज को टाइलों में डिकोड करता है, और eager और offload दोनों डिकोड में ही स्वैप में गए थे। मैंने इसे नहीं आज़माया, इसलिए नहीं कह सकता कि इससे eager इस Mac पर पूरा चलेगा या नहीं। - sequential CPU offload, क्वांटाइज़्ड वेट, और 48 GB से कम या ज़्यादा मेमोरी वाले Mac।
- क्या staged वही इमेज देता है जो eager देता। eager ने इस Mac पर कभी इमेज नहीं लिखी।
मापों का ब्योरा Qwen-Image-2.1 एक स्टेज के बाद एक और 48 GB वाले Mac पर model CPU offload में है, और ट्रेस stageload रिपॉज़िटरी में हैं।