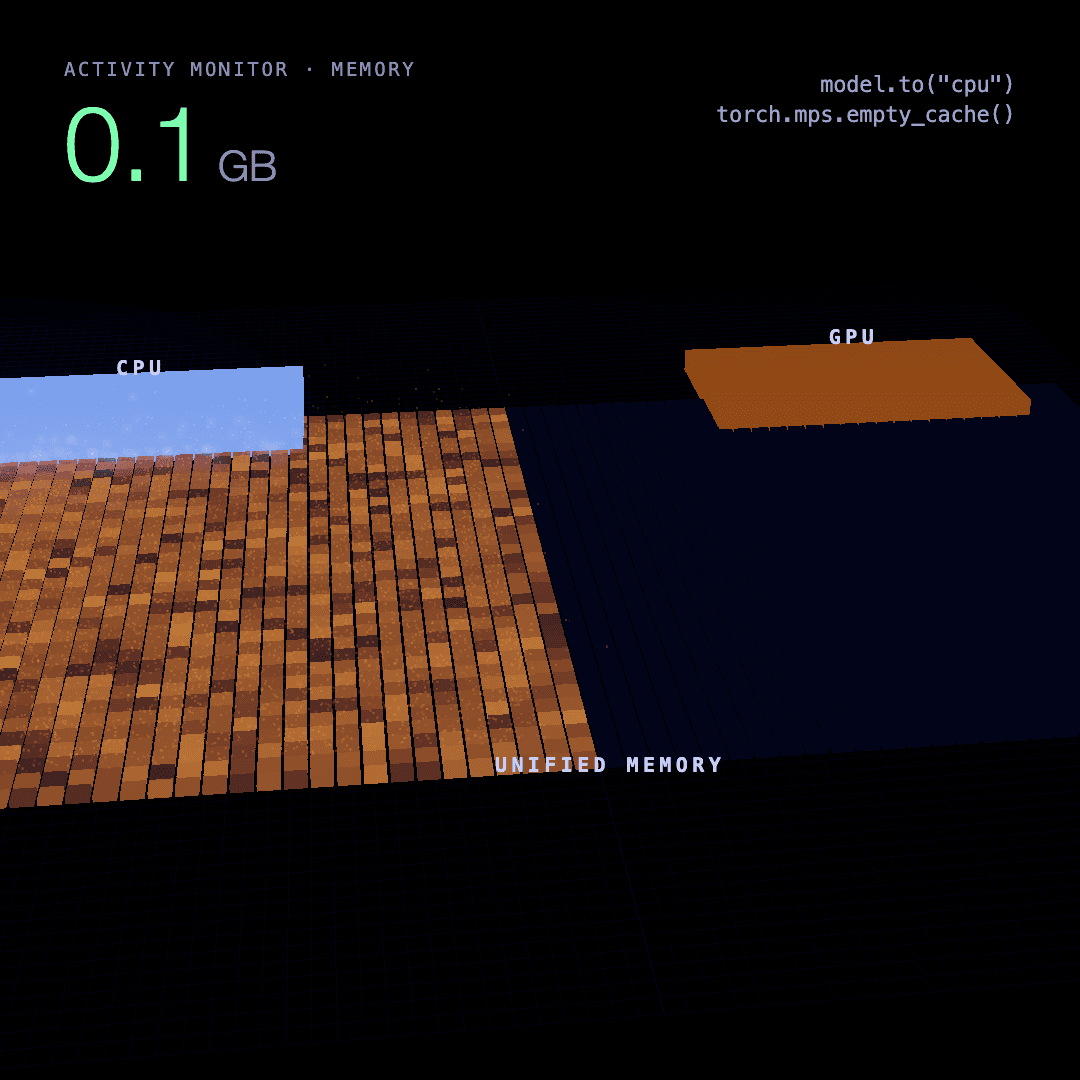
Mac では、mps から CPU に移したテンソルがメモリから消えたように見えます。プロセスの footprint、つまりアクティビティモニタの「メモリ」列の数字はほぼゼロになり、MPS ドライバの値も同じです。それでもコピーは残っていて、同じメモリを使っています。これは diffusers のオフロードについての議論 のために作った最小の例で、4 GiB のテンソルがモデルの重みの代わりです(torch 2.14.0、macOS 26.5.2、48 GB の M5 Pro)。
import ctypes, os, time
import torch

# rusage_info_v2 from <libproc.h>; phys_footprint is the Memory column of Activity Monitor
FIELDS = ("user_time", "system_time", "pkg_idle_wkups", "interrupt_wkups", "pageins",
          "wired_size", "resident_size", "phys_footprint")
class RUsageInfoV2(ctypes.Structure):
    _fields_ = [("uuid", ctypes.c_uint8 * 16)] + [(f, ctypes.c_uint64) for f in FIELDS] \
        + [(f"rest{i}", ctypes.c_uint64) for i in range(10)]

libproc = ctypes.CDLL("/usr/lib/libproc.dylib")

def show(step):
    torch.mps.synchronize()
    info = RUsageInfoV2()
    libproc.proc_pid_rusage(os.getpid(), 2, ctypes.byref(info))
    print(f"{step:<14} footprint {info.phys_footprint / 2**30:4.1f} GiB, "
          f"mps driver {torch.mps.driver_allocated_memory() / 2**30:4.1f} GiB")

show("start")
w = torch.randn(2**30, device="mps")      # 4 GiB of float32, standing in for a model's weights
show("on mps")
w = w.to("cpu")                           # what model CPU offload does when a model's turn ends
torch.mps.empty_cache(); time.sleep(2)
show("moved to cpu")
float(w.sum())                            # read every page of the cpu copy
show("cpu copy read")
start footprint 0.1 GiB, mps driver 0.0 GiB
on mps footprint 4.2 GiB, mps driver 4.0 GiB
moved to cpu footprint 0.1 GiB, mps driver 0.0 GiB
cpu copy read footprint 4.2 GiB, mps driver 0.0 GiB三回実行して、毎回同じ出力でした。
数字が言っていること
移した直後、どちらのカウンタもほぼゼロに戻りますが、w には 4 GiB の値がすべて入っています。CPU がコピーの全ページを読むと、footprint はまた 4.2 GiB になります。つまり .to("cpu") から次に CPU がその重みに触れるまでの間に測った footprint には、その重みが写りません。
そもそも移しても何も空かないのは、ハードウェアのせいです。Apple Silicon では CPU と GPU が物理メモリのひとつのプールを使います。PC なら重みを GPU から CPU に移せば、次のモデルのために VRAM が空きます。Mac では「CPU 上」の重みも、GPU が必要とする同じ RAM にあります。
model CPU offload にとってなぜ大事か
diffusers の enable_model_cpu_offload() は各モデルを CPU に置き、動くときだけ GPU に移します。同じ Mac で Qwen-Image-2.1 を 1024 × 1024 でこの方法で動かしました(トレースと解説)。プロセスの footprint は一度も 18.5 GB を超えず、48 GB の Mac なら余裕で収まるはずの値です。スワップはデノイズ中に 3.5 GB、VAE デコードまでに 9.6 GB 増え、メモリの見張りが画像を書き出す前に実行を止めました。
footprint だけのグラフなら、この実行は収まったと判断されたでしょう。上の例は、重みがメモリに残っているのに footprint が低いままになる仕組みのひとつを示しています。offload の実行でどのページがスワップに出たかは測っていません。
自分の実行の確かめ方
footprint だけでなく、スワップを見てください。
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
ジョブの実行中にスワップが増えるなら、footprint が何と言おうと収まっていません。このために書いた小さなライブラリ stageload(pip install stageload)は MemoryMeter で両方を 0.5 秒ごとにトレースに記録し、stageload guard はスワップが予算を超えて増えた時点でコマンドを止めます。
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py本当にメモリを空けるもの
モデルを順番に動かすパイプラインなら、モデルを CPU に置いておく代わりに、そのステージが始まるときに読み込み、終わったら解放するのが解決策です。stageload の release(module) はすべてのパラメータとバッファを PyTorch の meta デバイスに移し、ガベージコレクションをして MPS のキャッシュを空にします。meta 上のテンソルには記憶領域がないので、ほかのコードがモジュールへの参照を持っていてもメモリが戻ります。テキストエンコーダ(16.3 GB)とトランスフォーマ(13.3 GB)をこの方法で一つずつ読み込むと、同じ Mac で Qwen-Image-2.1 のピークは 19.0 GB で、二回の実行のどちらでもスワップは増えませんでした。設定の全体は Qwen-Image-2.1 を 48 GB の Mac でスワップなしに動かす方法 にあります。
測っていないこと
- 例の実行中のシステム全体の空きメモリ。この Mac ではほかのジョブが実行ごとに数 GiB 動かすので、きれいな数字は取れませんでした。
delとtorch.mps.empty_cache()でmetaへの移動と同じくらい完全にメモリが戻るか、どれくらい速いか。- ほかの macOS と torch のバージョン、メモリの多い Mac。