Mac で PyTorch のジョブがメモリ不足になると、エラーの最後にこんな助言が付いています。
RuntimeError: MPS backend out of memory (MPS allocated: 18.50 GiB, other allocations: 448.00 KiB, max allowed: 18.72 GiB). Tried to allocate 512.00 MiB on shared pool. Use PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.0 to disable upper limit for memory allocations (may cause system failure).この助言に従うと何が起きるのか知りたくて、48 GB の M5 Pro(macOS 26.5.2、PyTorch 2.14.0)で MPS のメモリを 512 MiB ずつ埋めていきました。設定ごとに一回ずつ、スワップが 2 GB 増えたらプロセスを止める見張りの下で走らせています。分かったことは二つです。この Mac では既定の上限が RAM より大きいので、メモリに収まらなくなったジョブはスワップに滑り込み、このエラーには一度もたどり着きません。そして上限を下げるには、変数が一つではなく二つ要ります。
「max allowed」はどこから来るか
max allowed が上限で、PYTORCH_MPS_HIGH_WATERMARK_RATIO に torch.mps.recommended_max_memory() の返り値を掛けたものです。私の Mac ではこれが 37.44 GiB で、0.5 × 37.44 = 18.72 GiB が上のエラーの数字です。ログでは MPS allocated が torch.mps.current_allocated_memory()、つまりテンソルが占めるメモリと一致していました。自分の基準値は次のように確かめられます。
import torch
print(torch.mps.recommended_max_memory() / 2**30, "GiB")
48 GB の Mac が先にスワップに入る理由
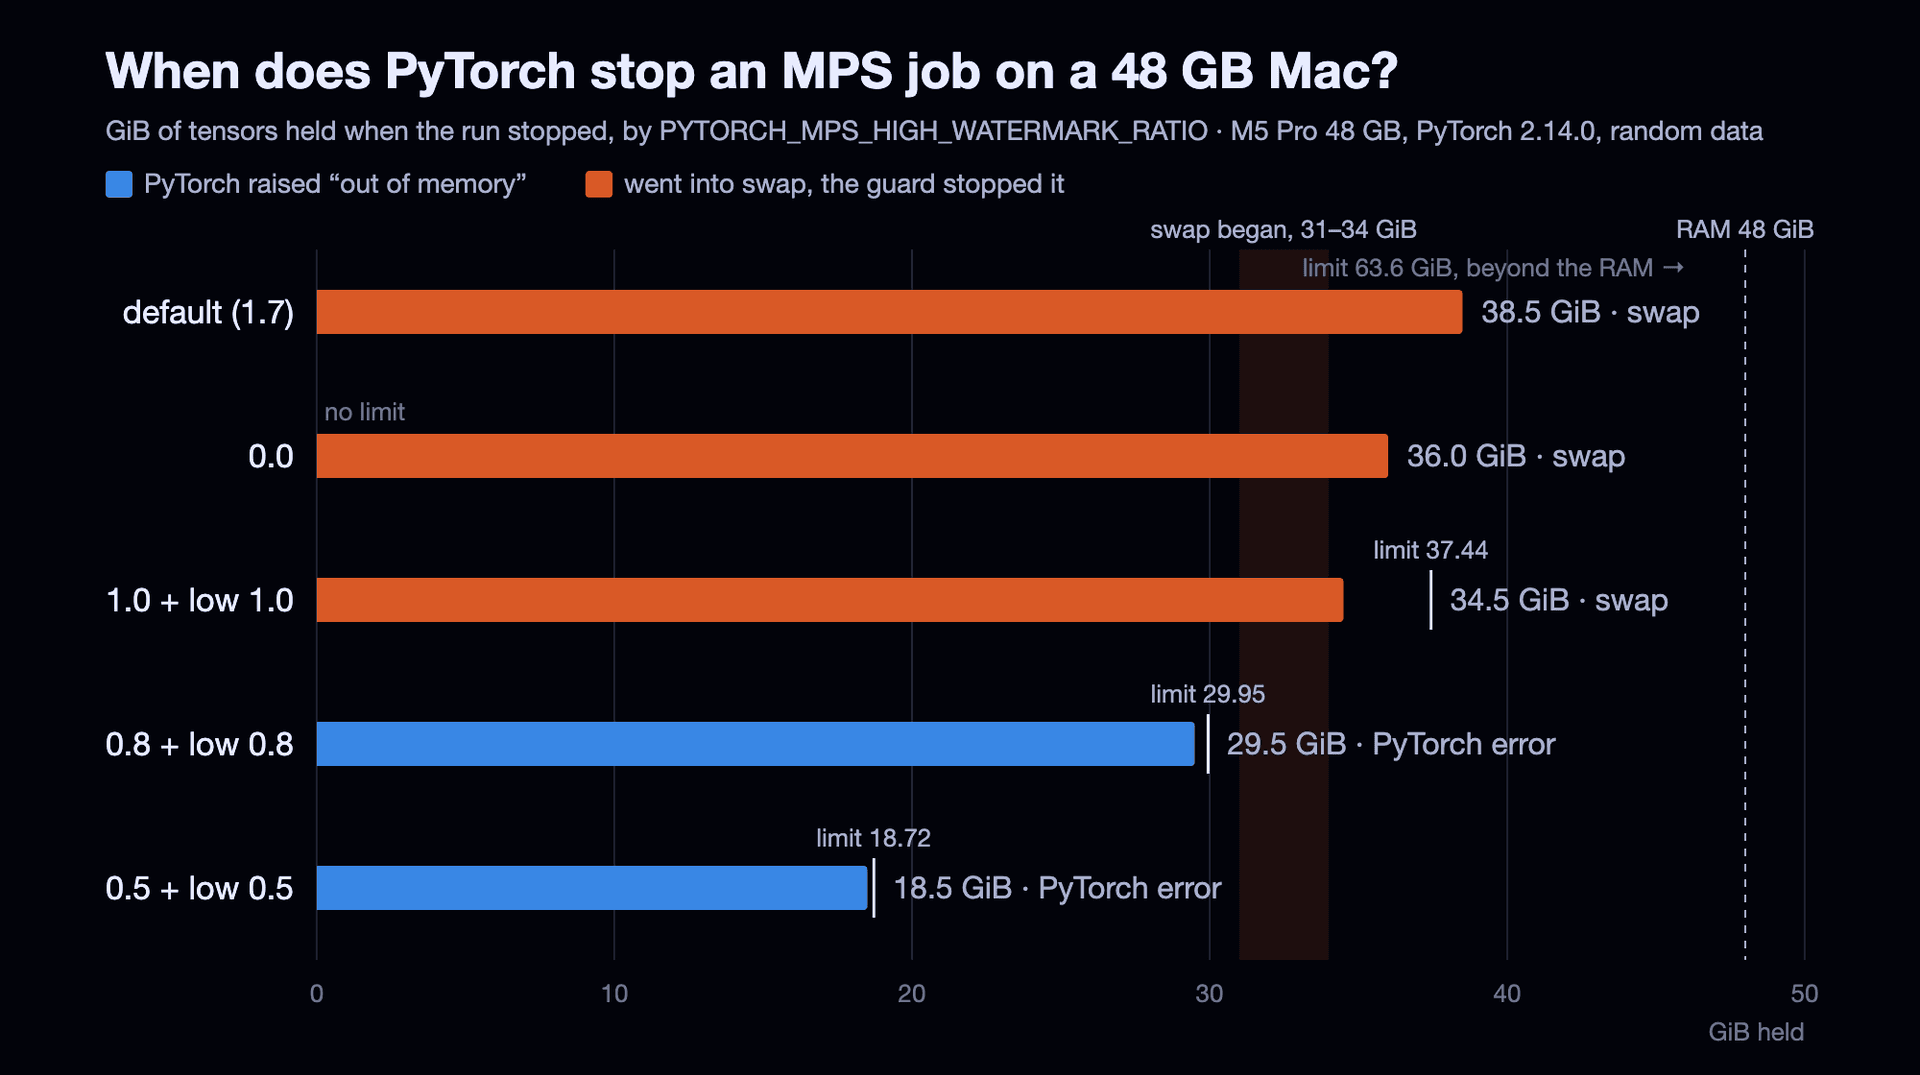
PyTorch のドキュメントでは、high の比率の既定値は 1.7 です。私の Mac ではこれで上限がおよそ 63.6 GiB になり、マシンのメモリより大きくなります。設定ごとの結果は次のとおりです。
| 設定 | 埋めるのを止めたもの | 保持したテンソル | 実行中のスワップ |
|---|---|---|---|
| 既定値(1.7) | 見張り | 38.5 GiB | 6.1 → 12.0 GB |
| 0.0 | 見張り | 36.0 GiB | 5.1 → 9.8 GB |
| 1.0、low 1.0 | 見張り | 34.5 GiB | 4.6 → 8.7 GB |
| 0.8、low 0.8 | PyTorch、max allowed 29.95 GiB | 29.5 GiB | 変化なし |
| 0.5、low 0.5 | PyTorch、max allowed 18.72 GiB | 18.5 GiB | 変化なし |
既定値、0.0、1.0 では、プロセスが 33.5〜36.2 GB を超えたところでスワップが増え始め、PyTorch は一度もエラーを出しませんでした。上限が RAM の終わりより遠くにあったからです。つまりエラー自身の助言である 0.0 は、ここでは目に見える違いを何も生みませんでした。上限は最初から届かないところにあり、PyTorch の中に実行を止めるものはありませんでした。
設定するには:変数は二つ
high の比率だけを設定すると、最初の MPS 呼び出しで失敗します。
$ PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 python fill.py
RuntimeError: invalid low watermark ratio 1.4
Apple Silicon では low の比率の既定値は 1.4 で、high より大きくはできません(high が 0.0 で上限が無効の場合を除きます)。両方を設定します。
PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 PYTORCH_MPS_LOW_WATERMARK_RATIO=0.8 python run.pyPython から設定するなら、最初のテンソルを mps に置く前に行います。PyTorch はこれらを import torch の時点ではなく MPS が起動するときに読み、その後の変更は無視します。
import os
os.environ["PYTORCH_MPS_HIGH_WATERMARK_RATIO"] = "0.8"
os.environ["PYTORCH_MPS_LOW_WATERMARK_RATIO"] = "0.8"
import torch
ドキュメントは low の比率をソフトな上限と呼び、「setting 0.0 disables adaptive commit and garbage collection」と書いています。私は high と同じ値にして、low だけの効果は測っていません。
値の選び方
上限は、普段のアプリを開いたままで Mac に実際に空いているメモリより下に収めるべきです。私の Mac では 1.0(37.44 GiB)ですでに多すぎ、0.8(29.95 GiB)ではスワップなしできれいなエラーになりました。きれいなエラーならバッチサイズや解像度を下げてやり直せますが、スワップに滑り込む実行はまず Mac 全体を遅くします。
試すときの落とし穴
最初の実行ではテンソルを torch.ones で埋めていました。既定値のまま、私が決めた 46 GiB の上限まで、エラーもスワップもなしに届きました。macOS は同じ値が並ぶページをほぼゼロまで圧縮するからです。モデルの重みはそうは圧縮されないので、Mac でメモリを試すならランダムなデータが必要です。
モデルが本当に収まらないとき
きれいなエラーが教えてくれるのは、モデルが収まらないということだけです。複数のモデルからなるパイプラインでは、いまのステージのモデルだけを読み込むほうがどの比率よりも効きます。それが stageload を書いた理由です。埋めるスクリプトと上のすべての実行のトレースは、そのリポジトリの bench/results/2026-10-13-mps-watermark にあります。