stageload の二つ目のノートでは、48 GB の Mac で Qwen-Image-2.1 を二通りに動かした。eager は VAE のデコードでメモリガードに止められ、staged は最後まで終わった。diffusers には三つ目の方法が組み込まれている。enable_model_cpu_offload は各モデルを CPU に置き、動いている間だけ GPU に移す。10月8日に、10月6日の実行と同じプロンプト、サイズ、ステップ数、シード、ガードの閾値でこれを一度走らせた。
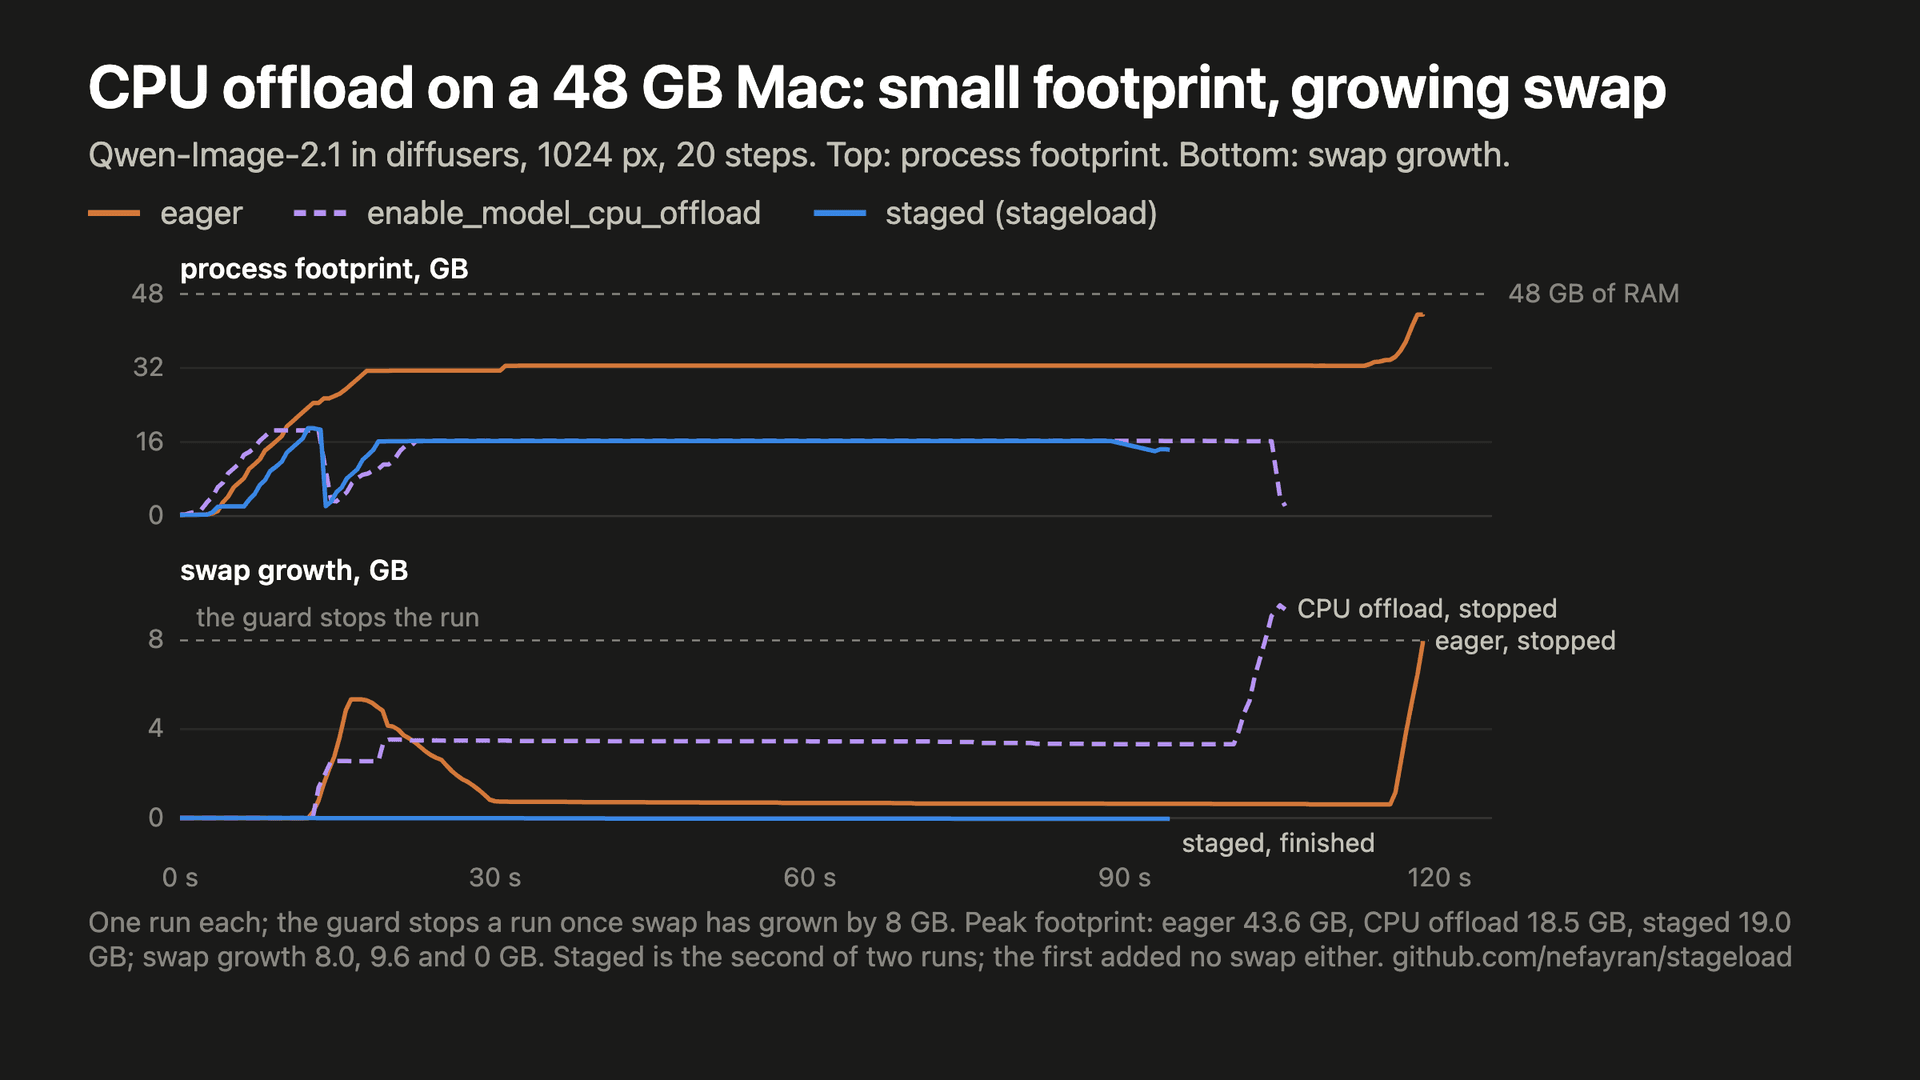
プロセスの footprint で見ると、offload は staged と同じように見えた。ピークは 18.5 GB で、staged は 19.0 GB だった。違いはスワップに出る。エンコードは 8 秒かかり、スワップは増えなかった。87 秒のデノイズの間にスワップは 3.5 GB 増え、空きメモリは 27 % まで下がった。VAE のデコードでスワップの増加は 9.6 GB、空きメモリは 22 % になり、開始から 105 秒でガードが実行を止めた。画像は書き出されなかった。staged は二回の実行のどちらでもスワップを増やさず、94 秒と 124 秒で終わった。
footprint にはこれが映らない。すでにスワップに出たページを数えないからだ。Mac では CPU と GPU が一つのメモリを共有するので、「CPU に置いた」モデルも、動いているモデルと同じ RAM を占める。footprint だけで比べれば offload は staged の隣に並ぶ。スワップで比べると eager の隣に並ぶ。eager も同じところで、新たに 8 GB のスワップを使った後にガードに止められた。
示せなかったこと
これは一回の実行だ。二回目を走らせても、ガードがすでに出した結果のためにまたマシンをスワップに追い込むだけだった。どのページがスワップに出たかは測っていないし、メモリの多い Mac で offload を試してもいない。
スクリプトは bench/qwen_image_offload.py、トレースはリポジトリにある。stageload は pip install stageload で入る。