stageload の最初のノートで測ったのは Pixal3D という一つのパイプラインだけだった。text-to-image のパイプラインも同じ形をしている。テキストエンコーダ、デノイザ、画像デコーダが順に動く。そこで10月6日に、diffusers の Qwen-Image-2.1 を同じ 48 GB の Mac で測った。テキストエンコーダは 16.3 GB、トランスフォーマーは 13.3 GB、VAE は 1.3 GB を占める。各実行では 1024 × 1024 の画像を一枚、20 ステップで生成し、それぞれをメモリガードの下で別々のプロセスとして走らせた。
eager は通常の from_pretrained(...).to("mps") だ。staged では、パイプラインの大きな二つのモデルを代役に置き換えた。代役は .config にはチェックポイントから答えるので、パイプラインはデノイズが始まる前に設定を読める。それ以外の使われ方をすると、代役は本物のモデルを読み込む。三つのフックが encode_prompt、prepare_latents、_unpack_latents でステージの始まりを示す。パイプラインのコードは変えていない。
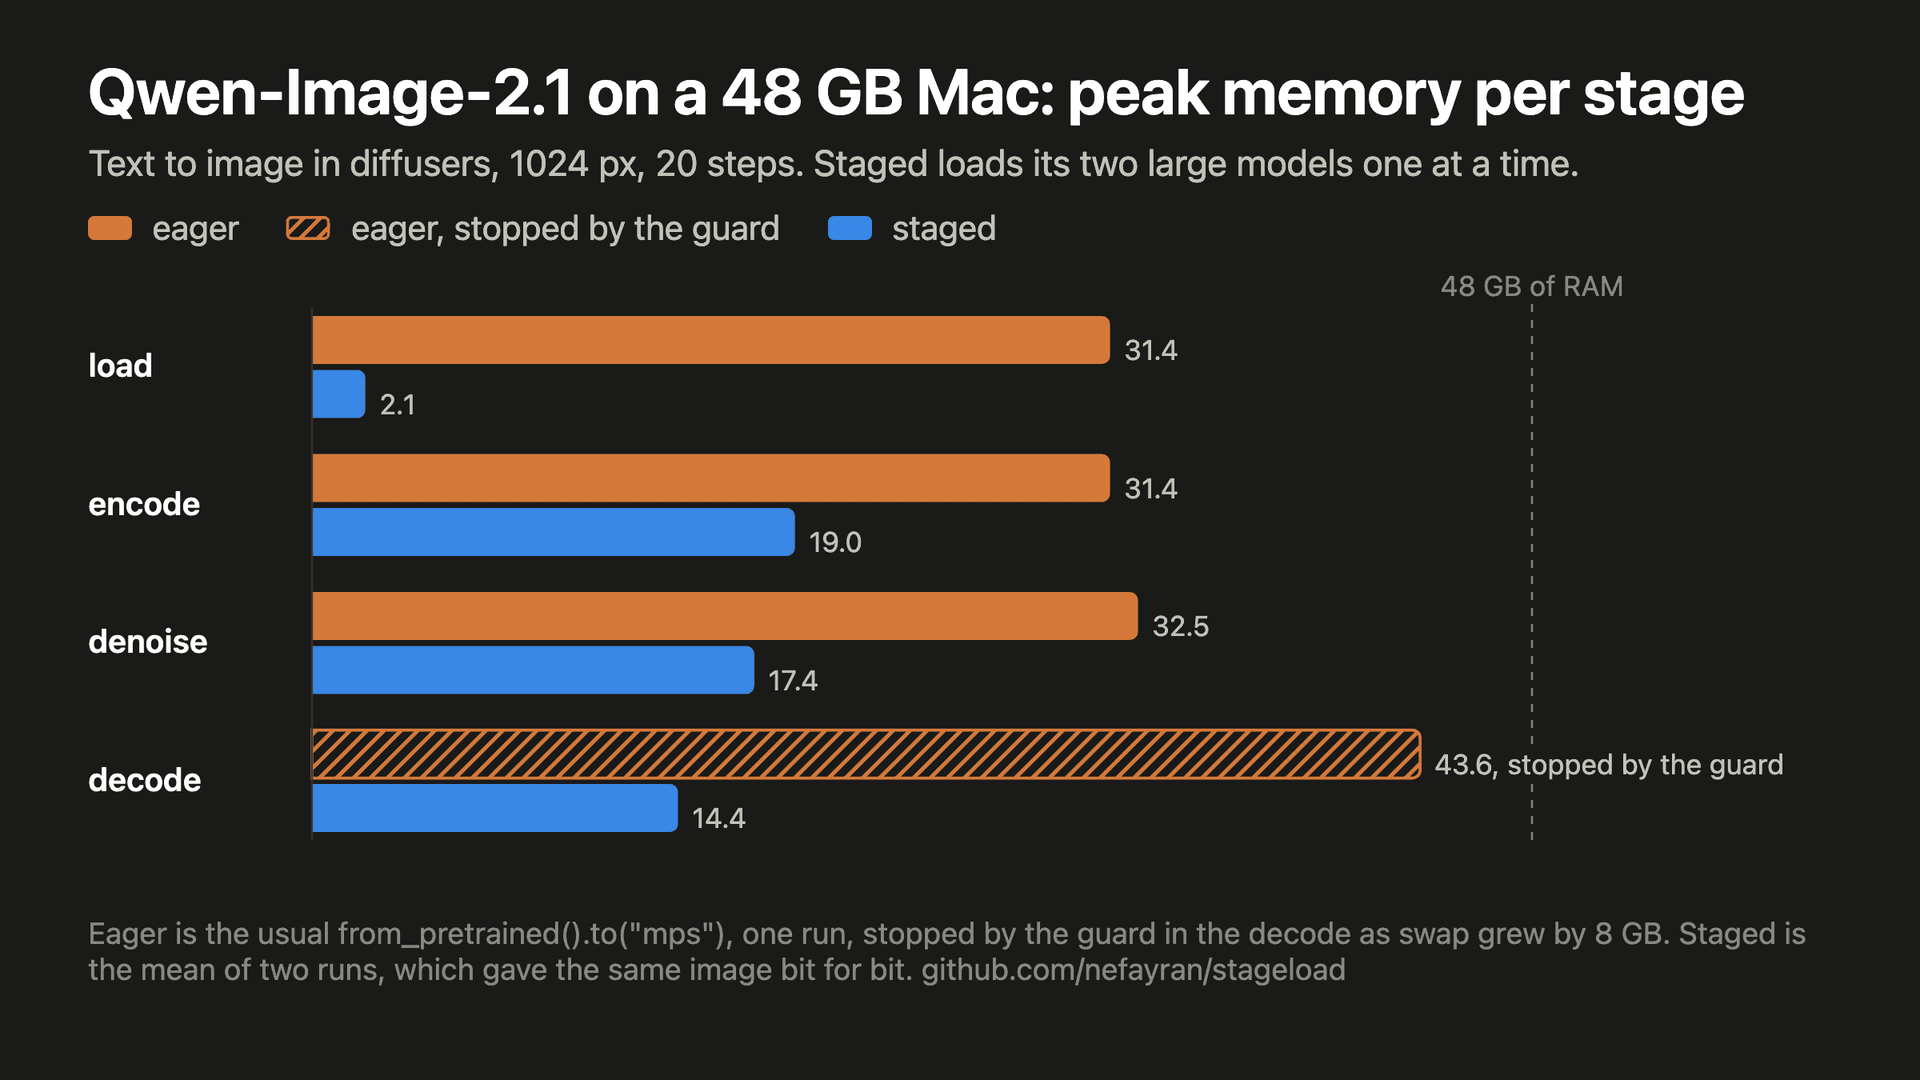
エンコードとデノイズの間、eager は 31〜33 GB にとどまった。VAE のデコードには重みに加えて約 11 GB が必要で、それで 43.6 GB に達した。スワップが 8 GB 増え、画像を書き出す前にガードが止めた。staged はデコードの前にトランスフォーマーを解放した。ピークはエンコード中に 19.0 GB、デコードで 14.4 GB で、二回の実行のどちらでもスワップは増えなかった。
staged が二つのモデルの読み込みに使ったのは 13 秒だった。デノイズは一回目の実行で 109 秒、二回目で 79 秒、eager では 77.5 秒かかった。一回目が遅かった理由はトレースからは分からない。
示せなかったこと
staged の二回の実行は、ビット単位で同じ画像を出した。eager はこの Mac では画像を出せなかったので、これらの実行からは、staged の読み込みが eager と同じ画像を出すことは示せない。それより前の eager の実行は読み込みすら終えられなかった。動画のジョブが終わった一分後に始まり、スワップが 10 GB 増えるまで 18 秒しかかからなかった。
コードは bench/qwen_image.py に、トレースと集計はリポジトリにある。