10月4日、私の Mac で走らせていた Pixal3D がテクスチャステージに入り、十秒以内にプロセスが 27 から 44 GB に増えた。利用可能なメモリは 6% まで下がり、スワップは 12 GB 増えたので、重いジョブを走らせるときに使っているガードがそれを止めた。この Mac のメモリは 48 GB だ。このガードがなかった頃には、Pixal3D の実行が二回、Mac の再起動で終わっている。そのうち一回は、ほかの重い作業と並行して動かしていた。
Pixal3D は一枚の画像をテクスチャ付きの 3D メッシュに変えるもので、Pixal3D-mac はその Apple Silicon への移植版だ。1024_cascade パイプラインは七つのモデルを順に動かす。粗い構造のためのフローモデルとデコーダ、512 と 1024 の形状のための二つのフローモデル、形状デコーダ、そしてテクスチャのためのフローモデルとデコーダだ。その周りでは、四つの画像特徴抽出器、背景除去器、カメラ推定器が働く。各ステージに必要なのは七つのモデルのうち一つか二つで、移植版はそのすべてを最初の一秒から最後の一秒までメモリに置いておく。
メモリが戻ってこない理由
Apple Silicon では、CPU と GPU が一つのメモリプールを共有している。Pixal3D の低 VRAM モードはデフォルトで有効になっていて、待機中のモデルを CPU に置き、使用中のモデルを GPU にコピーする。独立したグラフィックスカードを積んだ PC なら、これでビデオメモリを節約できる。Mac では CPU 側のコピーと GPU 側のコピーが同じ RAM に載るので、このモードはすべてのモデルを常駐させたうえで、使用中のモデルの二つ目のコピーを加えることになる。四つの特徴抽出器はまた、同じ DINOv3 のバックボーンを四回読み込む。
ステージごとに読み込む
stageload は、このために書いた小さなライブラリだ。パイプラインが持つモデルの辞書を、ステージがモデルを初めて求めたときにそれを読み込み、次のステージが挙げていないモデルをすべて解放する辞書に差し替える。解放では、モジュールの各テンソルを PyTorch の meta デバイスに移す。こうすると、ほかのコードがまだモジュールへの参照を持っていてもストレージが解放され、あとからモジュールを呼び出すと、PyTorch の内部のどこかで失敗するのではなく、そのモジュールと、それを解放したステージの名前を挙げたエラーが出る。
移植版自身の run() は変更なしで実行される。stageload は、各ステージがどこで始まるかを知るために、パイプラインのメソッドを四つラップする。背景除去、最初の画像条件付け、形状とテクスチャの各パスの条件付け、そして最後のデコードだ。四つの特徴抽出器は、一つのバックボーンを共有するように構築される。
この仕組みには、うまくいかなくてもエラーを出さない部分が一つある。Pixal3D は実行の最初に一度だけシードを設定し、その後はすべてのステージのノイズを CPU の乱数生成器から引く。モデルを構築するとランダム初期化が走り、これも同じ生成器から引く。そのため、実行の途中で遅延構築されたモデルは、それ以降のすべてのステージのノイズを変え、それとともにメッシュも変えてしまう。stageload は読み込みのたびに、その前に生成器の状態を保存し、終わったあとで復元する。対象は torch の CPU、MPS、CUDA の生成器、Python の random、そして NumPy のグローバルな生成器だ。移植版と同じやり方でシードを設定してノイズを引く模擬パイプラインで、テストは staged と eager の実行がビット単位で同じ潜在変数を出すことを確かめ、復元を切った対照は両者がずれていくのを捉える。
Pixal3D だけのものではない
stageload のコアは Pixal3D について何も知らない。パイプラインに求めるものは三つだけだ。各モデルを単独で組み立てる関数、各ステージが使うモデルの一覧、そして各ステージが始まる場所での呼び出しである。自分のコードなら、その呼び出しは models.enter("decode") の一行で済む。この移植版のように他人のコードなら、on_call がその場所ですでに実行されているメソッドに呼び出しを取り付けるので、パイプライン自体はそのままでよい。text-to-image のパイプラインも Pixal3D と同じ形をしている。テキストエンコーダ、デノイザ、画像デコーダが順に動く。メモリメーターとガードは Mac 上のどんなプログラムにも使える。これまでに測定したのは Pixal3D だけだ。README では二つのモデルからなる小さなパイプラインでコアを示しており、その例はテストとして実行される。
何が変わったか
この 48 GB の M5 Pro で、移植版のサンプル画像を、シード 7、2048 ピクセルのテクスチャで 1024_cascade に通した。モードごとに二回ずつ、それぞれをガードの下で別々のプロセスとして走らせた。「eager」は移植版自身の読み込み方で、「staged」は stageload だ。このマシンでは eager の実行がガードの制限内でテクスチャステージを通り抜けられないので、二回の eager の実行はテクスチャステージが始まるところで止まる。eager のテクスチャの数値は、10月4日にテクスチャステージに入った実行から取っている。
| ステージ | eager、ピークフットプリント | staged、ピークフットプリント |
|---|---|---|
| setup | 20.4 GB | 2.9 GB |
| camera | 23.2 GB | 6.7 GB |
| structure | 22.2 GB | 10.9 GB |
| shape_512 | 26.6 GB | 11.4〜11.5 GB |
| shape_1024 | 30.5 GB | 13.1 GB |
| texture | 44.2 GB でガードが停止 | 30.1 GB |
| decode | 未到達 | 17.9〜18.4 GB |
| export | 未到達 | 69.6〜70.2 GB |
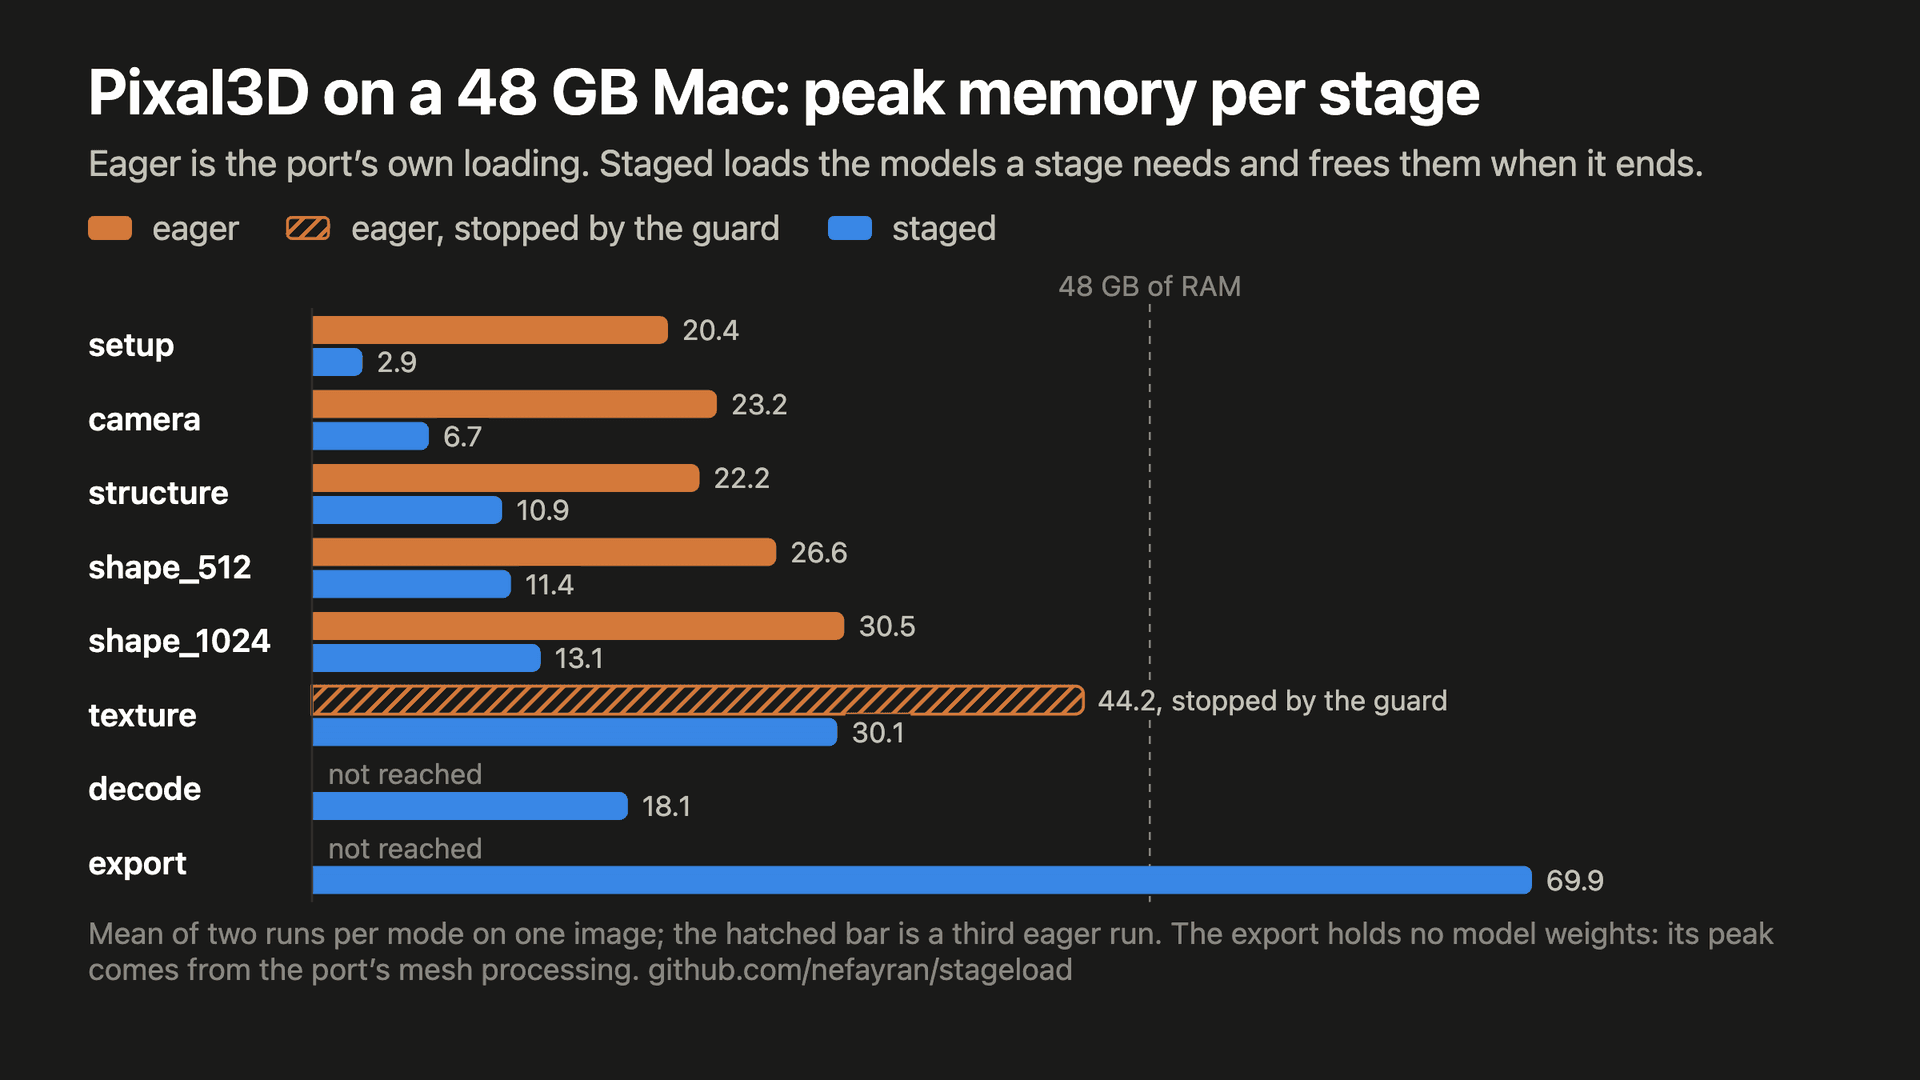
両方のモードが走ったすべてのステージで、staged のほうが 11.3〜17.5 GB 少なく済んだ。八回の読み込み、つまり七つのモデルと、デコードのためにもう一度読み込む形状デコーダは、一回あたり約十分間の実行のうち 24 秒で 13.2 GB を読んだ。
テクスチャステージの 30 GB の大半は作業用メモリで、テクスチャモデル自体は 2.6 GB だ。デコードが始まると、stageload はそれを特徴抽出器と一緒に解放して MPS アロケータのキャッシュを空にし、二秒以内にフットプリントは一方の実行で 4.5 GB、もう一方で 8.0 GB まで下がった。
staged で最も高い数値であるおよそ 70 GB は、すべてのモデルの重みが解放されたあとのエクスポートで出る。これは移植版のメッシュ処理(リメッシュ、UV 展開、ベイク)によるもので、stageload はそこには触れない。フットプリントはアクティビティモニタが表示する数値で、macOS が圧縮したメモリも数えるので、48 GB の RAM より大きくなりうる。
示せなかったこと
一つ目は、staged の読み込みが結果を変えるかどうかだ。どの実行も、各サンプラーの出力のハッシュとコピーを保存した。最初の潜在変数、つまり粗い構造は、四回の実行すべてでビット単位で同じだ。512 の形状ステージ以降は、同じシードでも移植版の結果は MPS 上で再現しない。二回の eager の実行は形状の潜在変数で最大 1.77 異なり、staged の実行と eager の実行の差は 1.24〜1.86 だ。つまりこの比較から言えるのは、staged の読み込みによる変化があったとしても移植版自身のばらつきより大きくはない、ということで、そのばらつきは eager の実行のこの一組だけで測ったものだ。テクスチャの潜在変数と最終的なメッシュはまったく比較していない。ここでは eager の実行がそこまで到達しないからだ。
CPU 上で構築しても効果はなかった。stageload は各モデルを GPU 上で直接構築し、そのせいでチェックポイントに含まれないテンソルが一つ変わる。モデルの構築時に計算されるスパースアテンションの回転周波数が、最大 6e-8 ずれるのだ。それで差が説明できるかを確かめるため、移植版と同じように、すべてのモデルを CPU 上で構築してから GPU に移す staged の実行を走らせた。その潜在変数と eager の実行との差は 1.84 と 1.12 で、ほかのどの組とも同じオーダーだった。読み込みには 24 秒ではなく 82 秒かかり、三つのステージではピークが 2.6〜3.8 GB 高くなった一方、二つのステージでは低くなった。GPU 上での構築に戻した。
自前の集計には、数値を一つ膨らませるバグがあった。各ステージのピークを、そのステージの開始が記録された瞬間から取っていたが、前のステージのモデルの解放には最大 1.7 秒かかる。その隙間に入ったメモリのサンプル一つが、CPU で構築した実行のデコードのピークを 29.5 GB にしていた。解放が終わった時点から数えると 16.7 だ。これはコードレビューで見つかった。今では、ステージのウィンドウは、その開始が引き起こした解放が終わった時点から始まる。
ガード
この Mac ではほかの重いジョブも動くので、実行は stageload の二つ目の部分である stageload guard を通した。これは、利用可能なメモリが十分にあり、重いジョブのリストに一致するプロセスがしばらく見当たらないときにだけ、コマンドを一つ起動する。コマンドの実行中は、スワップが予算を超えて増えるか、利用可能なメモリが 10% 未満のままになると、そのコマンドのプロセスグループ全体を止める。root は要らず、止めるのは自分で起動したプロセスだけだ。
静かになるのを待つ仕組みは、ある失敗から生まれた。連続する動画のジョブの間には短い隙間があり、その隙間の一つで実行が始まり、次の動画のジョブが 20 秒以内にスワップを予算以上に押し上げた。ベンチマークでは、どの実行も、重いジョブが見当たらない状態が三分続いてから始めた。
別の画像で
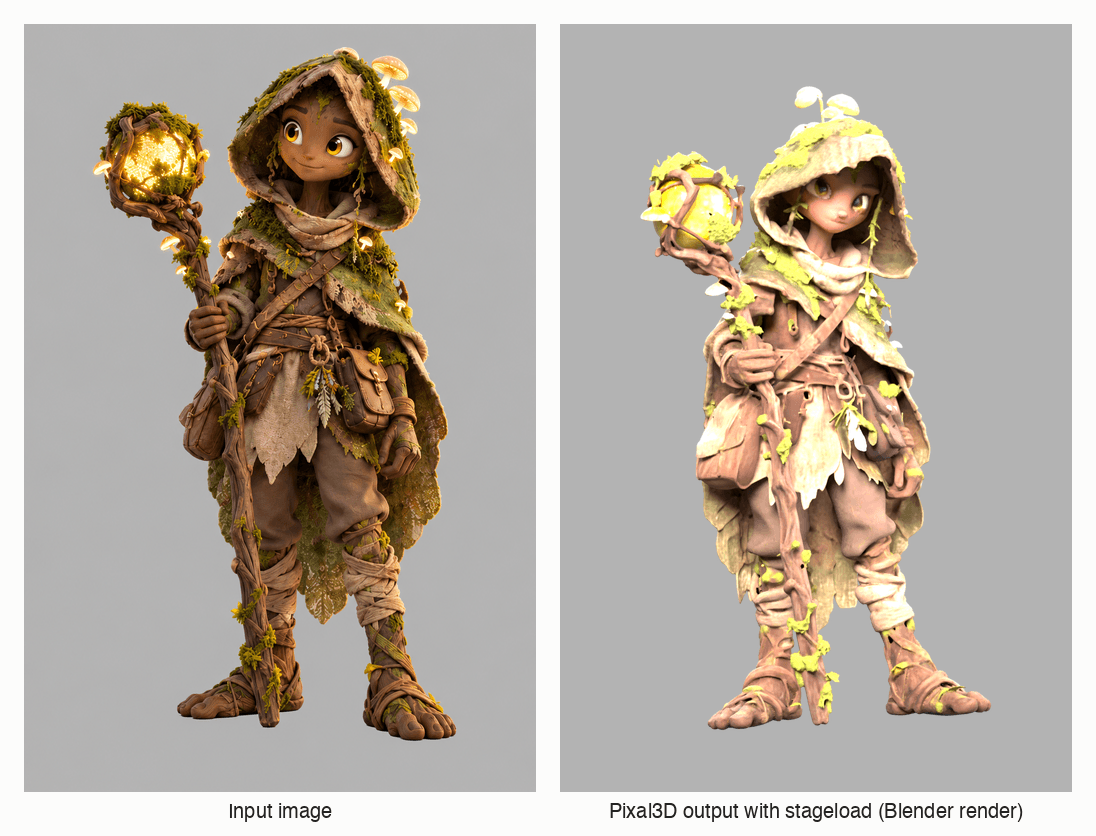
私が作っているゲームのキャラクターで同じ staged の実行を行うと、416 秒かかり、同じ 13.2 GB を 37 秒で読み込んだ。テクスチャステージのピークは、サンプル画像のときと同じく 30.1 GB だった。入力と、そこから作られたメッシュを Blender でレンダリングしたものを示す。
コード、すべての実行のトレース、そしてこれらのグラフを描いたスクリプトはリポジトリにある。Pixal3D 用のアダプタは、Pixal3D-mac の一つのコミットに対してテストしている。