Qwen-Image-2.1 は diffusers の QwenImage21Pipeline で動く。bfloat16 ではテキストエンコーダーが 16.3 GB、transformer が 13.3 GB、VAE が 1.3 GB を占め、48 GB の Mac で読み込んだパイプラインは 31.4 GB になった。1024 × 1024 の画像をデコードすると、さらに 11 GB 増えた。このガイドでは、その Mac で普通の書き方がどうなったか、model CPU offload がなぜ役に立たなかったか、そして最後まで終わった方法、つまり二つの大きなモデルのうち一つだけをメモリに置く方法を示す。
実行環境は 48 GB の Apple M5 Pro、torch 2.14.0、main から入れた diffusers 0.41.0.dev0。QwenImage21Pipeline は diffusers 0.41.0 のリリースにも入っているが、そちらでは走らせていない。どの実行も 1024 × 1024 の画像を 20 ステップ、シード 7 で一枚作り、スワップが 8 GB 増えた時点で実行を止めるメモリガードの下で動かした。
eager はデコードでスワップに入る
普通のコードは三つのモデルをすべて GPU に読み込み、そのまま置いておく。
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("mps")
image = pipe(prompt=prompt, width=1024, height=1024, num_inference_steps=20).images[0]
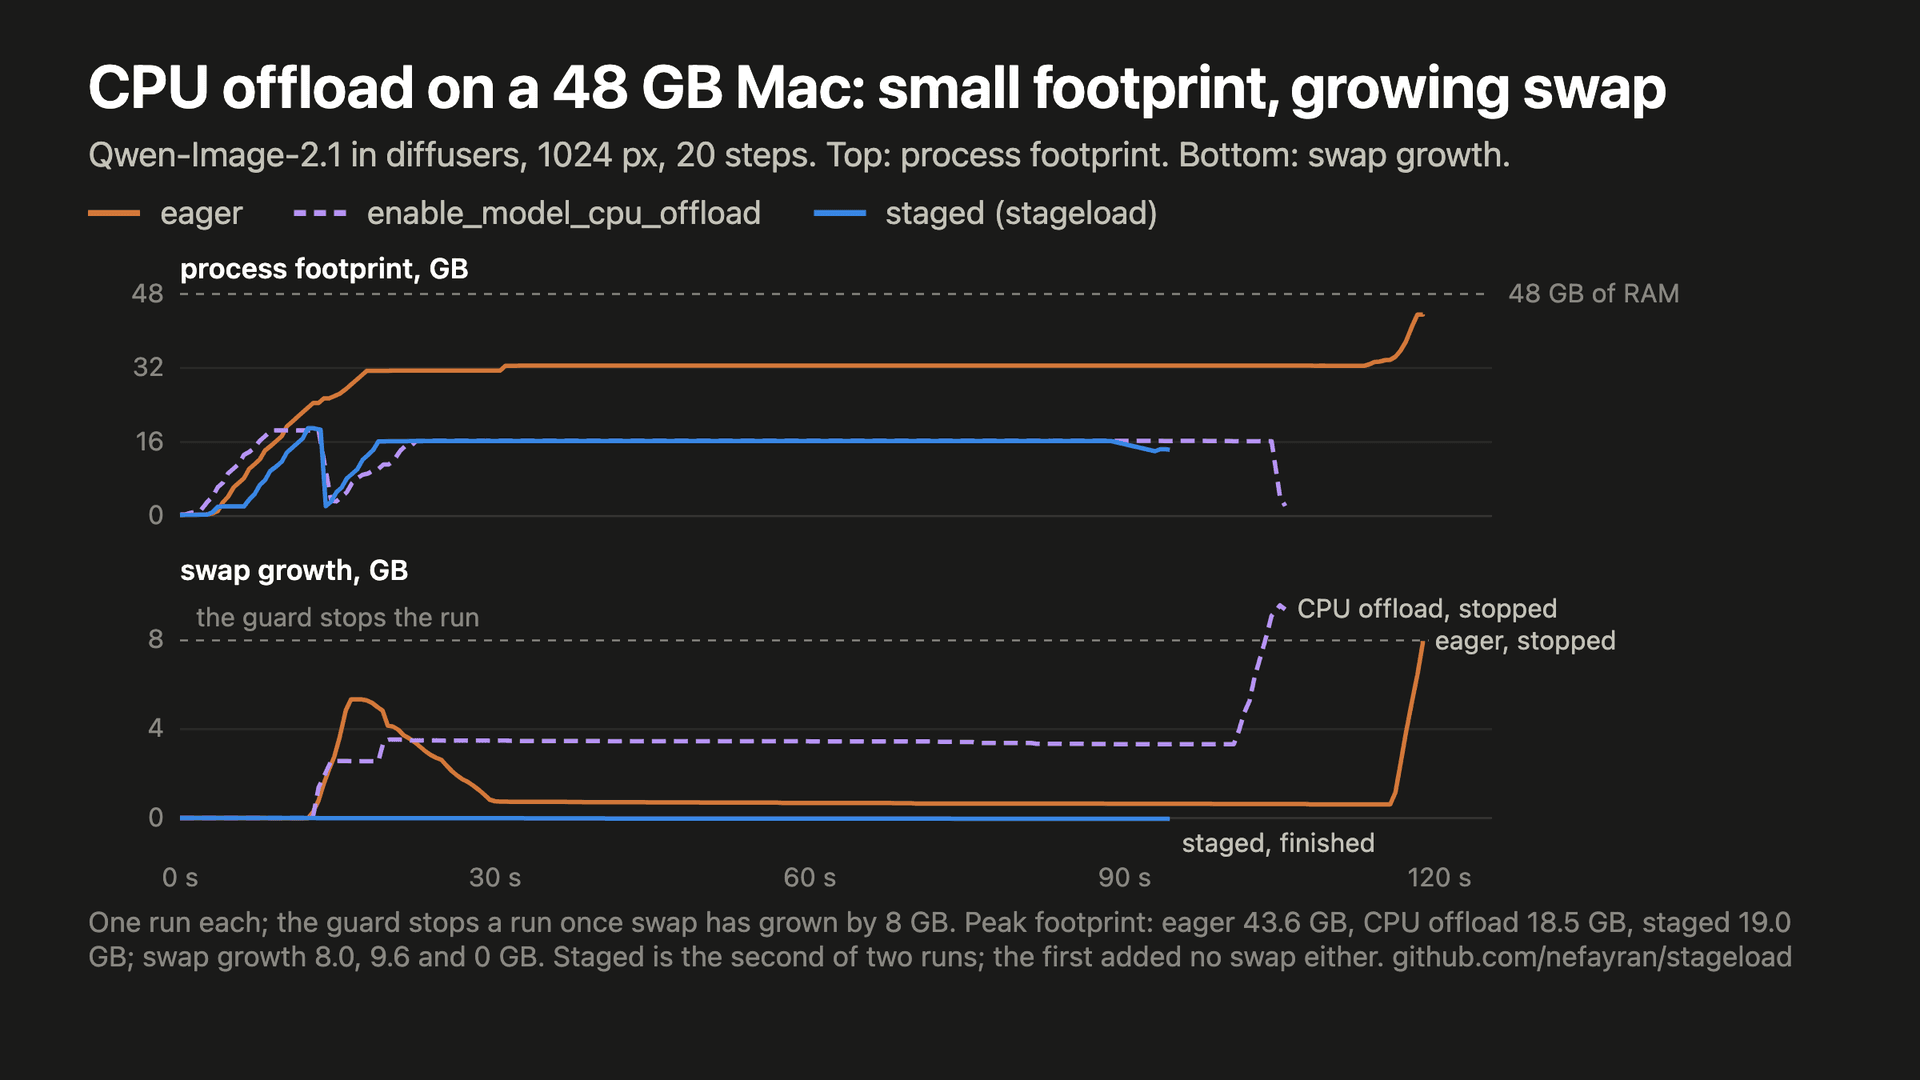
エンコードと 20 ステップのデノイズは 31〜33 GB で通った。そのあと VAE のデコードで footprint が 32.5 GB から 43.6 GB に上がり、スワップが 8 GB 増えたので、ガードは画像が書き出される前に実行を止めた。それまで PyTorch はメモリ不足のエラーを出さず、Mac はスワップに入っていった。
Mac で model CPU offload が効かない理由
メモリに収まらないパイプラインのために diffusers に組み込まれているのが model CPU offload で、各モデルは CPU で待ち、動く間だけ GPU に移る。
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.enable_model_cpu_offload(device="mps")
Mac では CPU と GPU が一つのメモリを共有するので、「CPU で待つ」モデルも同じ RAM に載っている。offload の一回の実行で、プロセスの footprint は一度も 18.5 GB を超えず、収まっているように見えた。それでもスワップは増えた。デノイズの間に 3.5 GB、VAE のデコードで 9.6 GB まで増え、ガードは eager を止めたのと同じところで実行を止めた。footprint、つまりアクティビティモニタがプロセスに表示する数値は、すでにスワップに出たページを数えないので、これは映らない。
ステージごとにモデルを一つ読み込む
パイプラインはモデルを順番に使う。テキストエンコーダーはプロンプトのエンコードだけ、transformer はデノイズのループだけで使い、VAE のデコードではどちらも使わない。だから二つの大きなモデルが同時にメモリにある必要はない。これを管理するのが stageload だ。StagedModels は、あるステージが初めて求めたときにモデルを読み込み、そのモデルを挙げていないステージにパイプラインが入ったときに解放する。
from stageload import StagedModels, on_call

STAGES = {"encode": ["text_encoder"], "denoise": ["transformer"], "decode": []}
models = StagedModels({"text_encoder": text_encoder, "transformer": transformer}, stages=STAGES)

on_call(pipe, "encode_prompt", before=lambda *a, **k: models.enter("encode"))
on_call(pipe, "prepare_latents", before=lambda *a, **k: models.enter("denoise"))
on_call(pipe, "_unpack_latents", before=lambda *a, **k: models.enter("decode"))
text_encoder と transformer は、それぞれのモデルを from_pretrained(..., subfolder=...) で読み込んで mps に移す関数だ。パイプライン自体は text_encoder=None, transformer=None と、読み込んだままにする VAE で組み立てる。on_call は各ステージが始まるパイプラインのメソッドの直前に models.enter(stage) を呼ぶので、パイプラインのコードはそのままでよい。もう一つ必要なものがある。パイプラインはデノイズが始まる前に transformer の config を読むので、pipe.text_encoder と pipe.transformer は、.config にはチェックポイントから答え、それ以外の使い方をされたときに本物のモデルを読み込む代役にしてある。代役とメモリのトレースを含むスクリプト全体は bench/qwen_image.py にあり、ライブラリは pip install stageload で入る。
staged は二回とも最後まで終わり、94 秒と 124 秒かかった。footprint のピークはエンコード中が 19.0 GB、二回のデノイズ中が 16.2 GB と 18.6 GB、デコード中が 14.4 GB だった。どちらの実行でもスワップは増えず、空きメモリは一度も 51 % を下回らなかった。二つのモデルの読み込みには一回あたり約 13 秒、デコード前の transformer の解放にはさらに 4〜5 秒かかった。transformer がメモリに載った時点からデコードが始まるまでで数えると、20 ステップは staged の一方の実行で 70 秒、もう一方で 99 秒、eager で 77.5 秒だった。staged の二回がなぜ違ったのかはトレースからは分からない。二回とも同じ画像をビット単位で出した。
実行がスワップに入っていないか確かめる
footprint が何を示していても、実行中にスワップが増えなければ収まっている。二つのコマンドで分かる。
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
stageload の MemoryMeter は footprint、スワップ、空きメモリを 0.5 秒ごとに JSONL のトレースに書く。stageload guard はメモリに余裕ができたときにコマンドを始め、スワップが予算を超えて増えたら止める。
stageload guard --wait-free 40 --swap-budget 8G -- python generate.py測っていないこと
- VAE のタイリング。
pipe.vae.enable_tiling()は画像をタイルに分けてデコードする。eager も offload もスワップに入ったのはデコードだった。試していないので、これで eager がこの Mac で最後まで終わるかどうかは言えない。 - sequential CPU offload、量子化した重み、48 GB より少ない、または多いメモリの Mac。
- staged が eager と同じ画像を出すかどうか。eager はこの Mac で一度も画像を書き出さなかった。
測定の詳細は Qwen-Image-2.1をステージごとに と 48 GB の Mac で model CPU offload に、トレースは stageload のリポジトリ にある。