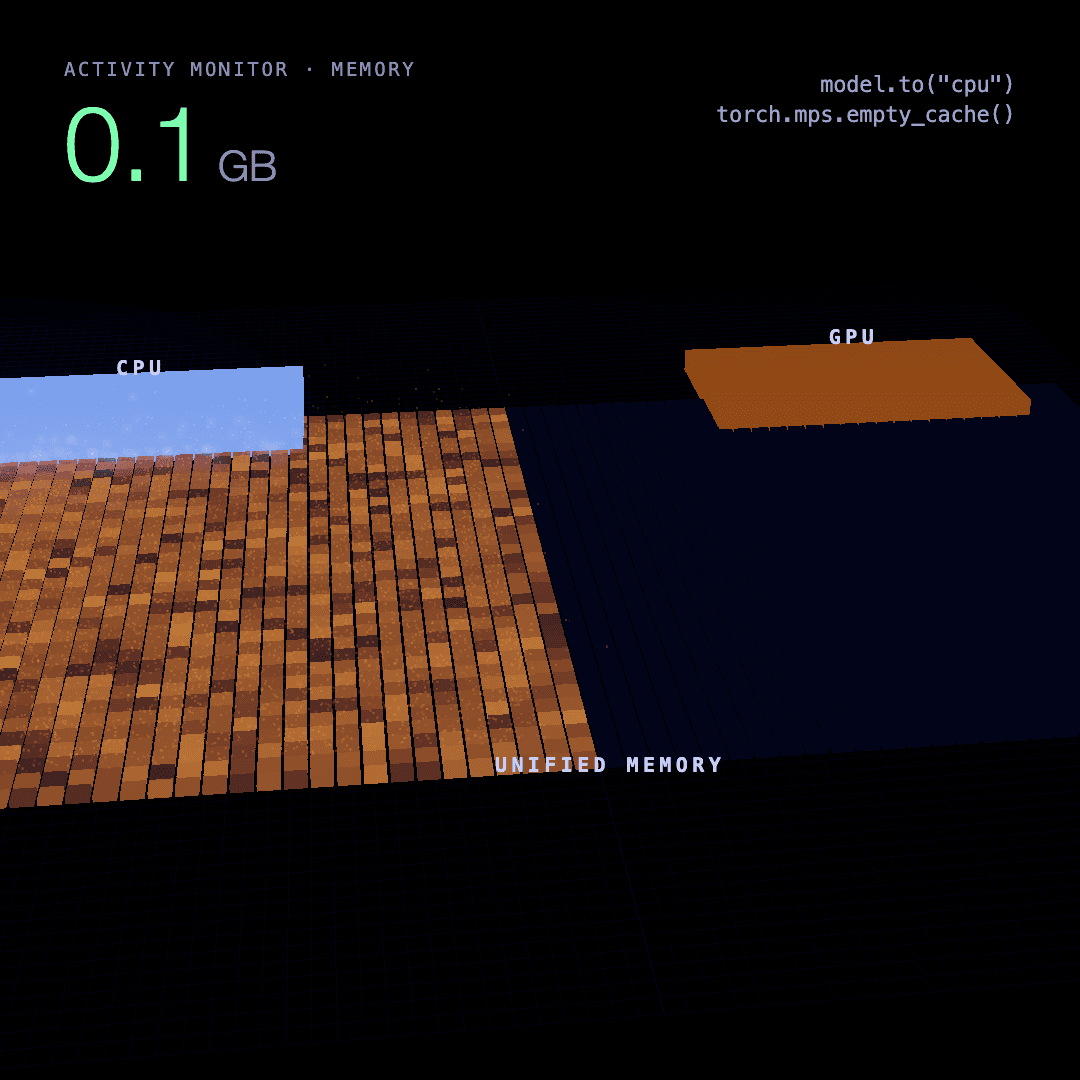
Di Mac, tensor yang dipindahkan dari mps ke CPU seolah lenyap dari memori. Footprint proses, angka di kolom Memori pada Monitor Aktivitas, turun hampir ke nol, begitu juga hitungan driver MPS. Salinannya tetap ada dan tetap memakai memori yang sama. Ini contoh minimal yang saya susun untuk diskusi diffusers tentang offloading, dengan tensor 4 GiB sebagai pengganti bobot model (torch 2.14.0, macOS 26.5.2, M5 Pro dengan 48 GB):
import ctypes, os, time
import torch

# rusage_info_v2 from <libproc.h>; phys_footprint is the Memory column of Activity Monitor
FIELDS = ("user_time", "system_time", "pkg_idle_wkups", "interrupt_wkups", "pageins",
          "wired_size", "resident_size", "phys_footprint")
class RUsageInfoV2(ctypes.Structure):
    _fields_ = [("uuid", ctypes.c_uint8 * 16)] + [(f, ctypes.c_uint64) for f in FIELDS] \
        + [(f"rest{i}", ctypes.c_uint64) for i in range(10)]

libproc = ctypes.CDLL("/usr/lib/libproc.dylib")

def show(step):
    torch.mps.synchronize()
    info = RUsageInfoV2()
    libproc.proc_pid_rusage(os.getpid(), 2, ctypes.byref(info))
    print(f"{step:<14} footprint {info.phys_footprint / 2**30:4.1f} GiB, "
          f"mps driver {torch.mps.driver_allocated_memory() / 2**30:4.1f} GiB")

show("start")
w = torch.randn(2**30, device="mps")      # 4 GiB of float32, standing in for a model's weights
show("on mps")
w = w.to("cpu")                           # what model CPU offload does when a model's turn ends
torch.mps.empty_cache(); time.sleep(2)
show("moved to cpu")
float(w.sum())                            # read every page of the cpu copy
show("cpu copy read")
start footprint 0.1 GiB, mps driver 0.0 GiB
on mps footprint 4.2 GiB, mps driver 4.0 GiB
moved to cpu footprint 0.1 GiB, mps driver 0.0 GiB
cpu copy read footprint 4.2 GiB, mps driver 0.0 GiBSaya menjalankannya tiga kali dan hasilnya selalu sama.
Apa kata angka-angkanya
Tepat setelah dipindahkan, kedua penghitung kembali hampir nol, padahal w menyimpan seluruh 4 GiB nilainya. Begitu CPU membaca setiap halaman salinannya, footprint kembali 4,2 GiB. Jadi footprint yang diambil di antara .to("cpu") dan saat CPU berikutnya menyentuh bobot itu tidak memperlihatkannya.
Alasan pemindahan itu sama sekali tidak membebaskan apa pun ada di perangkat kerasnya. Di Apple Silicon, CPU dan GPU memakai satu kolam memori fisik. Di PC, memindahkan bobot dari GPU ke CPU membebaskan VRAM untuk model berikutnya. Di Mac, bobot yang "ada di CPU" berada di RAM yang sama dengan yang dibutuhkan GPU.
Kenapa ini penting bagi model CPU offload
enable_model_cpu_offload() di diffusers menyimpan setiap model di CPU dan memindahkannya ke GPU hanya selama model itu berjalan. Saya menjalankan Qwen-Image-2.1 pada 1024 × 1024 dengan cara itu di Mac yang sama (jejak dan ulasannya). Footprint proses tidak pernah melewati 18,5 GB, yang seharusnya muat di Mac 48 GB dengan sisa ruang. Swap bertambah 3,5 GB selama denoising dan sudah bertambah 9,6 GB saat decode VAE, lalu penjaga memori saya menghentikan run sebelum gambar tertulis.
Grafik footprint saja akan menyebut run itu muat. Contoh di atas menunjukkan satu cara footprint tetap rendah padahal bobotnya masih di memori. Halaman mana yang masuk swap pada run offload tidak saya ukur.
Cara memeriksa run sendiri
Lihat swap, bukan hanya footprint:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
Kalau swap bertambah selama job berjalan, job itu tidak muat, apa pun kata footprint. stageload (pip install stageload), pustaka kecil yang saya tulis untuk ini, mencatat keduanya ke jejak setiap 0,5 detik lewat MemoryMeter, dan stageload guard menghentikan perintah begitu swap tumbuh melewati anggaran:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.pyYang benar-benar membebaskan memori
Untuk pipeline yang menjalankan modelnya satu per satu, solusinya adalah memuat model saat tahapnya mulai dan melepasnya saat tahap selesai, alih-alih memarkirnya di CPU. release(module) dari stageload memindahkan setiap parameter dan buffer ke perangkat meta milik PyTorch, menjalankan pengumpulan sampah, dan mengosongkan cache MPS; tensor di meta tidak punya penyimpanan, jadi memorinya kembali walaupun kode lain masih memegang referensi ke modul itu. Dengan text encoder (16,3 GB) dan transformer (13,3 GB) dimuat satu per satu seperti ini, puncak Qwen-Image-2.1 di Mac yang sama 19,0 GB, dan swap tidak bertambah di kedua run. Pengaturan lengkapnya ada di Cara menjalankan Qwen-Image-2.1 di Mac 48 GB tanpa swap.
Yang tidak saya ukur
- Memori bebas seluruh sistem selama contoh: job lain di Mac ini menggesernya beberapa GiB di antara run, jadi saya tidak mendapat angka yang bersih.
- Apakah
delditambahtorch.mps.empty_cache()mengembalikan memori sepenuh pemindahan kemeta, dan seberapa cepat. - Versi macOS dan torch lain, serta Mac dengan memori lebih besar.