Saat job PyTorch kehabisan memori di Mac, error-nya diakhiri dengan sebuah saran:
RuntimeError: MPS backend out of memory (MPS allocated: 18.50 GiB, other allocations: 448.00 KiB, max allowed: 18.72 GiB). Tried to allocate 512.00 MiB on shared pool. Use PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.0 to disable upper limit for memory allocations (may cause system failure).Saya ingin tahu apa yang terjadi kalau saran itu diikuti, jadi saya mengisi memori MPS selangkah demi selangkah, 512 MiB tiap langkah, di M5 Pro saya yang punya 48 GB (macOS 26.5.2, PyTorch 2.14.0), sekali per pengaturan, di bawah penjaga yang menghentikan proses begitu swap bertambah 2 GB. Hasilnya ada dua. Di Mac ini batas bawaannya lebih besar dari RAM, jadi job yang memorinya tidak cukup tergelincir ke swap dan tidak pernah sampai ke error ini. Dan untuk menurunkan batas dibutuhkan dua variabel, bukan satu.
Dari mana "max allowed" berasal
max allowed adalah batasnya: PYTORCH_MPS_HIGH_WATERMARK_RATIO dikali nilai yang dikembalikan torch.mps.recommended_max_memory(). Di Mac saya nilainya 37,44 GiB, dan 0,5 × 37,44 = 18,72 GiB, angka di error tadi. Di log saya MPS allocated sama dengan torch.mps.current_allocated_memory(), yaitu memori yang dipakai tensor. Untuk melihat angka dasar milik Anda:
import torch
print(torch.mps.recommended_max_memory() / 2**30, "GiB")
Kenapa Mac 48 GB masuk swap lebih dulu
Dokumentasi PyTorch menyebut nilai bawaan rasio high adalah 1,7. Di Mac saya itu membuat batasnya sekitar 63,6 GiB, lebih besar dari memori yang dimiliki mesin ini. Inilah yang terjadi dengan tiap pengaturan:
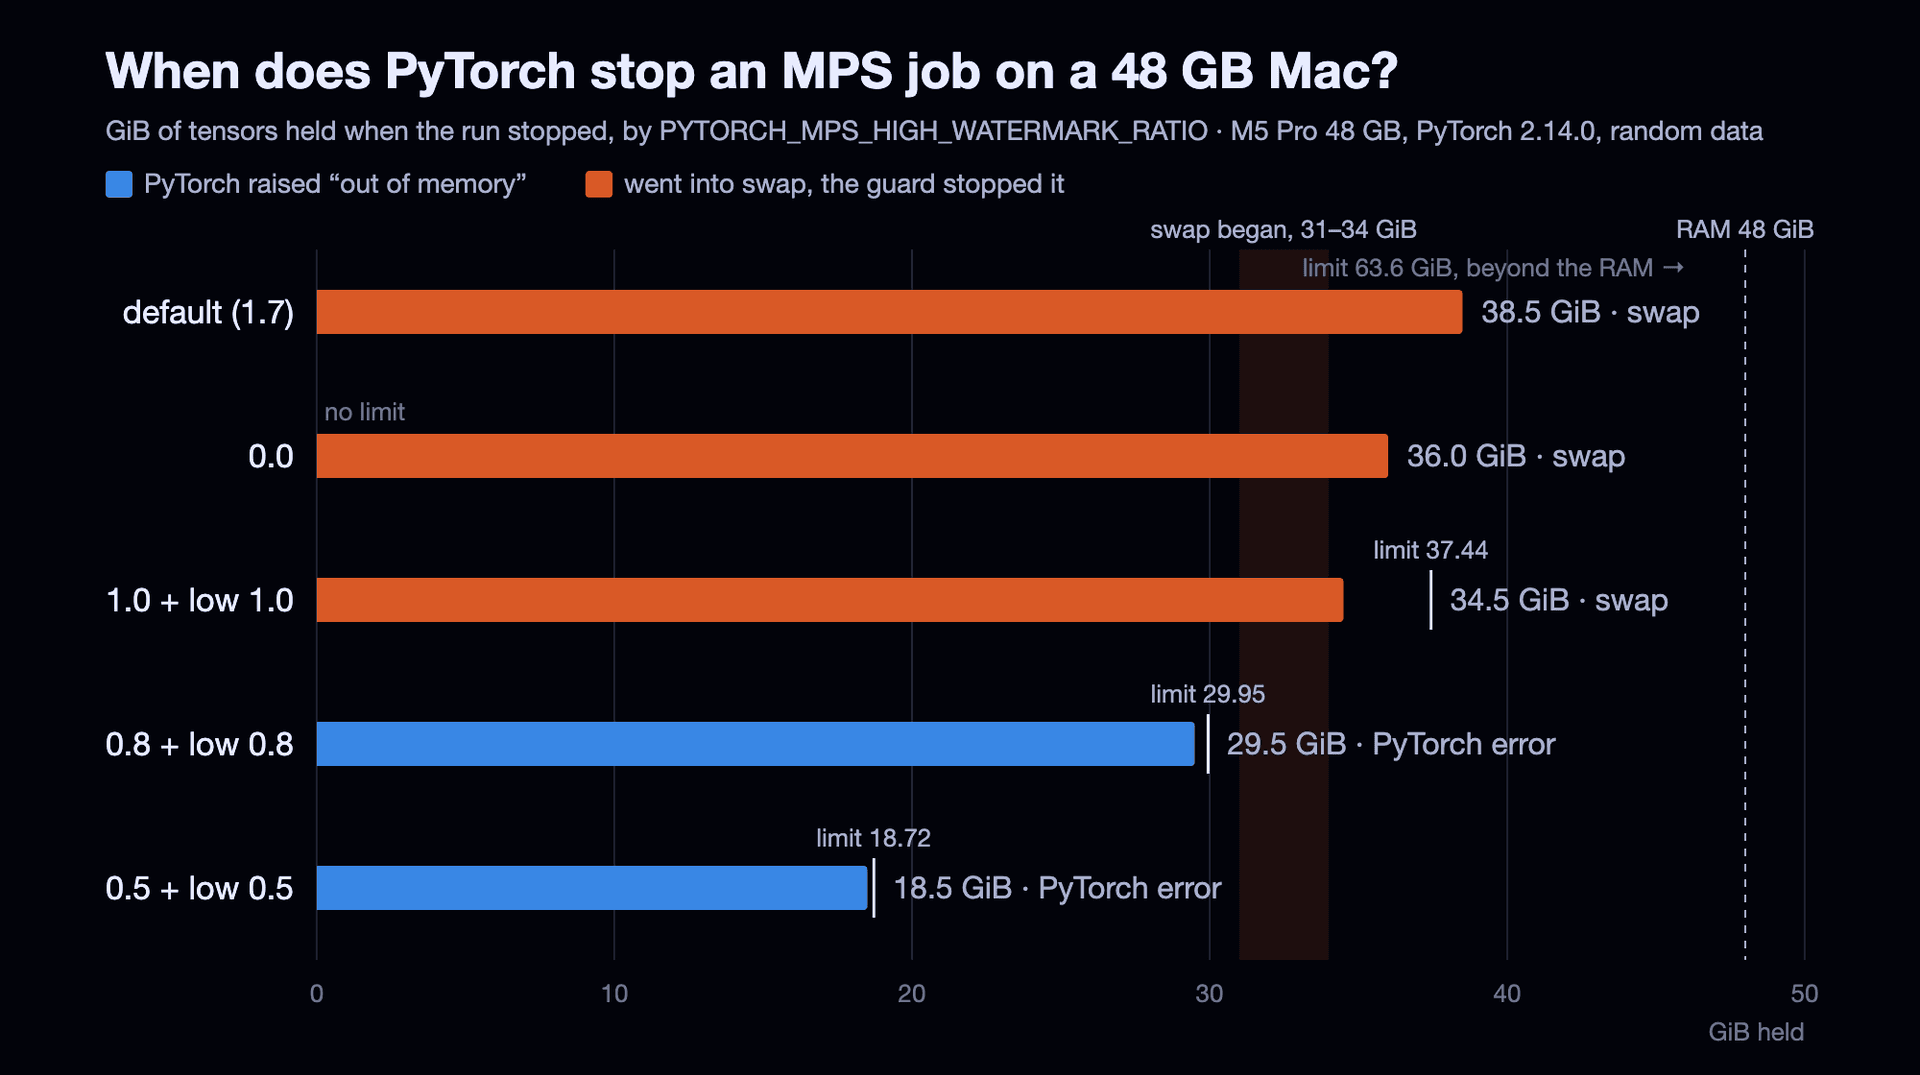
| pengaturan | yang menghentikan pengisian | tensor yang ditahan | swap selama run |
|---|---|---|---|
| bawaan (1,7) | penjaga | 38,5 GiB | 6,1 → 12,0 GB |
| 0,0 | penjaga | 36,0 GiB | 5,1 → 9,8 GB |
| 1,0, low 1,0 | penjaga | 34,5 GiB | 4,6 → 8,7 GB |
| 0,8, low 0,8 | PyTorch, max allowed 29,95 GiB | 29,5 GiB | tidak berubah |
| 0,5, low 0,5 | PyTorch, max allowed 18,72 GiB | 18,5 GiB | tidak berubah |
Dengan nilai bawaan, dengan 0,0, dan dengan 1,0, swap mulai bertambah begitu proses melewati 33,5 sampai 36,2 GB, dan PyTorch tidak pernah memunculkan error: batasnya lebih jauh daripada ujung RAM. Jadi 0.0, saran di dalam error itu sendiri, tidak mengubah apa pun yang bisa saya lihat di sini. Batasnya memang sudah tak terjangkau, dan tidak ada apa pun di PyTorch yang menghentikan run.
Cara mengaturnya: dua variabel
Kalau hanya rasio high yang diatur, prosesnya gagal di panggilan MPS pertama:
$ PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 python fill.py
RuntimeError: invalid low watermark ratio 1.4
Di Apple Silicon rasio low bawaannya 1,4 dan tidak boleh lebih besar dari rasio high (kecuali rasio high 0,0, yang mematikan batas). Atur keduanya:
PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.8 PYTORCH_MPS_LOW_WATERMARK_RATIO=0.8 python run.pyDari Python, atur keduanya sebelum tensor pertama masuk ke mps. PyTorch membacanya saat MPS mulai, bukan saat import torch, dan mengabaikan perubahan sesudahnya:
import os
os.environ["PYTORCH_MPS_HIGH_WATERMARK_RATIO"] = "0.8"
os.environ["PYTORCH_MPS_LOW_WATERMARK_RATIO"] = "0.8"
import torch
Dokumentasi menyebut rasio low sebagai batas lunak dan menulis bahwa "setting 0.0 disables adaptive commit and garbage collection". Saya menyamakannya dengan rasio high dan tidak mengukurnya secara terpisah.
Memilih nilai
Batasnya harus tetap di bawah memori yang benar-benar kosong di Mac Anda, dengan aplikasi yang biasa Anda buka. Di Mac saya 1,0 (37,44 GiB) sudah terlalu banyak, dan 0,8 (29,95 GiB) memberi error yang bersih tanpa swap. Setelah error yang bersih, Anda bisa menurunkan batch size atau resolusi lalu mencoba lagi; run yang tergelincir ke swap lebih dulu memperlambat seluruh Mac.
Jebakan saat menguji
Run pertama saya mengisi tensor dengan torch.ones. Dengan pengaturan bawaan, run itu mencapai batas 46 GiB yang saya pasang, tanpa error dan sama sekali tanpa swap: macOS memadatkan halaman berisi nilai yang sama hampir sampai nol. Bobot model tidak terkompresi seperti itu, jadi uji memori di Mac butuh data acak.
Kalau modelnya memang tidak muat
Error yang bersih hanya memberi tahu bahwa modelnya tidak muat. Untuk pipeline dengan beberapa model, memuat hanya model dari tahap yang sedang berjalan lebih membantu daripada rasio mana pun, dan itulah sebabnya saya menulis stageload. Skrip pengisi dan trace dari semua run di atas ada di repositorinya, di bench/results/2026-10-13-mps-watermark.