Catatan kedua tentang stageload menjalankan Qwen-Image-2.1 di Mac 48 GB dengan dua cara. Penjaga memori menghentikan eager saat decode VAE, sedangkan staged selesai. diffusers punya cara ketiga bawaan, enable_model_cpu_offload, yang menyimpan setiap model di CPU dan memindahkannya ke GPU hanya selama model itu berjalan. Pada 8 Oktober saya menjalankannya sekali, dengan prompt, ukuran, jumlah langkah, seed, dan batas penjaga yang sama seperti run 6 Oktober.
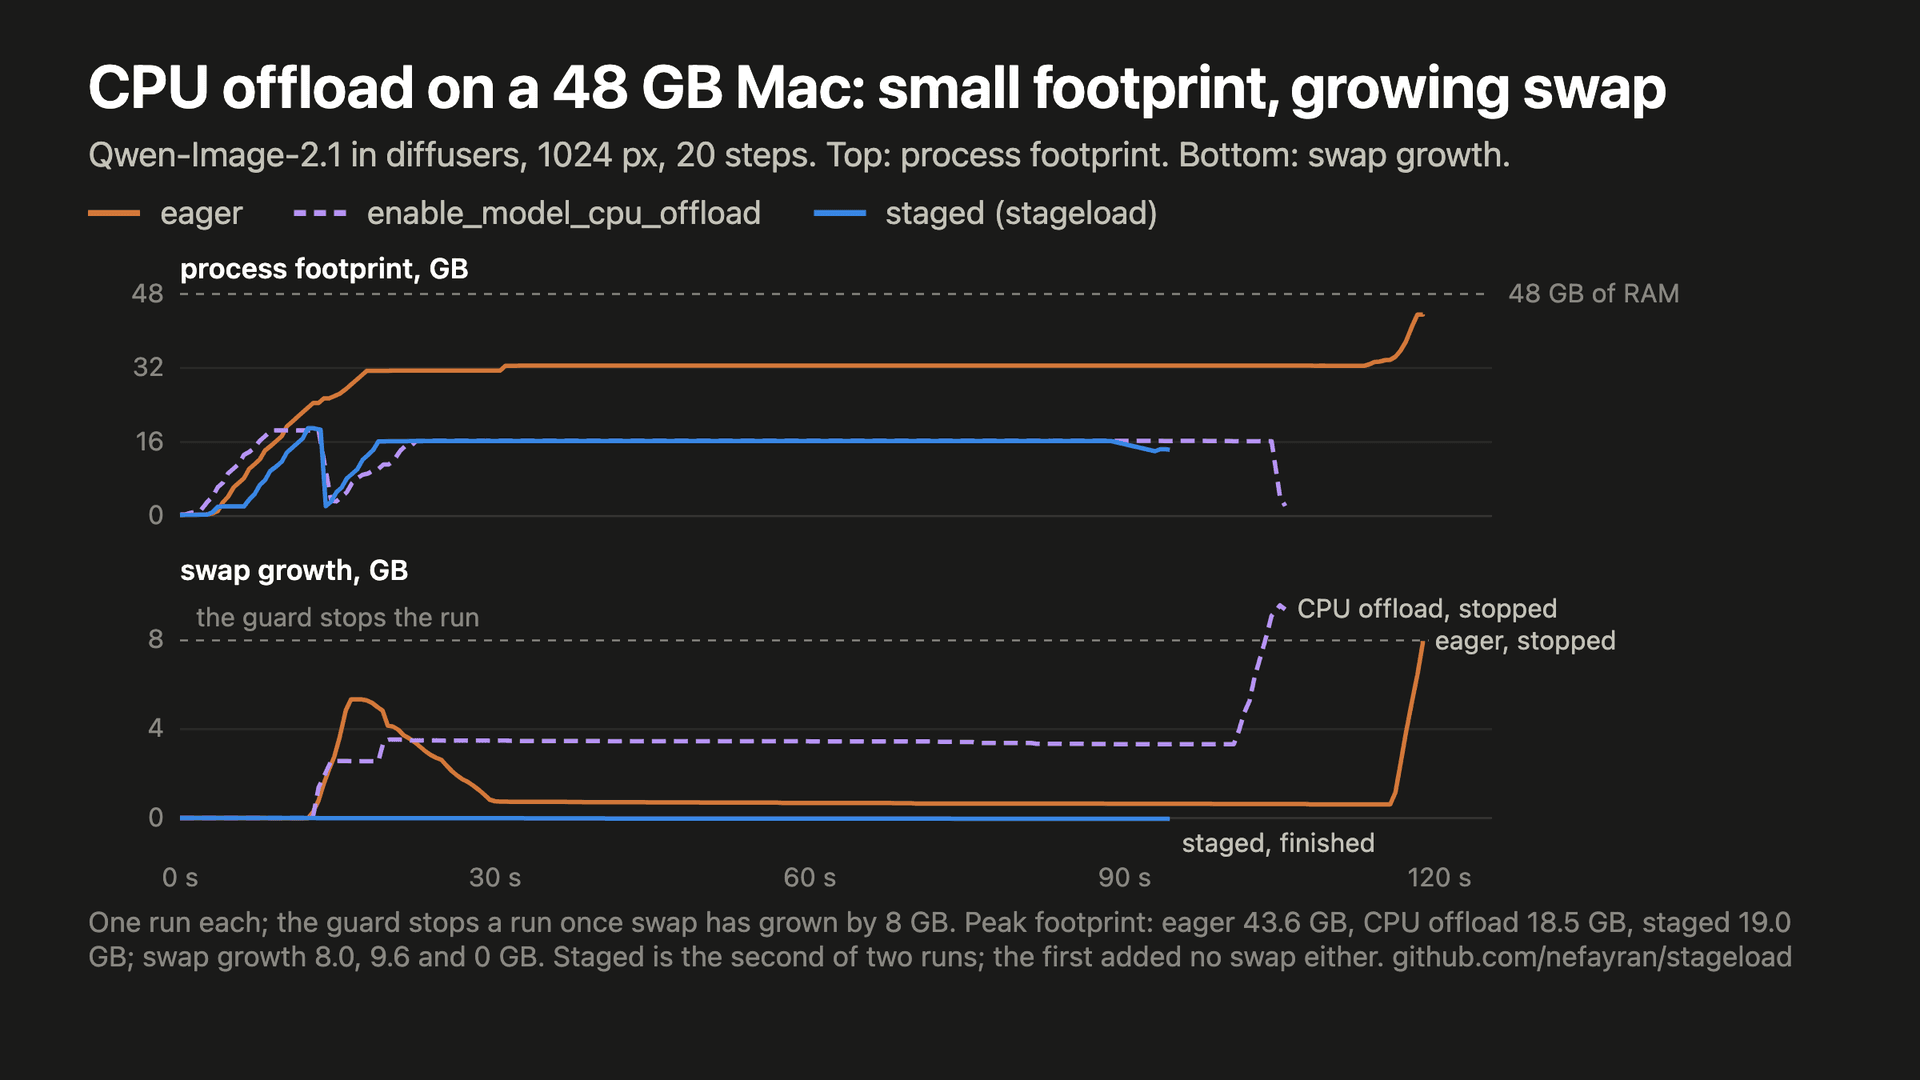
Menurut footprint proses, offload tampak seperti staged: puncaknya 18,5 GB, staged 19,0 GB. Swap yang membedakan keduanya. Encoding memakan 8 detik dan tidak menambah swap. Selama 87 detik denoising, swap bertambah 3,5 GB dan memori yang tersedia turun ke 27 %. Decode VAE membawa pertambahan swap ke 9,6 GB dan memori yang tersedia ke 22 %, lalu penjaga menghentikan run pada detik ke-105, sebelum gambar ditulis. Staged tidak menambah swap di kedua run-nya dan selesai dalam 94 dan 124 detik.
Footprint tidak bisa menunjukkan hal ini, karena footprint tidak menghitung halaman yang sudah ada di swap. Di Mac, CPU dan GPU berbagi satu kolam memori, sehingga model yang disimpan "di CPU" menempati RAM yang sama dengan model yang sedang berjalan. Jika dinilai dari footprint saja, offload berada di sebelah staged. Dari swap, ia berada di sebelah eager, yang dihentikan penjaga di titik yang sama setelah 8 GB swap baru.
Yang tidak bisa saya tunjukkan
Ini satu run. Run kedua akan kembali mendorong mesin ke swap demi hasil yang sudah diputuskan oleh penjaga. Saya tidak mengukur halaman mana yang masuk ke swap, dan saya tidak mencoba offload di Mac dengan memori lebih besar.
Skripnya ada di bench/qwen_image_offload.py, dan trace-nya ada di repositori. stageload dipasang dengan pip install stageload.