Qwen-Image-2.1 berjalan di diffusers lewat QwenImage21Pipeline. Dalam bfloat16, text encoder-nya memakan 16,3 GB, transformer-nya 13,3 GB, dan VAE-nya 1,3 GB, sehingga pipeline yang sudah dimuat mencapai 31,4 GB di Mac 48 GB, dan decode gambar 1024 × 1024 menaikkannya 11 GB lagi. Panduan ini menunjukkan apa yang terjadi dengan cara biasa di Mac itu, mengapa model CPU offload tidak membantu, dan cara yang selesai: hanya satu dari dua model besar yang ada di memori pada satu waktu.
Run dijalankan di Apple M5 Pro 48 GB, dengan torch 2.14.0 dan diffusers 0.41.0.dev0 dari main. QwenImage21Pipeline juga ada di rilis diffusers 0.41.0, tetapi rilis itu tidak saya jalankan. Setiap run membuat satu gambar 1024 × 1024 dalam 20 langkah dengan seed 7, di bawah penjaga memori yang menghentikan run begitu swap bertambah 8 GB.
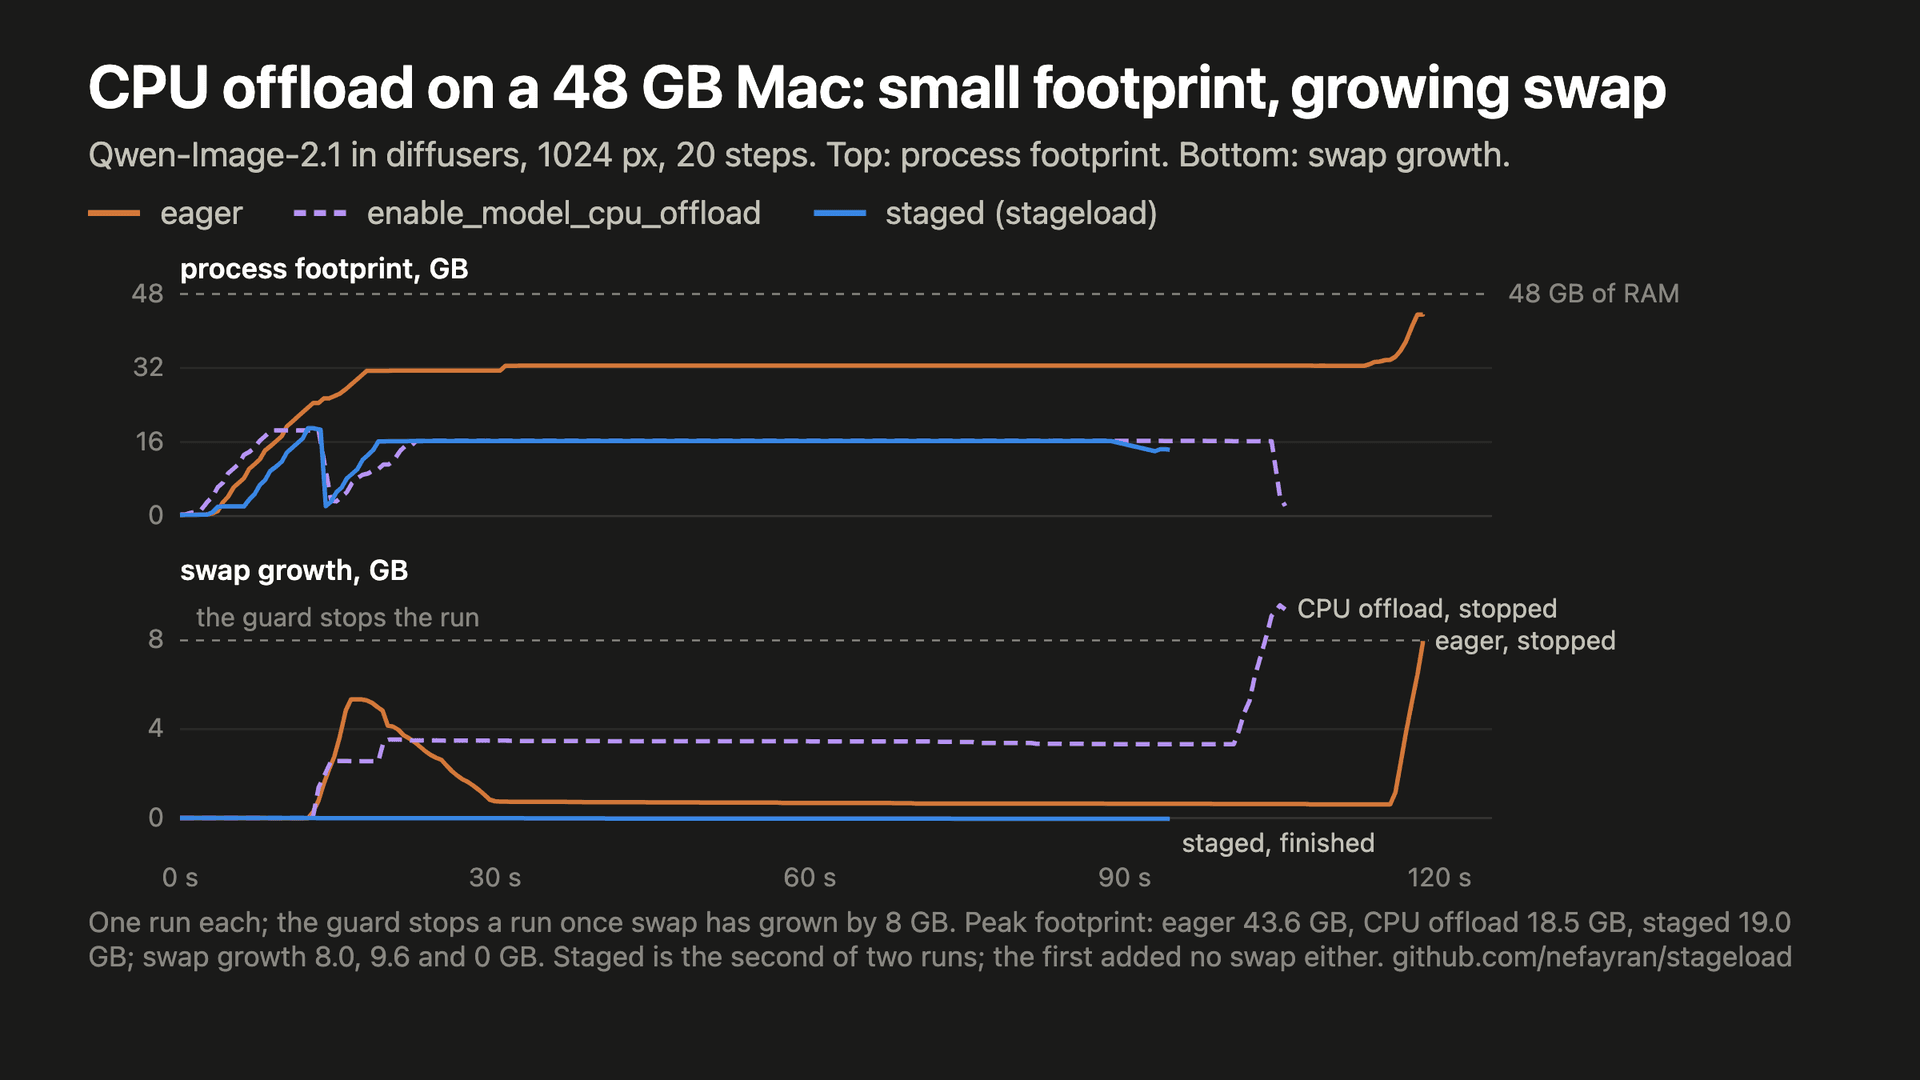
Eager masuk swap saat decode
Kode biasa memuat ketiga model ke GPU dan membiarkannya di sana:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("mps")
image = pipe(prompt=prompt, width=1024, height=1024, num_inference_steps=20).images[0]
Run ini melewati encoding dan seluruh 20 langkah denoising di 31 sampai 33 GB. Lalu decode VAE menaikkan footprint dari 32,5 ke 43,6 GB dan swap bertambah 8 GB, sehingga penjaga menghentikan run sebelum gambar ditulis. Sebelum itu PyTorch tidak memunculkan error kehabisan memori; Mac justru masuk swap.
Mengapa model CPU offload tidak membantu di Mac
Untuk pipeline yang tidak muat di memori, diffusers punya model CPU offload bawaan: setiap model menunggu di CPU dan pindah ke GPU hanya selama ia berjalan.
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.enable_model_cpu_offload(device="mps")
Di Mac, CPU dan GPU berbagi satu kumpulan memori, jadi model yang menunggu "di CPU" tetap berada di RAM yang sama. Pada satu-satunya run offload, footprint proses tidak pernah melewati 18,5 GB, dan dari angka itu semuanya tampak muat. Swap tetap bertambah: 3,5 GB selama denoising dan sampai 9,6 GB saat decode VAE, dan penjaga menghentikan run di titik yang sama dengan eager. Footprint, yaitu angka yang ditampilkan Activity Monitor untuk sebuah proses, tidak menghitung halaman yang sudah masuk swap, jadi hal ini tidak terlihat di sana.
Muat satu model per tahap
Pipeline memakai model-modelnya bergantian: text encoder hanya untuk meng-encode prompt, transformer hanya di loop denoising, dan keduanya tidak dipakai saat decode VAE. Jadi dua model besar itu tidak pernah perlu ada di memori bersamaan. stageload yang mencatatnya: StagedModels memuat sebuah model saat suatu tahap pertama kali memintanya dan melepasnya saat pipeline masuk ke tahap yang tidak mencantumkannya.
from stageload import StagedModels, on_call

STAGES = {"encode": ["text_encoder"], "denoise": ["transformer"], "decode": []}
models = StagedModels({"text_encoder": text_encoder, "transformer": transformer}, stages=STAGES)

on_call(pipe, "encode_prompt", before=lambda *a, **k: models.enter("encode"))
on_call(pipe, "prepare_latents", before=lambda *a, **k: models.enter("denoise"))
on_call(pipe, "_unpack_latents", before=lambda *a, **k: models.enter("decode"))
text_encoder dan transformer adalah fungsi yang memuat masing-masing model dengan from_pretrained(..., subfolder=...) lalu memindahkannya ke mps. Pipeline-nya sendiri dibangun dengan text_encoder=None, transformer=None dan VAE, yang tetap dimuat. on_call menjalankan models.enter(stage) tepat sebelum metode pipeline tempat setiap tahap dimulai, jadi kode pipeline tetap apa adanya. Masih ada satu bagian lagi: pipeline membaca config transformer sebelum denoising dimulai, jadi pipe.text_encoder dan pipe.transformer adalah pengganti yang menjawab .config dari checkpoint dan memuat model aslinya untuk penggunaan lain apa pun. Skrip lengkapnya, dengan pengganti itu dan jejak memori, ada di bench/qwen_image.py, dan pustakanya dipasang dengan pip install stageload.
Kedua run staged selesai, dalam 94 dan 124 detik. Footprint memuncak di 19,0 GB saat encoding, di 16,2 dan 18,6 GB saat denoising kedua run, dan di 14,4 GB saat decode. Swap tidak bertambah di kedua run, dan memori bebas tidak pernah turun di bawah 51 %. Memuat kedua model memakan sekitar 13 detik per run, dan melepas transformer sebelum decode memakan 4 sampai 5 detik lagi. Dihitung dari saat transformer ada di memori sampai decode dimulai, 20 langkah memakan 70 detik di satu run staged, 99 detik di run lainnya, dan 77,5 detik untuk eager; jejaknya tidak menunjukkan mengapa kedua run staged berbeda. Keduanya menghasilkan gambar yang sama, bit demi bit.
Memeriksa apakah sebuah run masuk swap
Sebuah run muat jika swap tidak bertambah selama run berjalan, apa pun yang ditunjukkan footprint. Dua perintah menunjukkannya:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
MemoryMeter dari stageload menulis footprint, swap, dan memori bebas ke jejak JSONL setiap 0,5 detik, dan stageload guard memulai sebuah perintah saat ada ruang untuknya dan menghentikannya begitu swap bertambah melebihi batas:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.pyYang tidak saya ukur
- Tiling VAE.
pipe.vae.enable_tiling()men-decode gambar per ubin, dan decode adalah tahap tempat eager dan offload masuk swap. Saya tidak mencobanya, jadi saya tidak bisa bilang apakah dengan itu eager bisa selesai di Mac ini. - Sequential CPU offload, bobot terkuantisasi, dan Mac dengan memori kurang atau lebih dari 48 GB.
- Apakah staged menghasilkan gambar yang sama dengan eager. Eager tidak pernah menulis gambar di Mac ini.
Detail pengukurannya ada di Qwen-Image-2.1 tahap demi tahap dan Model CPU offload di Mac 48 GB, dan jejaknya ada di repositori stageload.