Мой прошлый бенчмарк показал, что граф кода не сделал моего агента дешевле. Сказать больше он не мог, слишком был мал: 24 вопроса, ничего крупнее 25 тыс. узлов графа, без Opus. Поэтому я прогнал его заново в таком масштабе, где ответ мог измениться, и сначала записал план. Гипотезы, репозитории, бюджет и анализ лежат в PLAN-v2.md, закоммиченном до первого запуска.
Коротко: граф окупается, когда без него модель продолжала бы искать. Haiku на kubernetes и vscode — как раз такой случай. Sonnet там немного экономит, opus ничего, а на маленьком репозитории граф обходится sonnet дороже простого grep.
Постановка
Агент — GitHub Copilot CLI 1.0.90 в headless-режиме, один вопрос на сессию, в двух вариантах:
- grep: инструменты Copilot view, grep и glob, и больше ничего;
- граф: те же три инструмента плюс cbm-lean (моя тонкая обёртка вокруг codebase-memory-mcp 0.9.0) и правило маршрутизации в начале промпта: граф для вызывающих, вызываемых и цепочек вызовов, grep для точных строк.
Четыре открытых репозитория, каждый закреплён на коммите:
| репозиторий | язык | узлов графа |
|---|---|---|
| full-stack-fastapi-template | Python, TypeScript | 1 601 |
| dub | TypeScript | 25 023 |
| kubernetes | Go | 146 421 |
| vscode | TypeScript | 218 883 |
На каждый репозиторий 16 вопросов. Восемь структурных: кто вызывает функцию, что она вызывает, путь вызовов от
CLI-команды или HTTP-обработчика до заданной функции и какие функции сломаются, если поменять сигнатуру. Восемь
точных: значение из конфига, где читается переменная окружения, строка, на которой бросается ошибка, строка, на
которой определён тип. Каждый ключ ответа я вручную сверил с кодом на закреплённом коммите, и элемент засчитывается
только целым словом, так что init_db не сойдёт за init.
Haiku 4.5 ответил на все 64 вопроса трижды в каждом варианте, sonnet 5 — дважды. Opus 5.5 в Copilot стоит 15 премиум-запросов на промпт, поэтому он ответил один раз на двенадцать структурных вопросов из kubernetes и vscode. Всего 664 запуска и около 744 премиум-запросов.
Стоимость — tokenEquiv, как в первой заметке: некешированный вход, плюс 1,25 × записи в кеш, плюс 0,1 × чтения из кеша, сумма по всем вызовам модели в запуске.
Результаты
Стоимость графа как доля от стоимости grep: для каждого вопроса медиана варианта с графом по повторам, делённая на медиану варианта с grep, затем медиана по вопросам, с 95-процентным бутстреп-интервалом. Ниже 1 — граф дешевле.
| модель | размер репозитория | структурные | точные |
|---|---|---|---|
| haiku 4.5 | маленький (1,6 тыс. узлов) | 0,88 (0,65–1,29) | 0,92 (0,72–1,15) |
| haiku 4.5 | средний (25 тыс.) | 0,61 (0,11–1,50) | 0,96 (0,75–1,37) |
| haiku 4.5 | большой (146 тыс., 219 тыс.) | 0,29 (0,11–0,70) | 1,01 (0,94–1,28) |
| sonnet 5 | маленький | 1,51 (1,45–1,70) | 1,42 (1,20–1,71) |
| sonnet 5 | средний | 0,94 (0,57–2,00) | 1,14 (1,05–1,30) |
| sonnet 5 | большой | 0,74 (0,62–0,92) | 1,13 (1,01–1,29) |
| opus 5.5 | большой | 0,97 (0,72–1,10) | – |
Правильные ответы на структурные вопросы, граф против grep:
| модель | маленький | средний | большой |
|---|---|---|---|
| haiku 4.5 | 13/24 против 19/24 | 20/24 против 22/24 | 38/47 против 33/48 |
| sonnet 5 | 13/16 против 15/16 | 16/16 против 16/16 | 32/32 против 28/32 |
| opus 5.5 | – | – | 12/12 против 12/12 |
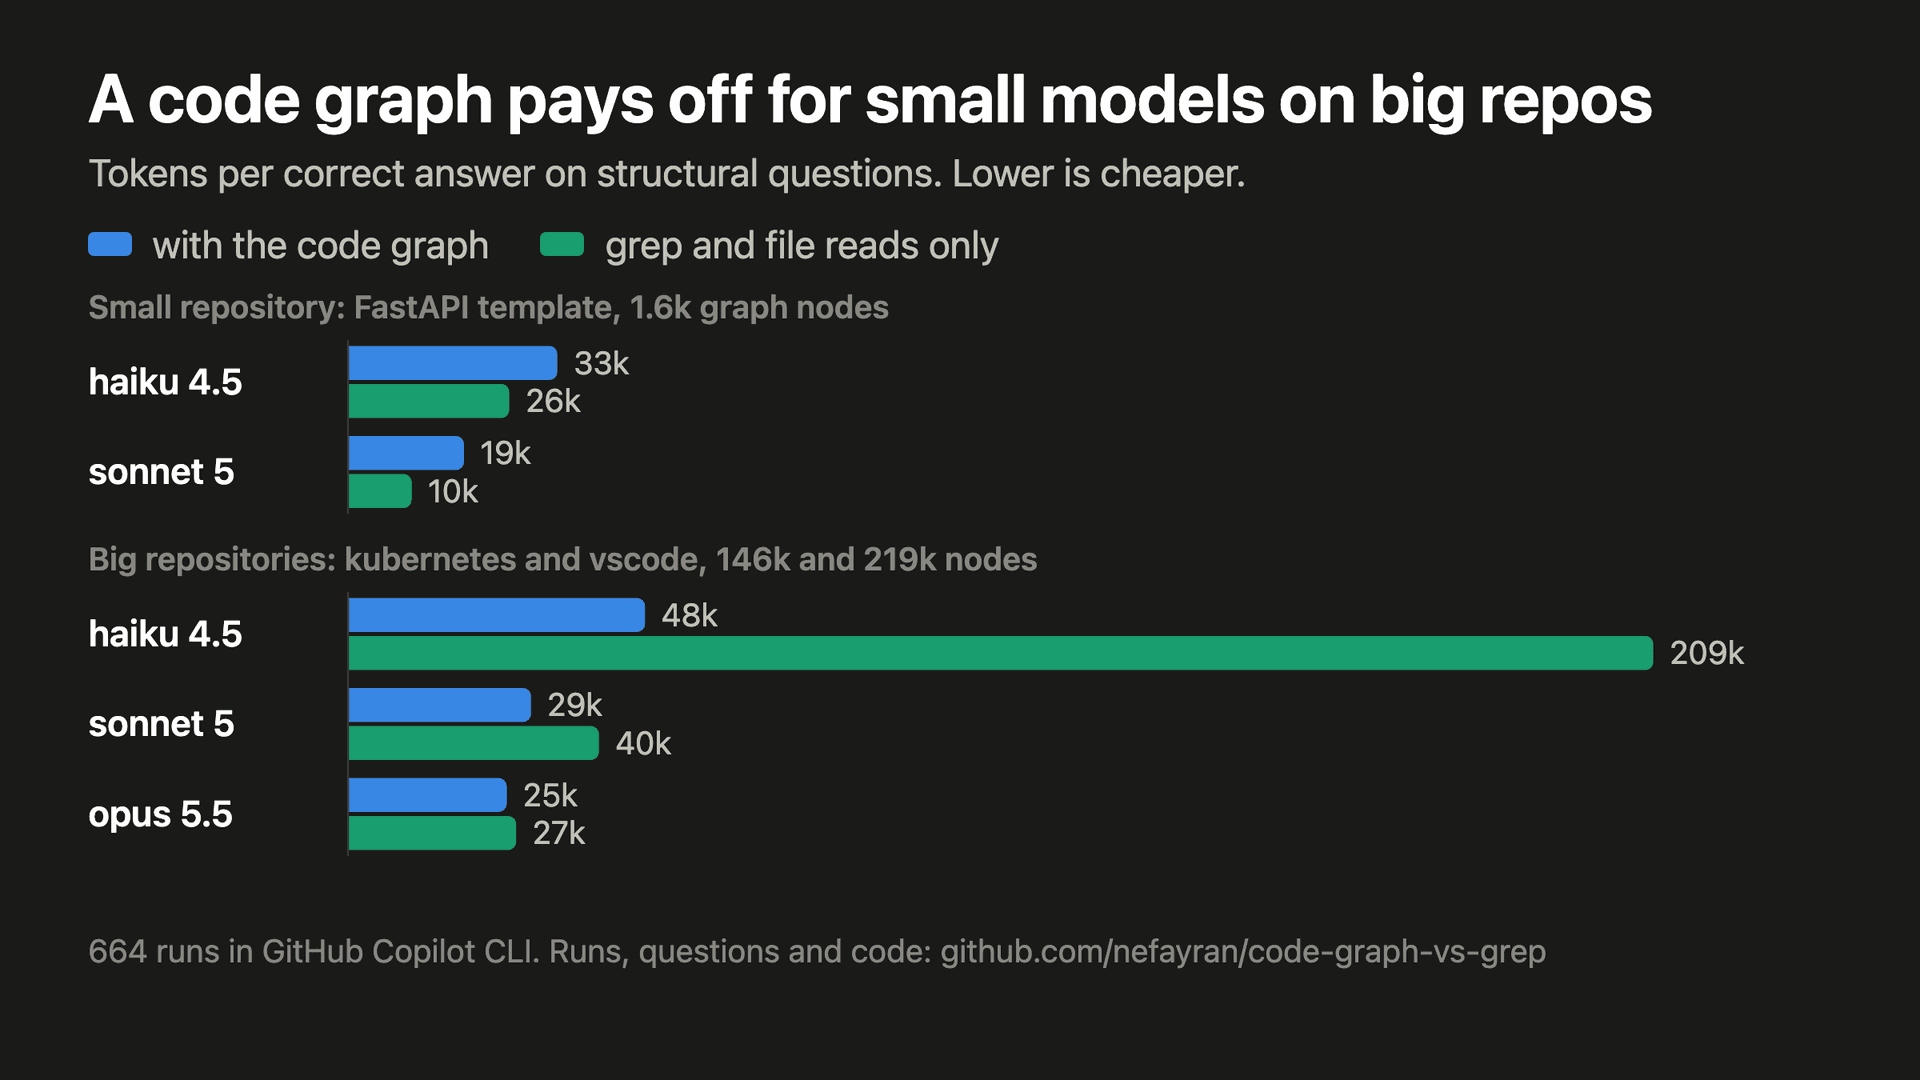
Стоимость и точность вместе — tokenEquiv на один правильный ответ на структурный вопрос:
Что выдерживает проверку:
- На kubernetes и vscode haiku с графом потратил на структурные вопросы 0,29 от того, что тратил с grep, и был дешевле на 15 вопросах из 16. При этом он чаще отвечал правильно, так что в пересчёте на правильный ответ разрыв 47 тыс. против 209 тыс. tokenEquiv. Это единственный результат, который выдерживает поправку Холма по всем 13 тестам (p = 0,006).
- Sonnet на тех же вопросах: 0,74, дешевле на 12 вопросах из 16, и 32 правильных из 32 против 28 из 32. Opus: 0,97, дешевле на 7 из 12, и все ответы правильные в обоих вариантах.
- На маленьком репозитории граф не окупился ни разу. Haiku потратил примерно столько же и чаще ошибался на структурных вопросах. Sonnet потратил на 42–51 % больше.
- На точных вопросах граф не дал измеримой разницы для haiku, а sonnet переплатил за него 13–42 %.
- Схемы инструментов графа и правило маршрутизации добавляют к каждому вызову модели постоянные 1,56 тыс. токенов промпта у haiku и 2,07 тыс. у sonnet и opus, на любом размере репозитория.
Почему маленькая модель выигрывает больше всех
Посчитайте вызовы модели. С grep haiku требовалось по медиане 22 вызова на структурный ответ на kubernetes и 20 на vscode, а один вопрос о последствиях смены сигнатуры занял 114. С графом — 5 и 4. Каждый вызов заново отправляет весь разговор, поэтому длинный поиск стоит гораздо больше, чем подсказывает число вызовов: самый дорогой ответ haiku с grep обошёлся в 471 тыс. tokenEquiv.
Поиски sonnet с grep были короче: 8 вызовов против 4 с графом. Opus в обоих вариантах уложился в 4 или 5 вызовов, так что графу нечего было сокращать, а постоянные накладные расходы съели то немногое, что он сэкономил.
Моё предположение, которое я напрямую не проверял: граф заменяет шаги поиска, поэтому окупается тогда, когда без него модель сделала бы их много, то есть у более слабой модели на более крупном репозитории. Сильная модель и так ищет через grep эффективно, а на маленьком репозитории много шагов не нужно никому.
Copilot списывает премиум-запросы за промпт, сколько бы вызовов ни было, так что внутри Copilot граф денег не экономит. Он экономит время: структурные ответы haiku на больших репозиториях заняли по медиане 71 секунду с графом и 157 секунд с grep. На маленьком репозитории вариант с графом был медленнее.
Где ошибался каждый вариант
- Поле под названием
lines. На вопрос, на какой строке определёнHorizontalController, вариант с графом во всех пяти запусках ответил horizontal.go:43, и haiku, и sonnet. Структура начинается на строке 93 и занимает 43 строки. Сниппет, который возвращает codebase-memory-mcp, содержит"start_line": 93,"end_line": 135и"lines": 43, и модели принимали последнее поле за номер строки. То же повторилось сLemonSqueezyClient(client.ts:129 для класса на строке 59 длиной 129 строк), а haiku сделал то же самое сCursorsController. В первой заметке я списал этот client.ts:129 на «номера строк из графа»; вот откуда он взялся. Sonnet с grep правильно ответил на все три вопроса. cbm-lean теперь отдаёт это поле какline_count. - Дыры в графе, которым доверились. codebase-memory-mcp 0.9.0 не записывает ребро вызова для простого вызова
функции, импортированной через
from x import y. На вопрос, что вызываетrecover_password, вариант с графом во всех пяти запусках ответил «только get_user_by_email», и haiku, и sonnet, прямо из графа и без единого grep. Функция вызывает ещёgenerate_password_reset_token,generate_reset_password_emailиsend_email, и вариант с grep каждый раз находил все четыре. - Пропущенный дефис. Инструмент grep в Copilot показывает номера строк, только если получает
"-n": true, а его инструмент view отдаёт файл без них. Sonnet передал-nв 508 из 571 вызова grep, opus — во всех 53. Haiku передалnбез дефиса 920 раз и-n22 раза из 1 949. Инструмент молча игнорирует неизвестный ключ, так что haiku не получал номеров, считал строки в открытом файле сам и промахивался на несколько: для ошибки на строке 112 он отвечал 105, 107, 108 и 113. Все неверные ответы haiku на точные вопросы, кроме одного из 79, — это неверный номер строки. - Длинные поиски, которые всё равно проваливаются. На цепочке вызовов от
kubeadm token createдоencodeTokenSecretDatahaiku с grep тратил от 18 до 22 вызовов и все три раза ошибся в пути. С графом он тоже ошибся. Sonnet ответил правильно в обоих вариантах. - Haiku трижды пытался вызвать bash в варианте с grep. Copilot отказал, потому что такого инструмента там нет, так что ни один запуск не воспользовался инструментом чужого варианта.
Что изменилось с первой заметки
Первая заметка советовала не ждать экономии токенов от графа с моделями Claude на репозиториях до 25 тыс. узлов. На таких размерах это по-прежнему верно. Она упустила то, что происходит дальше: на kubernetes и vscode маленькие модели выигрывают, и чем меньше модель, тем сильнее.
Что я сказал бы команде, которая подключает граф к агенту
- Сначала измерьте на своём самом большом репозитории со своей самой дешёвой моделью. Именно там граф оправдывает себя.
- С сильной моделью на маленьком или среднем репозитории обойдитесь без него. Вы платите за его схемы в каждом вызове и ничего не получаете взамен.
- Продолжайте отправлять точные вопросы в grep. На них граф не выиграл ни разу.
- Не позволяйте модели брать на веру номера строк или «это полный список» из вывода графа. Убирайте или
переименовывайте поля вроде
lines, прежде чем они дойдут до модели.
Ограничения
- Одна обвязка для агента (Copilot CLI) и один граф (codebase-memory-mcp 0.9.0 за моей обёрткой). Claude Code, другой граф или более новая версия могут дать другие числа.
- По восемь вопросов в ячейке на маленьком и среднем репозиториях. При 13 тестах с поправкой Холма ячейка из восьми не может стать значимой, даже если граф выиграет каждый вопрос, поэтому значим только результат haiku на больших репозиториях.
- Opus ответил на двенадцать вопросов, по одному разу.
- tokenEquiv не учитывает выходные токены. С ними разрыв haiku на больших репозиториях стал бы шире: его ответы с grep там дали по медиане 7,0 тыс. выходных токенов против 0,9 тыс. с графом.
- Один запуск haiku упал до того, как Copilot открыл сессию, и исключён. Три запуска sonnet не смогли получить список моделей Copilot до первого вызова модели и были прогнаны заново. Оба случая записаны в плане.
Воспроизвести
Всё лежит в code-graph-vs-grep: план, записанный до запусков, вопросы с доказательством каждого ключа ответа, драйвер, все 664 запуска с ответами и анализ.
node bench/run-copilot.mjs --model claude-haiku-4.5 --reps 3 --out results/v2/claude-haiku-4.5.json
python3 bench/stats-v2.py results/v2/*.json