Qwen-Image-2.1 запускается в diffusers через QwenImage21Pipeline. В bfloat16 его текстовый энкодер занимает 16,3 ГБ, трансформер 13,3 ГБ и VAE 1,3 ГБ, так что загруженный пайплайн на Mac с 48 ГБ занял 31,4 ГБ, а декодирование картинки 1024 × 1024 подняло его ещё на 11 ГБ. В этом руководстве: что обычный способ сделал на этом Mac, почему model CPU offload не помог, и способ, который дошёл до конца, когда в памяти одна из двух больших моделей за раз.
Прогоны шли на Apple M5 Pro с 48 ГБ, torch 2.14.0 и diffusers 0.41.0.dev0 из main. QwenImage21Pipeline есть и в релизе diffusers 0.41.0, его я не запускал. Каждый прогон делал одну картинку 1024 × 1024 за 20 шагов с сидом 7, под сторожем памяти, который останавливал прогон, как только своп вырастал на 8 ГБ.
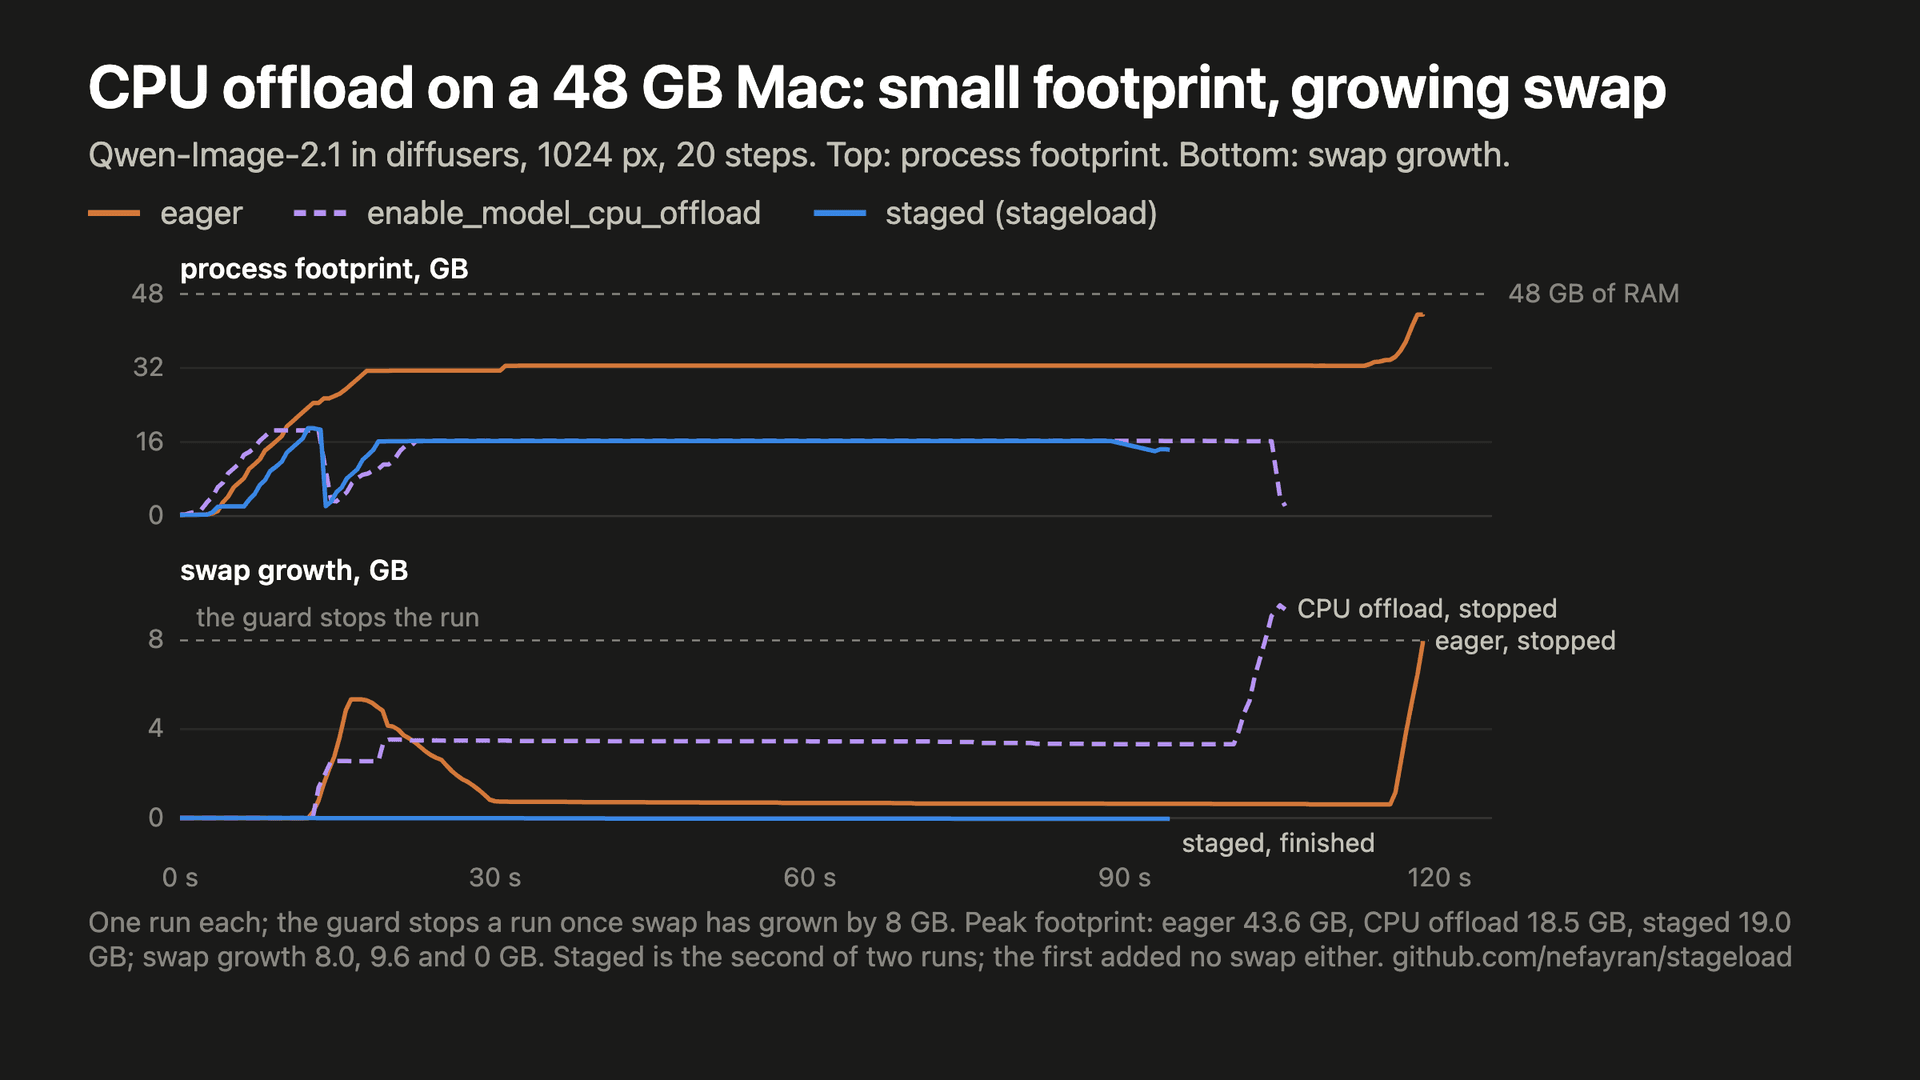
Eager уходит в своп при декодировании
Обычный код загружает все три модели на GPU и держит их там:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("mps")
image = pipe(prompt=prompt, width=1024, height=1024, num_inference_steps=20).images[0]
Он прошёл кодирование и все 20 шагов денойзинга на 31–33 ГБ. Затем декодирование VAE подняло footprint с 32,5 до 43,6 ГБ, своп вырос на 8 ГБ, и сторож остановил прогон до того, как тот записал картинку. Ошибки нехватки памяти PyTorch до этого не выдал: Mac просто ушёл в своп.
Почему model CPU offload не помогает на Mac
Для пайплайна, который не помещается в память, в diffusers встроен model CPU offload: каждая модель ждёт на CPU и переезжает на GPU только на время своей работы.
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.enable_model_cpu_offload(device="mps")
На Mac CPU и GPU делят одну память, поэтому модель, которая ждёт «на CPU», лежит в той же RAM. В единственном прогоне с offload footprint процесса ни разу не превысил 18,5 ГБ, и по этому числу всё помещается. Своп всё равно рос: на 3,5 ГБ за денойзинг и до 9,6 ГБ при декодировании VAE, и сторож остановил прогон там же, где остановил eager. Footprint, то есть число, которое Activity Monitor показывает для процесса, не считает страницы, уже ушедшие в своп, поэтому по нему этого не видно.
Загружать по одной модели на стадию
Пайплайн использует модели по очереди: текстовый энкодер только для кодирования промпта, трансформер только в цикле денойзинга, а при декодировании VAE ни одну из них. Значит, двум большим моделям не нужно быть в памяти одновременно. Это отслеживает stageload: StagedModels загружает модель, когда она впервые нужна стадии, и выгружает её, когда пайплайн входит в стадию, где этой модели нет в списке.
from stageload import StagedModels, on_call

STAGES = {"encode": ["text_encoder"], "denoise": ["transformer"], "decode": []}
models = StagedModels({"text_encoder": text_encoder, "transformer": transformer}, stages=STAGES)

on_call(pipe, "encode_prompt", before=lambda *a, **k: models.enter("encode"))
on_call(pipe, "prepare_latents", before=lambda *a, **k: models.enter("denoise"))
on_call(pipe, "_unpack_latents", before=lambda *a, **k: models.enter("decode"))
text_encoder и transformer здесь функции, которые загружают каждую модель через from_pretrained(..., subfolder=...) и переносят её на mps. Сам пайплайн собирается с text_encoder=None, transformer=None и с VAE, который остаётся загруженным. on_call вызывает models.enter(stage) прямо перед методами пайплайна, с которых начинается каждая стадия, так что код пайплайна остаётся как есть. Нужна ещё одна деталь: пайплайн читает конфиг трансформера до начала денойзинга, поэтому pipe.text_encoder и pipe.transformer заменены заглушками, которые отвечают на .config из чекпойнта и загружают модель при любом другом обращении. Весь скрипт, с заглушками и трассой памяти, лежит в bench/qwen_image.py, а библиотека ставится командой pip install stageload.
Оба прогона staged дошли до конца, за 94 и 124 с. Footprint дошёл до 19,0 ГБ при кодировании, до 16,2 и 18,6 ГБ при денойзинге в двух прогонах и до 14,4 ГБ при декодировании. Своп не вырос ни в одном прогоне, а свободная память ни разу не опускалась ниже 51 %. Загрузка двух моделей заняла около 13 с на прогон, и ещё 4–5 с ушло на выгрузку трансформера перед декодированием. Если считать от момента, когда трансформер оказался в памяти, до начала декодирования, 20 шагов заняли 70 с в одном прогоне staged, 99 с в другом и 77,5 с у eager; по трассам не видно, почему два прогона staged различаются. Оба дали одну и ту же картинку, бит в бит.
Как проверить прогон на своп
Прогон помещается, если своп не растёт, пока он идёт, что бы ни показывал footprint. Это видно по двум командам:
sysctl vm.swapusage             # compare "used" before and after the run
sysctl kern.memorystatus_level  # system-wide free memory, in percent
MemoryMeter из stageload каждые 0,5 с пишет footprint, своп и свободную память в трассу JSONL, а stageload guard запускает команду, когда для неё есть место, и останавливает её, как только своп вырастет сверх бюджета:
stageload guard --wait-free 40 --swap-budget 8G -- python generate.pyЧто я не измерял
- Тайлинг VAE.
pipe.vae.enable_tiling()декодирует картинку по тайлам, а именно на декодировании eager и offload ушли в своп. Я его не пробовал, поэтому не могу сказать, дойдёт ли с ним eager до конца на этом Mac. - Последовательный CPU offload, квантованные веса и Mac с памятью меньше или больше 48 ГБ.
- Даёт ли staged ту же картинку, что eager. Eager на этом Mac картинку так и не записал.
Подробнее замеры описаны в заметках Qwen-Image-2.1 по стадиям и Model CPU offload на Mac с 48 ГБ, а трассы лежат в репозитории stageload.