4 октября прогон Pixal3D на моём Mac дошёл до стадии текстуры, и за десять секунд процесс вырос с 27 до 44 ГБ. Доступная память упала до 6 %, а своп вырос на 12 ГБ, поэтому сторож, под которым я запускаю тяжёлые задачи, остановил процесс. Памяти в этом Mac 48 ГБ. Пока у меня не было этого сторожа, два прогона Pixal3D закончились перезагрузкой Mac, и один из них шёл параллельно с другой тяжёлой работой.
Pixal3D делает из одного изображения текстурированный 3D-меш, а Pixal3D-mac — его порт на Apple Silicon. Пайплайн 1024_cascade по очереди запускает семь моделей: flow-модель и декодер для грубой структуры, две flow-модели для формы на 512 и 1024, декодер формы, а также flow-модель и декодер для текстуры. Вокруг них работают четыре экстрактора признаков изображения, модуль удаления фона и модуль оценки камеры. Каждой стадии нужны одна или две из семи моделей, а порт держит в памяти их все, с первой секунды до последней.
Почему память не возвращается
На Apple Silicon CPU и GPU делят один пул памяти. Режим low-VRAM в Pixal3D, включённый по умолчанию, держит простаивающие модели на CPU и копирует активную на GPU. На ПК с дискретной видеокартой это экономит видеопамять. На Mac копия на CPU и копия на GPU лежат в одной и той же оперативной памяти, поэтому режим держит в памяти все модели и добавляет к ним вторую копию активной. Кроме того, четыре экстрактора признаков загружают один и тот же бэкбон DINOv3 четыре раза.
Загрузка по стадиям
Для этого я написал небольшую библиотеку stageload. Она подменяет словарь моделей пайплайна другим, который загружает модель, когда стадия впервые её запрашивает, и освобождает каждую модель, которой нет в списке следующей стадии. При освобождении каждый тензор модуля переносится на устройство meta в PyTorch. Так память тензоров освобождается, даже когда другой код ещё держит ссылку на модуль, а вызов модуля после этого выбрасывает ошибку с именем модуля и стадии, которая его освободила, вместо того чтобы упасть где-то внутри PyTorch.
Сам run() порта выполняется без изменений. stageload оборачивает четыре метода пайплайна, чтобы узнавать, где начинается каждая стадия: удаление фона, первое обусловливание по изображению, обусловливание каждого прохода формы и текстуры и финальное декодирование. Четыре экстрактора признаков создаются так, чтобы у них был один общий бэкбон.
Одна часть этой схемы ломается, не выдавая никакой ошибки. Pixal3D задаёт сид один раз в начале прогона, а потом берёт шум для каждой стадии из генератора случайных чисел на CPU. При создании модели выполняется её случайная инициализация, которая берёт числа из того же генератора. Поэтому модель, лениво созданная посреди прогона, изменила бы шум всех стадий после неё, а с ним и меш. stageload сохраняет состояние генераторов перед каждой загрузкой и восстанавливает его после: генераторы torch для CPU, MPS и CUDA, random из Python и глобальный генератор NumPy. На пайплайне-заглушке, который задаёт сид и берёт шум так же, как порт, тест проверяет, что staged- и eager-прогоны дают побитно одинаковые латенты, а контрольный тест с выключенным восстановлением видит, что они расходятся.
Не только Pixal3D
Ядро stageload ничего не знает о Pixal3D. Пайплайну нужно дать три вещи: функцию, которая создаёт каждую модель отдельно, список моделей, которые использует каждая стадия, и вызов там, где стадия начинается. В своём коде этот вызов занимает одну строку: models.enter("decode"). В чужом коде, как в этом порте, on_call вешает его на метод, который и так выполняется в этом месте, и сам пайплайн остаётся как есть. У пайплайна text-to-image та же форма, что у Pixal3D: текстовый энкодер, денойзер и декодер изображения работают друг за другом. Измеритель памяти и сторож работают с любой программой на Mac. Pixal3D пока единственный пайплайн, на котором я делал замеры; в README ядро показано на маленьком пайплайне из двух моделей, и этот пример запускается как тест.
Что это изменило
На этом M5 Pro с 48 ГБ я пропустил изображение из примеров порта через 1024_cascade с сидом 7 и текстурами 2048 пикселей, по два прогона на режим, каждый в своём процессе под сторожем. «Eager» — это то, как модели загружает сам порт, а «staged» — stageload. На этой машине eager-прогоны не проходят стадию текстуры в пределах лимитов сторожа, поэтому оба eager-прогона останавливаются там, где она начинается. Значение для текстуры в режиме eager взято из прогона 4 октября, который до неё дошёл.
| стадия | eager, пик памяти | staged, пик памяти |
|---|---|---|
| setup | 20,4 ГБ | 2,9 ГБ |
| camera | 23,2 ГБ | 6,7 ГБ |
| structure | 22,2 ГБ | 10,9 ГБ |
| shape_512 | 26,6 ГБ | от 11,4 до 11,5 ГБ |
| shape_1024 | 30,5 ГБ | 13,1 ГБ |
| texture | остановлен сторожем на 44,2 ГБ | 30,1 ГБ |
| decode | не дошёл | от 17,9 до 18,4 ГБ |
| export | не дошёл | от 69,6 до 70,2 ГБ |
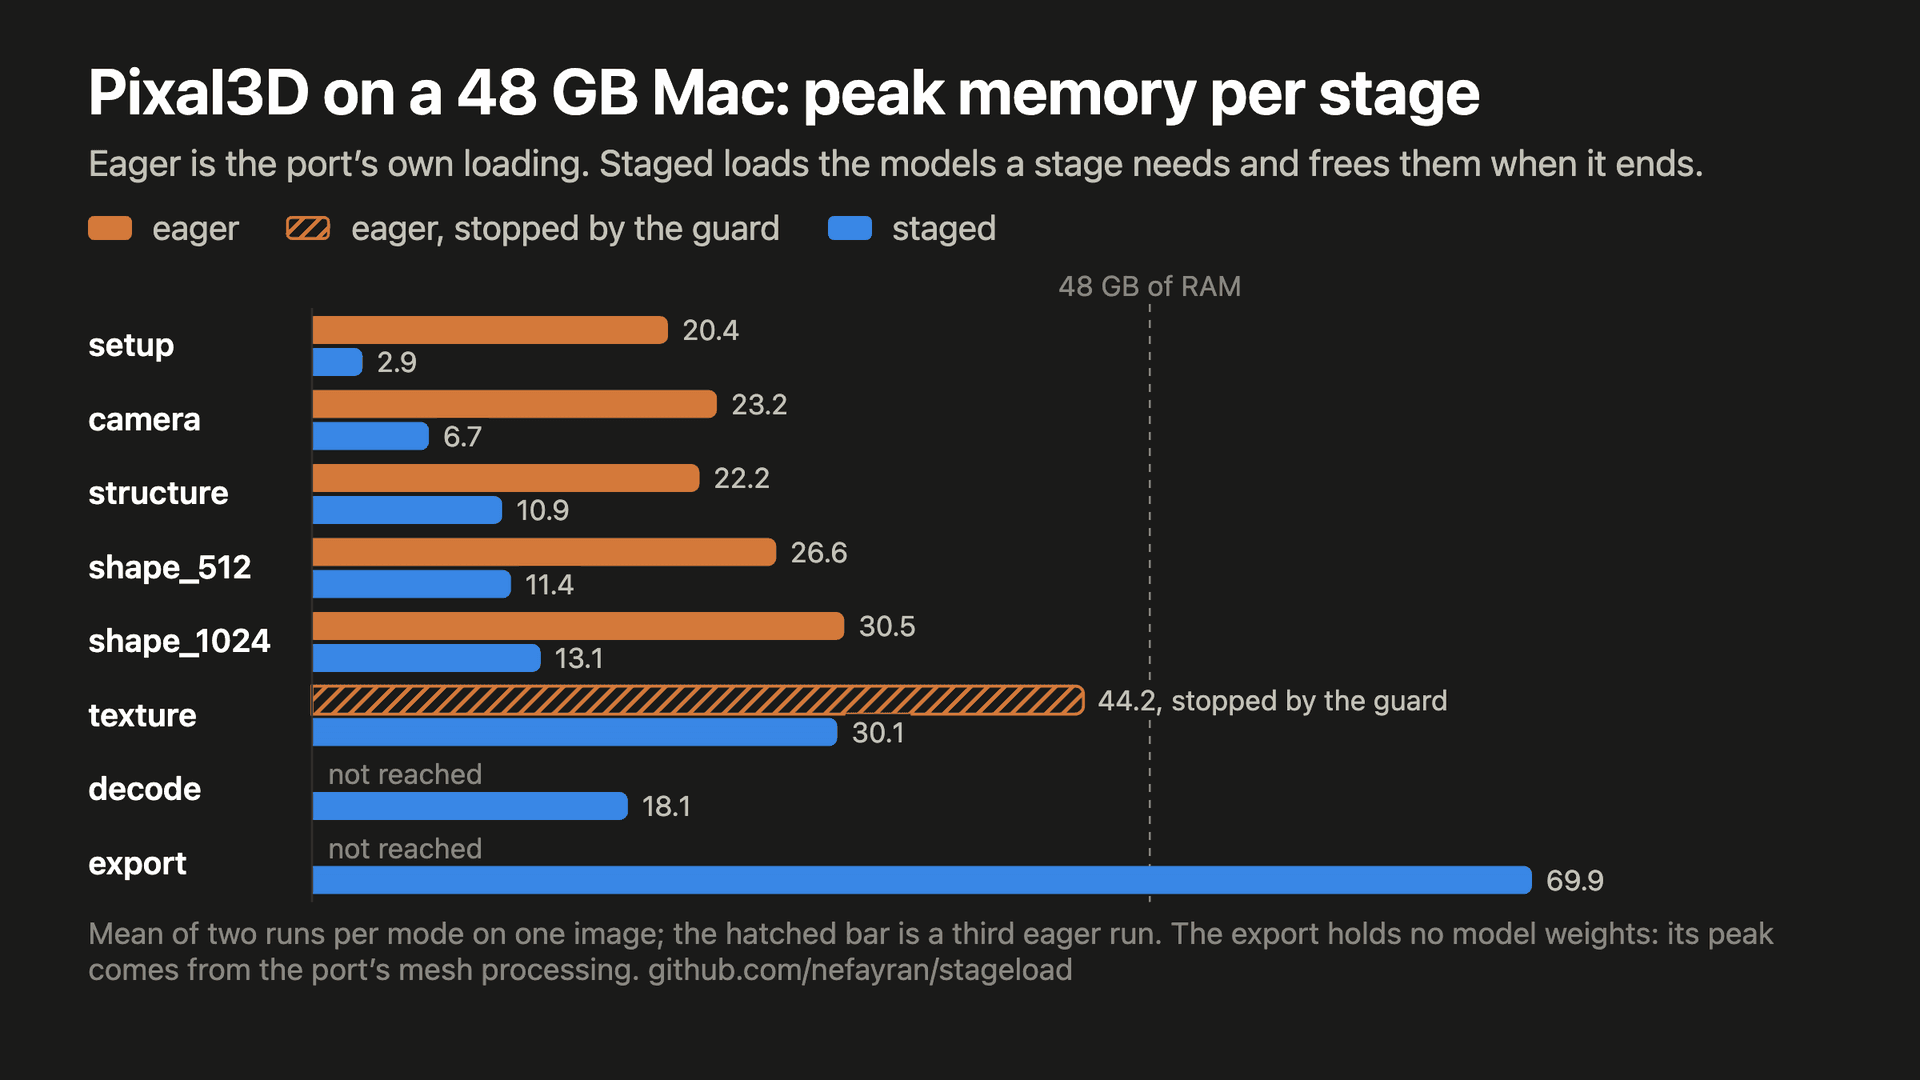
На каждой стадии, которую прошли оба режима, staged занимал на 11,3–17,5 ГБ меньше. Восемь загрузок (семь моделей плюс ещё раз декодер формы для декодирования) прочитали 13,2 ГБ за 24 с из примерно десяти минут на прогон.
Из 30 ГБ стадии текстуры большая часть приходится на рабочую память: сама модель текстуры занимает 2,6 ГБ. Когда началось декодирование, stageload освободил её вместе с экстракторами признаков и очистил кеш аллокатора MPS, и за две секунды объём памяти упал до 4,5 ГБ в одном прогоне и до 8,0 ГБ в другом.
Самое большое значение у staged, около 70 ГБ, приходится на экспорт, когда все веса моделей уже освобождены. Это обработка меша в самом порту (ремешинг, UV-развёртка, запекание), которую stageload не трогает. Объём памяти здесь — это число, которое показывает «Мониторинг системы», и в него входит память, сжатая macOS, поэтому он может быть больше 48 ГБ оперативной памяти.
Что я не смог показать
Первое: меняет ли загрузка по стадиям результат. Каждый прогон сохранял хеш и копию выхода каждого сэмплера. Первый латент, грубая структура, побитно совпадает во всех четырёх прогонах. Начиная со стадии формы на 512, порт на MPS не повторяет сам себя даже с тем же сидом: два eager-прогона расходятся между собой в латенте формы до 1,77, а staged-прогон отличается от eager-прогона на 1,24–1,86. Так что сравнение показывает, что любое изменение от загрузки по стадиям не больше собственного разброса порта, измеренного на этой единственной паре eager-прогонов. Латент текстуры и итоговый меш вообще не сравнивались, потому что eager-прогоны здесь до них никогда не доходят.
Создание моделей на CPU не помогло. stageload создаёт каждую модель сразу на GPU, и это меняет один тензор, которого нет в чекпойнте: rotary-частоты разреженного внимания, которые вычисляются при создании модели, расходятся до 6e-8. Чтобы проверить, объясняет ли это расхождения, я запустил staged-прогон, который создавал каждую модель на CPU и переносил её на GPU, как это делает порт. Его латенты отличались от eager-прогонов на 1,84 и 1,12: тот же порядок, что и у любой другой пары. Загрузка заняла 82 с вместо 24 с, три стадии дали пик на 2,6–3,8 ГБ выше, а две оказались ниже. Я вернулся к созданию моделей на GPU.
В моей собственной сводке был баг, который завысил одно число. Пик каждой стадии она считала с момента, когда стадия была записана как начавшаяся, а освобождение моделей предыдущей стадии занимает до 1,7 с. Один замер памяти в этом промежутке дал пик декодирования 29,5 ГБ в прогоне, где модели создавались на CPU; если считать от конца освобождений, он равен 16,7. Баг поймало ревью кода. Теперь окно стадии начинается, когда завершились освобождения, запущенные её началом.
Сторож
Прогоны шли через вторую часть stageload, stageload guard, потому что на этом Mac работают и другие тяжёлые задачи. Сторож запускает одну команду только тогда, когда доступно достаточно памяти и какое-то время не было видно ни одного процесса из списка тяжёлых задач. Пока команда работает, он останавливает всю её группу процессов, если своп выходит за бюджет или доступная память держится ниже 10 %. Ему не нужен root, и останавливает он только те процессы, которые запустил сам.
Ожидание тишины появилось после сбоя. Цепочка видеозадач оставляет между задачами короткие промежутки, прогон стартовал в одном из них, и следующая видеозадача за 20 с вывела своп за бюджет. На стенде каждый прогон стартовал только после трёх минут, в течение которых не было видно ни одной тяжёлой задачи.
На другом изображении
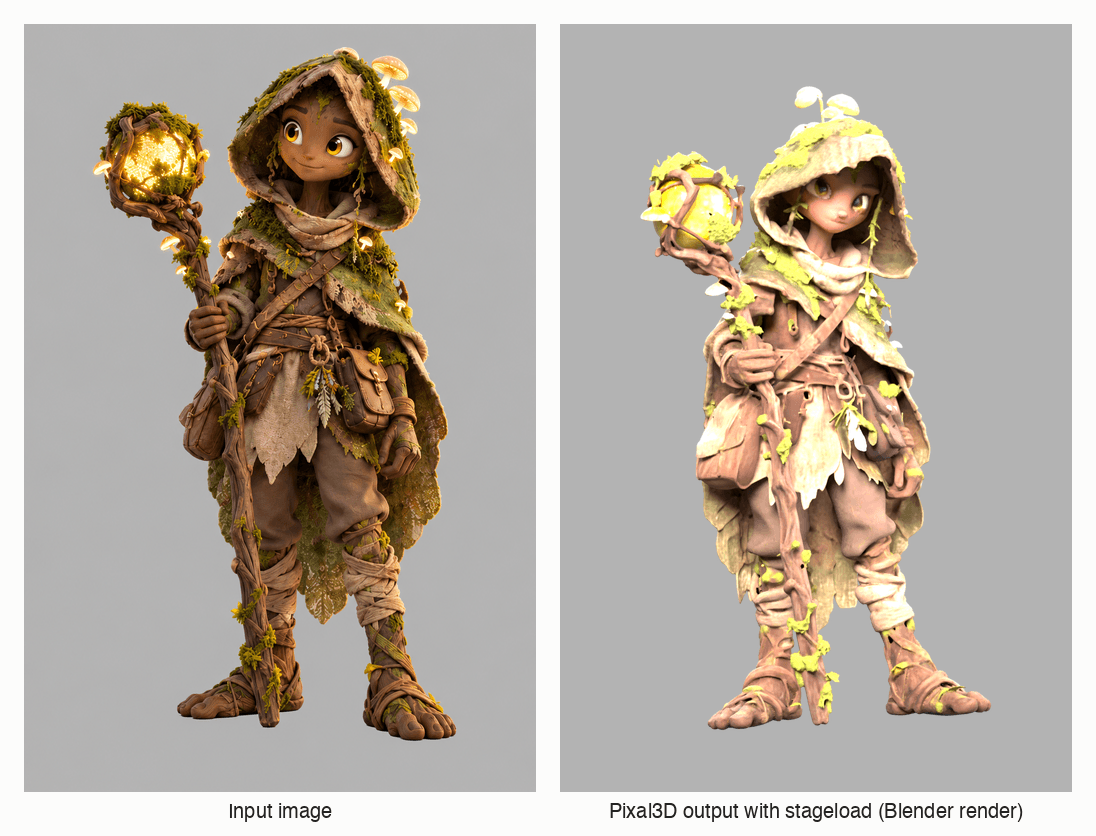
Такой же staged-прогон на персонаже из игры, которую я делаю, занял 416 с и загрузил те же 13,2 ГБ за 37 с. Пик его стадии текстуры составил 30,1 ГБ, как и на изображении из примеров. Вот входное изображение и меш, который выдал прогон, в рендере Blender:
Код, трейсы каждого прогона и скрипты, которые нарисовали эти графики, лежат в репозитории. Адаптер для Pixal3D проверен на одном коммите Pixal3D-mac.