前回のベンチマークの結論は、コードグラフを使ってもコーディングエージェントは安くならなかった、というものだった。ただ、それ以上のことを言うには規模が小さすぎた。質問は 24 問、グラフのノード数が 25k を超えるリポジトリはなく、Opus も使っていない。そこで、答えが変わりうる規模でもう一度実行することにし、先に計画を書き出した。仮説、リポジトリ、予算、分析方法は PLAN-v2.md にあり、どの実行よりも前にコミットしてある。
手短に言うと、グラフが割に合うのは、それがなければモデルが検索を続けてしまう場合だ。kubernetes と vscode での haiku がまさにそれに当たる。同じリポジトリで sonnet が節約できるのはわずかで、opus はまったく節約できない。そして小さなリポジトリでは、sonnet にとってグラフは素の grep より高くつく。
設定
エージェントには GitHub Copilot CLI 1.0.90 を使い、ヘッドレスで、一セッションにつき一問ずつ実行した。条件は次の二つ。
- grep 条件:Copilot の view、grep、glob ツールだけで、ほかには何もない。
- グラフ条件:同じ三つのツールに加えて、cbm-lean(codebase-memory-mcp 0.9.0 を包む私の薄いラッパー)と、プロンプト冒頭の振り分けルール。呼び出し元、呼び出し先、呼び出しチェーンにはグラフを、正確な文字列には grep を使う。
公開リポジトリは四つで、それぞれ特定のコミットに固定した。
| リポジトリ | 言語 | グラフのノード数 |
|---|---|---|
| full-stack-fastapi-template | Python、TypeScript | 1,601 |
| dub | TypeScript | 25,023 |
| kubernetes | Go | 146,421 |
| vscode | TypeScript | 218,883 |
各リポジトリの質問は 16 問。八つは構造に関するもので、ある関数を誰が呼ぶか、その関数が何を呼ぶか、CLI コマンドや HTTP ハンドラから名前を挙げた関数までの呼び出し経路、そしてシグネチャを変えたらどの関数が壊れるか。残りの八つは正確さを問うもので、設定値、環境変数が読まれる場所、エラーが送出される行、型が定義されている行。正解はすべて、固定したコミットの時点で私が手作業で確認した。正解の各項目は単語全体として一致したときだけ数えるので、init のところで init_db と答えても通らない。
Haiku 4.5 は全 64 問に各条件で三回ずつ、sonnet 5 は二回ずつ答えた。Opus 5.5 は Copilot ではプロンプト一つにつきプレミアムリクエスト 15 回分かかるので、kubernetes と vscode の構造に関する質問のうち十二問に一回ずつ答えた。合計で実行は 664 回、プレミアムリクエストは約 744 回分になる。
コストは前回の記事と同じく tokenEquiv で測る。キャッシュされない入力、プラス 1.25 × キャッシュ書き込み、プラス 0.1 × キャッシュ読み込みを、実行ごとにすべてのモデル呼び出しについて合計したものだ。
結果
grep のコストに対するグラフのコストの比。質問ごとに、繰り返し全体でのグラフ条件の中央値を grep 条件の中央値で割り、さらに質問全体で中央値をとった。95% ブートストラップ区間を添えている。1 未満ならグラフのほうが安い。
| モデル | リポジトリの規模 | 構造に関する質問 | 正確さを問う質問 |
|---|---|---|---|
| haiku 4.5 | 小規模(1.6k ノード) | 0.88 (0.65–1.29) | 0.92 (0.72–1.15) |
| haiku 4.5 | 中規模(25k) | 0.61 (0.11–1.50) | 0.96 (0.75–1.37) |
| haiku 4.5 | 大規模(146k、219k) | 0.29 (0.11–0.70) | 1.01 (0.94–1.28) |
| sonnet 5 | 小規模 | 1.51 (1.45–1.70) | 1.42 (1.20–1.71) |
| sonnet 5 | 中規模 | 0.94 (0.57–2.00) | 1.14 (1.05–1.30) |
| sonnet 5 | 大規模 | 0.74 (0.62–0.92) | 1.13 (1.01–1.29) |
| opus 5.5 | 大規模 | 0.97 (0.72–1.10) | – |
構造に関する質問の正解数(グラフ対 grep)。
| モデル | 小規模 | 中規模 | 大規模 |
|---|---|---|---|
| haiku 4.5 | 13/24 対 19/24 | 20/24 対 22/24 | 38/47 対 33/48 |
| sonnet 5 | 13/16 対 15/16 | 16/16 対 16/16 | 32/32 対 28/32 |
| opus 5.5 | – | – | 12/12 対 12/12 |
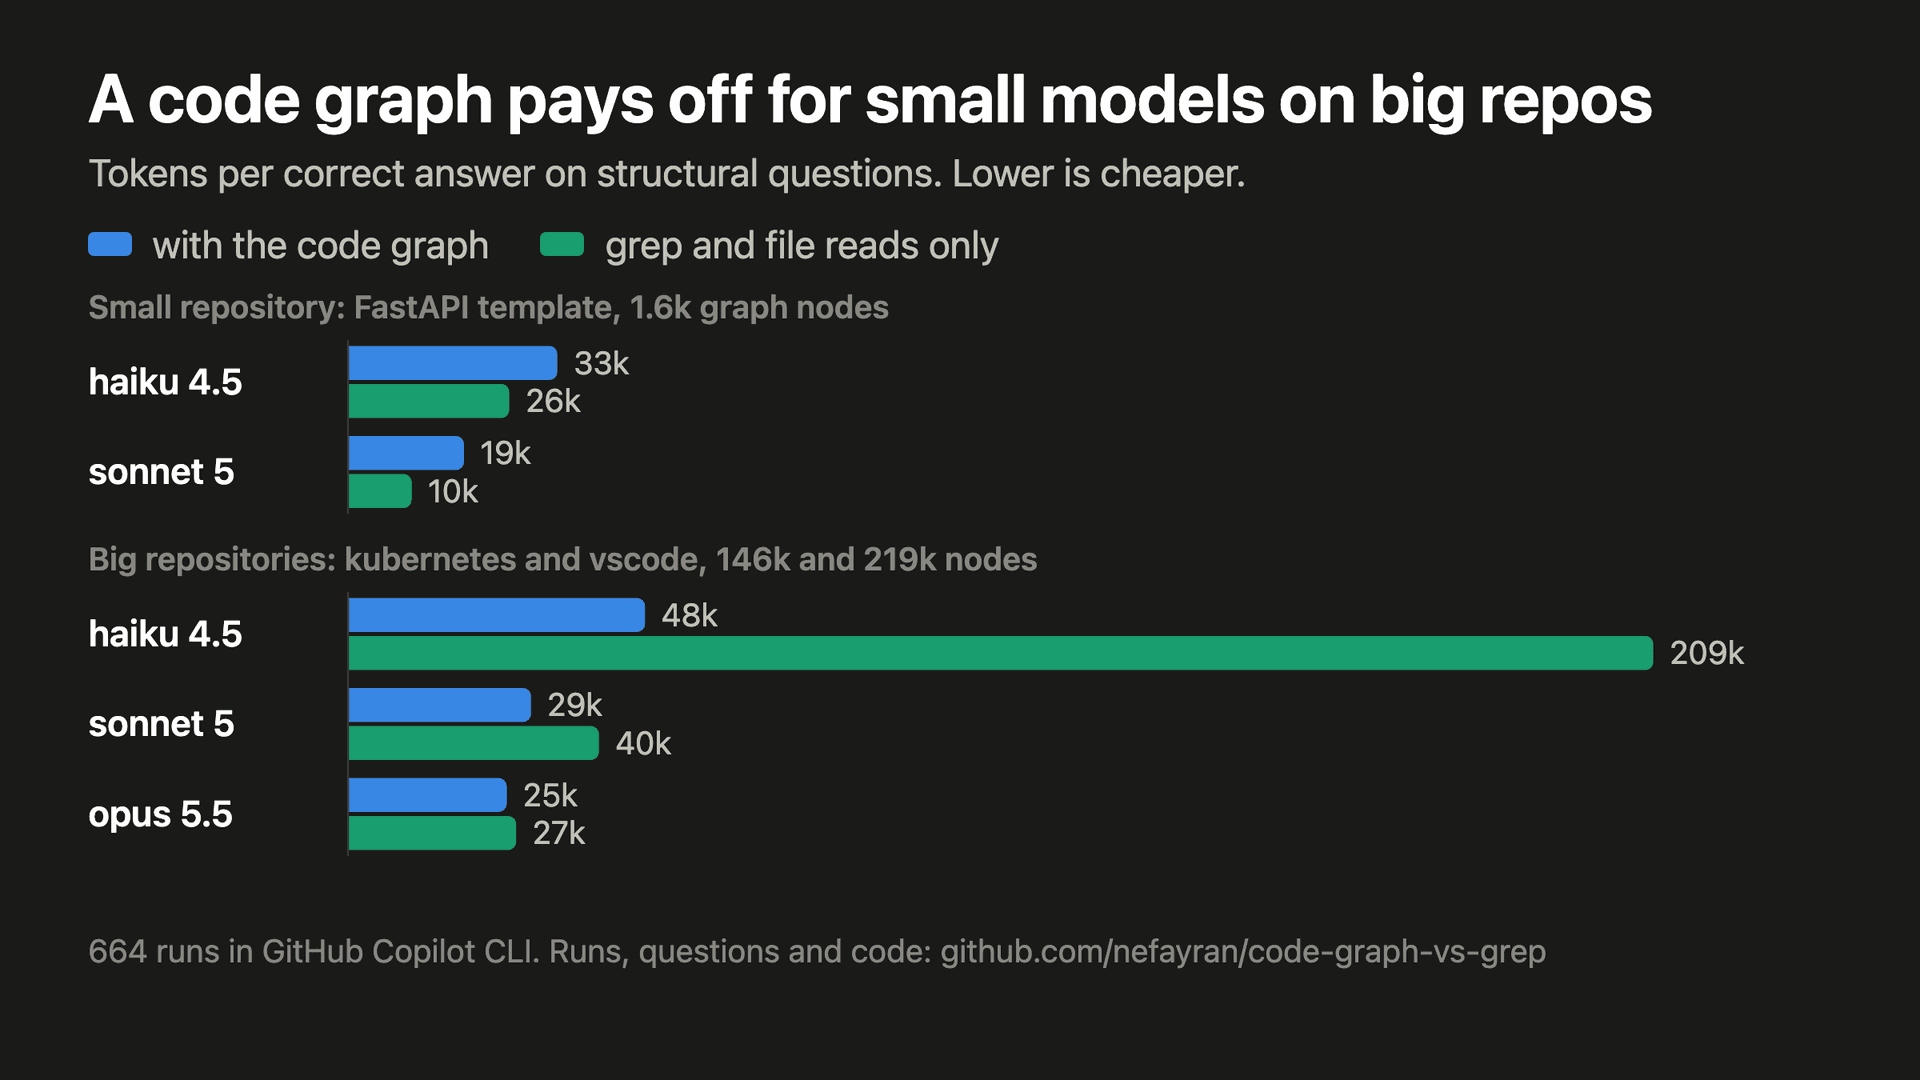
コストと正確さを合わせて見た、構造に関する質問での正解一件あたりの tokenEquiv。
揺るがない結果は次のとおり。
- kubernetes と vscode の構造に関する質問では、グラフありの haiku のコストは grep のときの 0.29 で、16 問中 15 問でグラフのほうが安かった。正解も多かったので、正解一件あたりでは 47k 対 209k tokenEquiv という差になる。13 の検定に Holm 補正をかけても残るのは、この結果だけだ(p = 0.006)。
- 同じ質問での sonnet は 0.74 で、16 問中 12 問で安く、正解は 32 問中 32 問(grep では 32 問中 28 問)。Opus は 0.97 で、12 問中 7 問で安く、どちらの条件でも全問正解だった。
- 小さなリポジトリでは、グラフが割に合うことは一度もなかった。haiku のコストはほぼ同じで、構造に関する質問を間違えることが増えた。Sonnet は 42〜51% 多く費やした。
- 正確さを問う質問では、haiku にとってグラフは測定可能な差を生まず、sonnet はグラフのために 13〜42% 多く払った。
- グラフのツールスキーマと振り分けルールは、リポジトリの規模にかかわらず、すべてのモデル呼び出しに一定のプロンプトトークンを上乗せする。haiku で 1.56k、sonnet と opus で 2.07k だ。
なぜ小さなモデルがいちばん得をするのか
モデル呼び出しの回数を数えてみる。grep では、haiku が構造に関する質問一問に答えるのに要した呼び出しは、中央値で kubernetes が 22 回、vscode が 20 回で、影響範囲を問う質問の一つでは 114 回かかった。グラフありでは 5 回と 4 回だった。呼び出しのたびに会話全体が送り直されるので、長い検索のコストは呼び出し回数から想像するよりはるかに大きい。grep での haiku の答えで最も高くついたものは 471k tokenEquiv に達した。
Sonnet の grep での検索はもっと短く、呼び出しは 8 回、グラフありでは 4 回だった。Opus はどちらの条件でも 4 回か 5 回だったので、グラフが削れるものはなく、わずかな節約も固定のオーバーヘッドに食われた。
これは直接は検証していない私の推測だが、グラフは検索のターンを置き換えるものなので、それがなければモデルが多くのターンを費やす場合、つまりより弱いモデルがより大きなリポジトリを扱う場合に割に合う。強いモデルは grep だけでもすでに効率よく検索するし、小さなリポジトリでは誰も多くのターンを必要としない。
Copilot はプレミアムリクエストを、呼び出し回数にかかわらずプロンプト単位で課金するので、Copilot の中ではグラフを使ってもお金は節約できない。節約できるのは時間だ。大きなリポジトリでの haiku の構造に関する質問への回答には、中央値でグラフありが 71 秒、grep では 157 秒かかった。小さなリポジトリでは、グラフ条件のほうが遅かった。
それぞれの条件がどこで間違えたか
linesというフィールド。HorizontalControllerが何行目で定義されているかを問われると、グラフ条件は haiku でも sonnet でも、五回の実行すべてで horizontal.go:43 と答えた。この構造体は 93 行目から始まり、長さは 43 行だ。codebase-memory-mcp が返すスニペットには"start_line": 93、"end_line": 135、"lines": 43が含まれていて、モデルは最後のものを行番号として読んだ。同じことがLemonSqueezyClientでも起き(59 行目にある長さ 129 行のクラスに対して client.ts:129)、haiku はCursorsControllerでも同じ間違いをした。前回の記事では、この client.ts:129 を「グラフから取った行番号」のせいにしたが、出どころはここだった。grep を使った sonnet は三つとも正解した。cbm-lean は現在、このフィールドをline_countという名前で渡している。- 鵜呑みにされたグラフの穴。codebase-memory-mcp 0.9.0 は、
from x import yでインポートした関数を名前だけで呼び出した場合、呼び出しエッジを記録しない。recover_passwordが何を呼ぶかを問われると、グラフ条件は haiku でも sonnet でも、五回の実行すべてで「get_user_by_email だけ」と答えた。グラフからそのまま答え、grep は一度も使っていない。この関数はgenerate_password_reset_token、generate_reset_password_email、send_emailも呼んでおり、grep 条件は毎回四つすべてを見つけた。 - 抜けたダッシュ。Copilot の grep ツールは
"-n": trueを受け取ったときにだけ行番号を表示し、view ツールは行番号なしでファイルを返す。Sonnet は 571 回の grep 呼び出しのうち 508 回で-nを渡し、opus は 53 回すべてで渡した。haiku は 1,949 回のうち、ダッシュのないnを 920 回、-nを 22 回渡した。ツールは未知のキーを無視するので、haiku には行番号が返らず、view で開いたファイルの行を自分で数えて数行ずれた。112 行目で送出されるエラーに対する答えは 105, 107, 108 と 113 だった。正確さを問う質問への haiku の誤答 79 件は、一件を除いてすべて行番号の間違いだ。 - 長く探しても失敗する検索。
kubeadm token createからencodeTokenSecretDataまでの呼び出しチェーンで、grep を使った haiku は 18〜22 回の呼び出しをかけ、三回とも経路を間違えた。グラフありでも間違えた。Sonnet はどちらの条件でも正解した。 - haiku は grep 条件で bash を三回呼び出そうとした。その条件には bash ツールが存在しないので Copilot が拒否しており、自分の条件にないツールを使った実行は一つもない。
前回の記事から変わったこと
前回の記事では、ノード数 25k までのリポジトリで Claude のモデルを使うなら、グラフによるトークン節約は期待しないこと、と書いた。その規模では、これは今も変わらない。見落としていたのは、それより大きな規模で何が起きるかだ。kubernetes と vscode では小さめのモデルが得をし、モデルが小さいほど得るものも大きい。
グラフをエージェントにつなごうとしているチームに伝えたいこと
- まず、いちばん大きなリポジトリで、いちばん安いモデルを使って測ること。グラフが役に立つのはそこだ。
- 強いモデルで小規模か中規模のリポジトリを扱うなら、グラフはつながないこと。呼び出しのたびにスキーマの分を払うだけで、見返りは何もない。
- 正確さを問う質問は、これからも grep に振り分けること。そこでグラフが勝ったことは一度もない。
- グラフの出力にある行番号や「これで全部」という答えを、モデルに鵜呑みにさせないこと。
linesのようなフィールドは、モデルに届く前に削るか名前を変えること。
限界
- エージェントのハーネスは一つ(Copilot CLI)、グラフも一つ(私のラッパー越しの codebase-memory-mcp 0.9.0)だけ。Claude Code やほかのグラフ、あるいは新しいバージョンでは、違う数字が出るかもしれない。
- 小規模・中規模のリポジトリでは、セルあたりの質問は八つ。Holm 補正のもとで 13 の検定を行うと、八問のセルは、グラフがすべての質問で勝っても有意にはならない。そのため、有意なのは大きなリポジトリでの haiku の結果だけだ。
- Opus が答えたのは十二問で、それぞれ一回ずつだ。
- tokenEquiv には出力トークンが含まれない。出力トークンも数えれば、大きなリポジトリでの haiku の差はさらに開く。そこでの grep の答えは、出力トークンの中央値が 7.0k で、グラフありでは 0.9k だった。
- haiku の実行のうち一回は、Copilot がセッションを開く前に失敗したので除外した。sonnet の実行のうち三回は、最初のモデル呼び出しより前に Copilot のモデル一覧の取得に失敗したので、やり直した。どちらも計画書に記録してある。
再現
すべて code-graph-vs-grep にある。実行前に書いた計画書、すべての正解の根拠を添えた質問、ドライバ、664 回の実行すべてとその答え、そして分析だ。
node bench/run-copilot.mjs --model claude-haiku-4.5 --reps 3 --out results/v2/claude-haiku-4.5.json
python3 bench/stats-v2.py results/v2/*.json